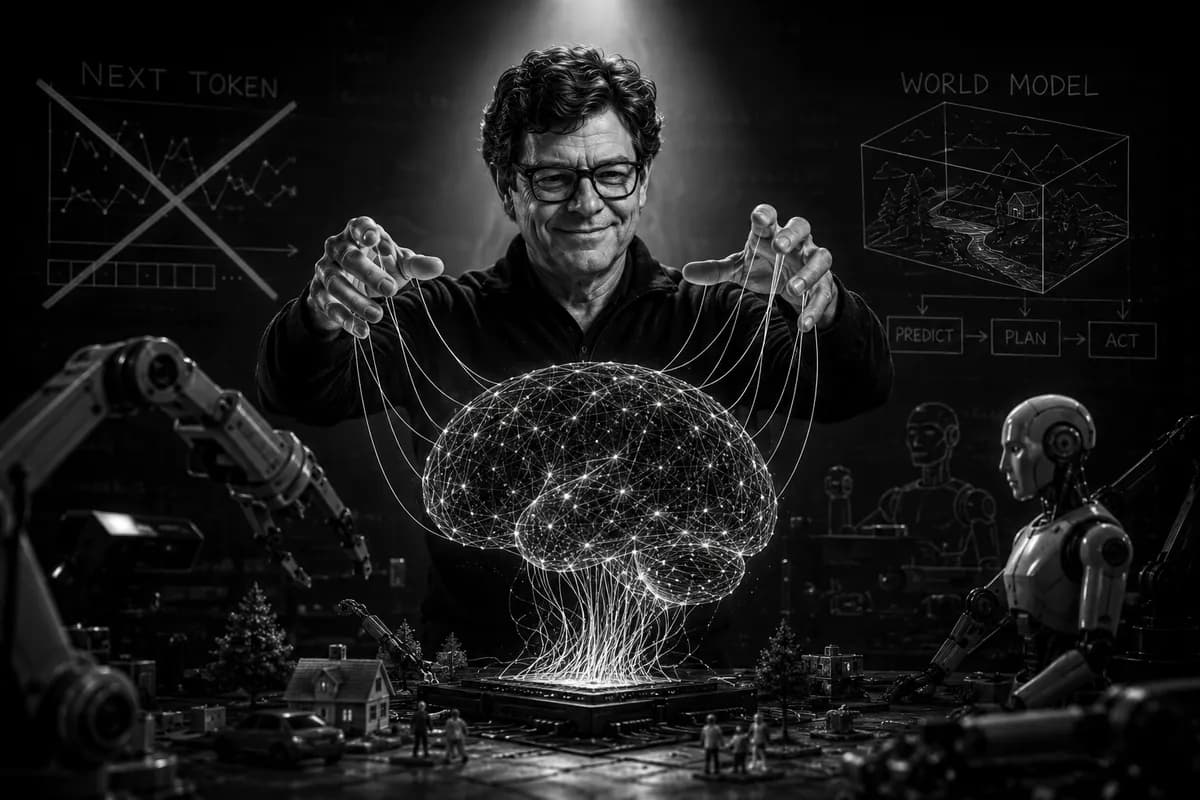
۱.۰۳ میلیارد دلار؛ این رقم، ابعاد بزرگترین دور سرمایهگذاری اولیه (Seed Round) در تاریخ اروپا است که در مارس ۲۰۲۶ توسط AMI Labs نهایی شد. تصور کنید آزمایشگاهی بدون هیچ محصول تجاری در دست، بتواند چنین مبلغی را جذب کند؛ این اتفاق زمانی رخ میدهد که رهبری شرکت بر عهده الکساندر لبرون و ریاست هیئت مدیره آن با یان لکان (Yann LeCun)، برنده جایزه تورینگ و دانشمند ارشد سابق هوش مصنوعی در متا باشد. این دو با همکاری یکدیگر شرطبندی کردهاند که عصر بعدی هوش مصنوعی، از پیشبینی متن فراتر رفته و به سمت ساخت «مدلهای جهانی» (World Models) حرکت خواهد کرد؛ مدلهایی که قادرند قوانین فیزیکی واقعیت ما را درک کنند.
اندکی پس از جذب سرمایه، لبرون در گفتگو با تککرانچ (TechCrunch) اظهار داشت که «مدلهای جهانی» به واژه پرزرقوبرق (Buzzword) بعدی تبدیل خواهند شد و پیشبینی کرد که طی شش ماه آینده، هر شرکتی برای جذب سرمایه از این برچسب استفاده خواهد کرد. او دقیقاً طبق برنامه پیشبینی کرد: از آن زمان تاکنون، سرمایهگذاران مخاطرهپذیر حدود ۳ میلیارد دلار در این دستهبندی تزریق کردهاند. اکنون پرسش مرکزی این است که آیا در پس این برچسب، یک اختلاف نظر معماری واقعی و قابل تست وجود دارد، یا اینکه این اصطلاح صرفاً یک عبارت توخالی برای اهداف بازاریابی است.
این چرخش در حالی رخ میدهد که صنعت با سقف تواناییهای مدلهای زبانی بزرگ (LLM) — که بر پایه معماری خودبازگشتی (Autoregressive) هستند — مواجه شده است. همانطور که در تحلیل قبلی ما دربارهی مدلهای جهانی برای زیرساختها اشاره کردیم، اکنون صنعت به دو گروه تقسیم شده است: کسانی که معتقدند LLMها میتوانند به صورت تکاملی به مدلهای جهانی تبدیل شوند و کسانی که باور دارند به یک معماری بنیاداً متفاوت نیاز است. این تمایل به تخصصی کردن مدلها برای کاربردهای پیچیده، مشابه رویکردی است که در تلاشهای آنتروپیک برای توسعه مدلهای پژوهشی علمی مشاهده میکنیم؛ جایی که هدف، عبور از مدلهای عمومی به سمت ابزارهایی با دقت تخصصی است. از نظر لکان، شکاف فعلی یک مشکل عملکردی ساده نیست، بلکه یک شکست فلسفی در مکانیسم پیشبینی توکن است.

استدلال علیه LLMها
نقد لکان به LLMها سالها پیش از موج فعلی آغاز شد. او استدلال میکند که این مدلها اساساً قادر به استدلال واقعی نیستند، زیرا متن را تنها تکه کوچکی از واقعیت میبینند. طبق گزارش dev.to، لکان مدعی است یک کودک چهارساله از طریق بینایی، دادههای حسی بسیار بیشتری نسبت به کل مجموعههای متنی موجود پردازش میکند. متن جهان را توصیف میکند، اما دینامیکهای آن را در خود ندارد.
لکان چهار نقص کلیدی و مؤلفه گمشده در LLMهای فعلی میبیند:
- درک جهان فیزیکی
- حافظه پایدار (Persistent Memory)
- استدلال (Reasoning)
- برنامهریزی (Planning)
استدلال فنی او بر محور «خودبازگشتی» میچرخد. در یک سیستم خودبازگشتی، هر توکن تولید شده بر اساس توکنهای قبلی شرطی میشود که خودشان احتمالاً غلط بودهاند و این امر باعث انباشت خطاها (Compounding Errors) میشود. این روش برای تولید نثر و متون ادبی مناسب است، اما برای برنامههای بلندمدت فاجعهبار است؛ چرا که یک اشتباه کوچک در ابتدای مسیر، هر آنچه در ادامه میآید را باطل میکند. او برای توصیف این موضوع از مثال «سقوط یک قلم» استفاده میکند: سیستمی که محتملترین توکن بعدی را در فضای سطحی پیشبینی میکند، محاسباتی کاملاً متفاوت از سیستمی انجام میدهد که بر اساس توزیع نتایج فیزیکی استدلال میکند.
دیدگاه لبرون با تجربه او در شرکت نابلا (Nabla)، یک شرکت هوش مصنوعی پزشکی، تقویت شده است. در حوزه سلامت، توهم (Hallucination) صرفاً یک باگ در تجربه کاربر نیست، بلکه یک ریسک حیاتی و مسئولیتی حقوقی است. لکان در نمایشگاه VivaTech امسال صراحتاً بیان کرد که چتباتهای فعلی، جهان فیزیکی را بدتر از یک موش میفهمند. AMI با رویکردی سنجیدهتر در چارچوب سازمانی خود بیان میکند که پیشبینی توکن تنها تقلیدی از هوش است و مدلسازی جهان را انجام نمیدهد؛ بنابرین، این معماری فقط برای کارهای گسسته و کمبعد مانند بازیابی اطلاعات، خلاصهسازی و کدنویسی مناسب است.
سه مسیر برای ساخت «مدل جهانی»
با تبدیل شدن این اصطلاح به ابزاری برای جذب سرمایه در فضای VC، میدان به سه مسیر فنی متمایز تقسیم شده است. این مسیرها قابل جایگزینی نیستند؛ زیرا در آنچه پیشبینی میکنند، نحوه ارزیابی و هدف نهایی با هم تفاوت دارند:
- پیشبینی ویدئویی مولد (Generative Video Prediction): این مدلها فریمهای آینده را بر اساس اقدامات (Actions) پیشبینی میکنند.
- Genie 3 گوگل دیپمایند میتواند دنیاهای سهبعدی قابل پیمایش را با نرخ ۲۴ فریم بر ثانیه تولید کند.
- Cosmos انویدیا که در CES 2025 عرضه شد، با حدود ۲۰ میلیون ساعت ویدئو آموزش دیده تا دادههای مصنوعی برای رباتیک و خودروهای خودران تولید کند و بیش از ۲ میلیون بار دانلود شده است.
- GWM-1 شرکت Runway روی ویدئوهای تعاملی شرط بسته تا تخیل مدل را به معنای واقعی کلمه قابل مشاهده کند.
- بازنمایی صریح سهبعدی (Explicit 3D Representation): شرکت World Labs به بنیادگذاری فی-فی لی، جهان را نه به شکل توالی فریم، بلکه به عنوان یک شیء مکانی میبیند. سامانه Marble آنها که در نوامبر ۲۰۲۵ عرضه شد، محیطهای سهبعدی را بر بستر Gaussian splats و موتورهای فیزیکی تولید میکند که در VR قابل مشاهده هستند.
- پیشبینی فضای نهان (Latent-Space Prediction - JEPA): این شرطبندی اصلی AMI Labs است. معماری پیشبینی مشترک جایگذاری (JEPA) جزئیات سطح پیکسل را کاملاً نادیده میگیرد. این مدل مشاهدات را به بازنماییهای انتزاعی کدگذاری کرده و پیشبینی میکند که این بازنماییها چگونه تکامل مییابند. ادعای آنها این است که اکثر جزئیات پیکسلی برای برنامهریزی بیارزش هستند و پیشبینی آنها باعث اتلاف توان محاسباتی و ظرفیت مدل میشود.
ردپای فنی JEPA
عملاً AMI Labs تجسد شرکتشدهی مقاله پژوهشی ۲۰۲۲ لکان با عنوان «راهی به سوی هوش ماشینی خودمختار» (A Path Towards Autonomous Machine Intelligence) است. آن مقاله یک عامل مادولار شامل ادراک، مدل جهانی، هزینه (Cost)، یک کنشگر (Actor)، حافظه کوتاهمدت و یک پیکربند (Configurator) را تعریف کرد که JEPA زیربنای یادگیری آن بود. پیشرفت فنی این مسیر از تصاویر به رباتیک پیچیده رسید:
- I-JEPA (۲۰۲۳): این مدل تصویر-محور، بلوکهایی از یک تصویر را ماسک کرده و بازنماییهای مناطق ماسکشده را از روی بافت قابل مشاهده پیشبینی میکند. متا گزارش داد که آموزش یک مدل ViT-Huge در کمتر از ۷۲ ساعت روی ۱۶ عدد A100 انجام شد که کسری از هزینه روشهای بازسازی پیکسلی است و نتایج Probe خطی قدرتمندی داشت.
- V-JEPA (۲۰۲۴): همین ترفند را روی ویدئوها از طریق پیشبینی نهانی ماسکشده روی قطعات زمانی-مکانی اجرا کرد. بازنماییهای این مدل، حرکت را بهطور غیرمنتظرهای خوب کدگذاری کردند؛ حوزهای که مدلهای بازسازی پیکسلی معمولاً در آن شکست میخورند.
- V-JEPA 2 (۲۰۲۵): نتیجه کلیدی فعلی است. این انکودر ViT-g با ۱ میلیارد پارامتر روی ۲۲ میلیون ویدئو (بیش از ۱ میلیون ساعت) آموزش دید. این مدل به دقت ۷۷.۳٪ در Top-1 برای مجموعه Something-Something v2 (درک حرکت) و ۳۹.۷٪ در Recall@5 برای پیشبینی اقدام در Epic-Kitchens-100 رسید که ۴۴٪ بهبود نسبی نسبت به مدلهای تخصصی قبلی است. وقتی با یک مدل زبانی ۸ میلیارد پارامتری تراز شد، در PerceptionTest به امتیاز ۸۴.۰ و در TempCompass به ۷۶.۹ رسید و رکورد جدیدی (SOTA) برای این مقیاس ثبت کرد.
تکاندهندهترین نتیجه مربوط به V-JEPA 2-AC بود. با استفاده از انکودر منجمد (Frozen) و آموزش یک پیشبین شرطیشده با اقدام (Action-Conditioned Predictor) در کمتر از ۶۲ ساعت روی ویدئوهای بدون برچسب رباتیک از مجموعه داده باز DROID، این مدل بهصورت Zero-shot در دو آزمایشگاه که هرگز ندیده بود، روی بازوهای رباتیک Franka مستقر شد. برنامهریزی در اینجا به صورت کنترل پیشبین مدل (MPC) در فضای نهان اجرا میشود. نتایج نشان داد که این مدل در جابجایی اشیاء ناشناس به موفقیت ۶۵ تا ۸۰ درصدی رسید؛ بدون نیاز به پاداشها (Rewards)، دادههای تخصصی برای هر تسک، یا دادههای مربوط به رباتهای مستقر شده. زمان برنامهریزی حدود ۱۶ ثانیه برای هر اقدام بود، در حالی که در مدل پایه Cosmos این زمان حدود ۴ دقیقه بود. در تسک جابجایی لیوان، موفقیت آن به ۸۰٪ رسید، در حالی که مدل پایه vision-language-action یعنی Octo تنها ۱۵٪ موفق بود.
متا همچنین بنچمارکهای استدلال فیزیکی از جمله IntPhys 2، MVPBench و CausalVQA را منتشر کرد. مدلهای فعلی، از جمله LLMها، هنوز در این بنچمارکها بهشدت از انسانها عقب هستند؛ و همین شکاف، هستهی اصلی تبلیغات و پیشنهاد AMI است.
پول و سختافزار
سرمایه AMI توسط Bezos Expeditions، Cathay Innovation، Greycroft، Hiro Capital و HV Capital تأمین شد. سایر شرکتکنندگان شامل NVIDIA، Temasek، Samsung، Toyota Ventures و افرادی چون جف بزوس، مارک کیوبن، اریک اشمیت و تیم برنرز-لی بودند. آنها در ابتدا به دنبال ۵۰۰ میلیون یورو بودند اما در نهایت حدود ۸۹۰ میلیون یورو جذب کردند.
اگر نگاه کلی کنیم، الگویی تکرار میشود. World Labs در فوریه یک میلیارد دلار با ارزش پس از سرمایهگذاری ۵.۴ میلیارد دلار جذب کرد. Decart در ماه می ۳۰۰ میلیون دلار با ارزش ۴ میلیارد دلار گرفت (با حضور آندری کارپاتی به عنوان سرمایهگذار فرشته) و Odyssey ۱.۲ میلیارد دلار جذب کرد. انویدیا تقریباً در تمام لیست سهامداران حضور دارد و در سال ۲۰۲۶ بیش از ۴۰ میلیارد دلار سرمایهگذاری در سهام AI انجام داده است که اغلب به صورت سهام در ازای تعهدات بلندمدت برای تأمین GPU است. این نشان میدهد که مدلهای جهانی بهشدت تشنه محاسبات (Compute) هستند و حضور همهجایهی انویدیا گواهی بر نیاز عظیم به منابع است، نه لزوماً گواهی بر درست بودن این معماری.
تئوری متقابل
منتقدان استدلال میکنند که LLMها ممکن است همین حالا هم مدلهای جهانی داخلی بسازند. پژوهش روی Othello-GPT نشان داد که ترنسفورمرهای آموزشدیده تنها روی توالی حرکتها، یک بازنمایی نوظهور و قابل بررسی از وضعیت صفحه بازی ایجاد کردند که نیل ناندا بعداً نشان داد بهصورت خطی قابل رمزگشایی (Decodable) است. به همین ترتیب، گورنی و تگمارک بازنماییهای خطی از مکان و زمان را در Llama-2 یافتند که شامل «نورونهای مکانی» مجزا بود.
با این حال، استدلالهای متقابل قوی علیه تئوری «مدل جهانی نوظهور» وجود دارد:
۱. میانبرها در برابر الگوریتمها (Heuristics vs. Algorithms): کارهای تکمیلی در زمینه تفسیرپذیری نشان میدهد که «صفحه» در Othello-GPT ممکن است مجموعهای از میانبرهای آماری مرتبط (Epicycles) باشد، نه یک الگوریتم تمیز و دقیق (Orrery).
۲. قابلیت بررسی (Inspectability): در مدلهای جهانی مولد، شما میتوانید «تخیل» مدل را تماشا کنید و ببینید کجا میشکند. اما اشتباهات JEPA در فضای نهان رخ میدهند؛ ارزیابی آنها غیرمستقیم است و به Probeها و برنامهریزیهای پاییندستی متکی است. این موضوع هزینهی ابزاری و عیبیابی (Debuggability) را بهشدت افزایش میدهد.
۳. شکاف استواری (Robustness Gap): هنوز هیچ مدل جهانی واقعاً استوار (Robust) نیست. Genie 3 تنها برای چند دقیقه منسجم میماند و تغییرات را برای حدود یک دقیقه به یاد میآورد. V-JEPA 2-AC جابجایی اشیاء روی میز را انجام میدهد، نه لباس شستن. شکاف بین «۸۰٪ موفقیت در جابجایی لیوان» و داشتن یک ربات در آشپزخانه، همان شکافی است که LLMها بین بنچمارکها و استقرار واقعی با آن مواجهاند.
تغییرات در میدان بازی
برای مهندسان و پژوهشگران، این یک چرخش از «قوانین مقیاسپذیری» (Scaling Laws) برای متن به سمت «قوانین کارایی» در زمینهسازی (Grounding) فیزیکی است. پرسش کلیدی ابطالپذیری (Falsifiability) باقی میماند: چه چیزی یک پیروزی برای تئوری JEPA محسوب میشود؟ موفقیت زمانی اتفاق میافتد که برنامهریزان سبک JEPA در تعمیمپذیری (Generalization) در مقیاس مشابه، مدلهای vision-language-action را شکست دهند، یا سیستمی زمینهمند شده بهطور محسوسی توهمات کمتری در حوزهای مانند سلامت داشته باشد.
با این حال، لحظه طلایی (A-ha moment) نه از طریق یک جذب سرمایه دیگر، بلکه از این خواهد بود که آیا این مدلهای نهانی میتوانند فراتر از دستورزی روی میز مقیاس پیدا کنند، پیش از آنکه سیستمهای ترکیبی LLM شکاف بنچمارکهای استدلال فیزیکی را پر کنند. تا ژوئیه ۲۰۲۶، AMI Labs هیچ مدل عمومی ندارد. زمانبندی لبرون نشان میدهد که حدود یک سال تا اولین قطعات قابل استفاده و چندین سال تا کاربردهای تجاری در بخشهای سلامت، رباتیک، گجتهای پوشیدنی و صنایع زمان لازم است.
اگر سازنده هستید، هیچکدام از اینها جایگزین فراخوانیهای LLM در سال ۲۰۲۶ نمیشود. هر کسی را که در این فصل API «مدل جهانی» میفروشد، نادیده بگیرید. در عوض، از ابزارهای موجود استفاده کنید: نقاط بازرسی (Checkpoints) مدل V-JEPA 2 عمومی هستند، نسخه ۷ میلیارد پارامتری Cosmos روی یک H100 80GB جا میشود و Marble دارای یک سطح رایگان است. وقتی برچسب مدل جهانی در یک Pitch-Deck ظاهر شد، بپرسید منظورشان «فریم»، «اسپلت» یا «نهان» است و اعداد مربوط به جابجایی اشیاء (Pick-and-Place) را بخواهید. اگر پاسخی نبود، شما همان واژه پرزرقوبرقی را پیدا کردهاید که لبرون دربارهاش هشدار داده بود.



گفتگو