اگر امروز یک بات «گفتگو با اسناد» برای سازمان خود ساختهاید، احتمالاً متوجه شدهاید که مقیاسپذیری آن برای هزاران کاربر، نقطهی شکست سیستم است. مایکروسافت برای حل این چالش، Foundry IQ را معرفی کرد؛ لایهای مدیریتی که واحد بازاستفاده را از خط لولههای پیچیدهی RAG به یک پایگاه دانش مشترک و حاکمیتی تغییر میدهد.
بسیاری از شرکتها در حال حاضر تولید بازیابیافزا (RAG) — که شبیه دانشآموزی است که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — را به صورت مجموعهای از اسکریپتهای پراکنده میسازند. در این حالت، هر عامل جدید به استراتژی تکهبندی (Chunking)، خط لولهی بردار معنایی (Embedding) — مثل کارت معرفی عددی برای هر واژه که همسایگی کلمات را مشخص میکند — و منطق شکنندهای برای مدیریت مجوزها نیاز دارد. طبق گزارش مایکروسافت، این رویکرد منجر به «نشت دسترسی» (Permission Leakage) میشود؛ وضعیتی که در آن یک بات ممکن است به دلیل نادیده گرفتن کنترلهای دسترسی در ایندکس برداری، اطلاعات حساسی مانند حقوق مدیرعامل را برای کاربران غیرمجاز فاش کند.
سامانهی Foundry IQ که در واقع یک پوشش محصولی (Productized Wrapper) روی Azure AI Search است، بازیابی را به یک منبع درجهیک تبدیل میکند. به جای نوشتن خط لولههای تکراری، توسعهدهندگان چندین عامل (N agents) را به یک پایگاه دانش واحد متصل میکنند. در این معماری، اجرای مجوزها در مسیر پرسوجو تعبیه شده است تا اطمینان حاصل شود عامل تنها دادههایی را بازیابی میکند که کاربر خاص اجازه دیدن آنها را دارد.
همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، جداسازی لایهی دسترسی از لایهی استنتاج، تنها راه جلوگیری از افشای دادههای حساس در مقیاس سازمانی است.
مکانیزم بازیابی عاملمحور
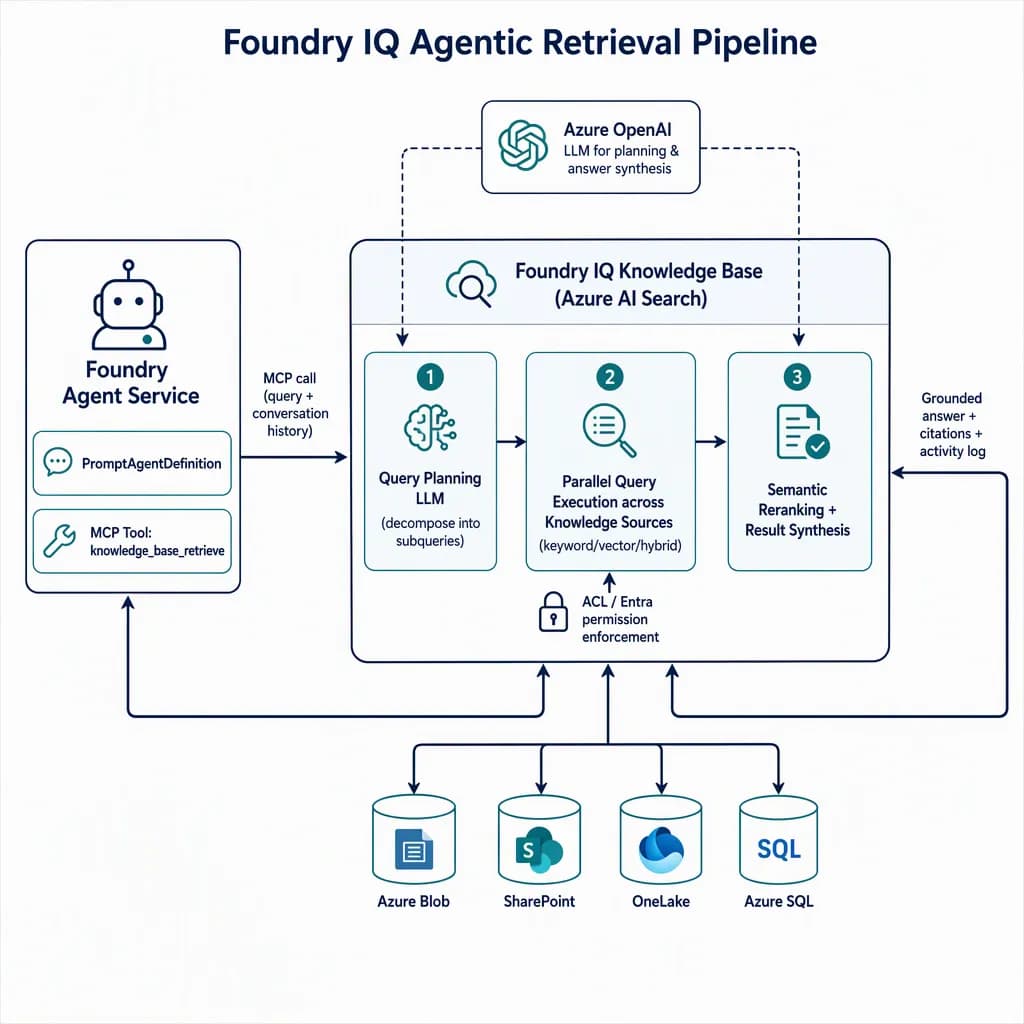
Foundry IQ از جستوجوی برداری ساده فراتر رفته و «بازیابی عاملمحور» (Agentic Retrieval) را پیاده میکند. این رویکرد در واقع بخشی از تحول گستردهتری است که در آن پاسخهای محاورهای هوش مصنوعی در حال جایگزینی با لینکهای سنتی موتورهای جستوجو هستند تا تجربه کاربر از یافتن اطلاعات تغییر کند. بر اساس مستندات مایکروسافت، وقتی یک عامل پایگاه دانش را فراخوانی میکند، سیستم صرفاً یک جستوجوی تکمرحلهای انجام نمیدهد، بلکه یک خط لولهی چندمرحلهای را اجرا میکند:
- برنامهریزی پرسوجو (Query Planning): یک مدل Azure OpenAI پرسوجوی پیچیده کاربر را به زیر-پرسشهای متمرکز تجزیه میکند. برای مثال، درخواست «مقایسه مرخصی زایمان در آمریکا و آلمان» به دو جستوجوی مجزا تقسیم میشود. نکته اینجاست که اگر سطح تلاش برای استدلال (Reasoning Effort) روی حالت «حداقلی» (Minimal) تنظیم شده باشد، این مرحله بهطور کامل نادیده گرفته میشود.
- اجرای موازی: این زیر-پرسشها بهطور همزمان روی تمام منابع دانش پیکربندیشده اجرا میشوند. سیستم بسته به هر منبع، از جستوجوی کلیدواژهای، برداری یا ترکیبی (Hybrid) استفاده میکند.
- بازرتبهبندی معنایی (Semantic Reranking): نتایج از طریق یک بازرتبهبند سطح ۲ (L2 Semantic Reranker) پردازش میشوند تا مرتبطترین پاسخها، فارغ از نزدیکی سادهی برداری، در اولویت قرار گیرند.
- ترکیب نتایج (Result Synthesis): سیستم محتوای استخراجشده را ادغام کرده و در حالت پیشنمایش (Preview mode)، میتواند یک پاسخ زبانطبیعی نهایی همراه با ارجاعات (Citations) دقیق تولید کند.
منابع دانش و پل MCP
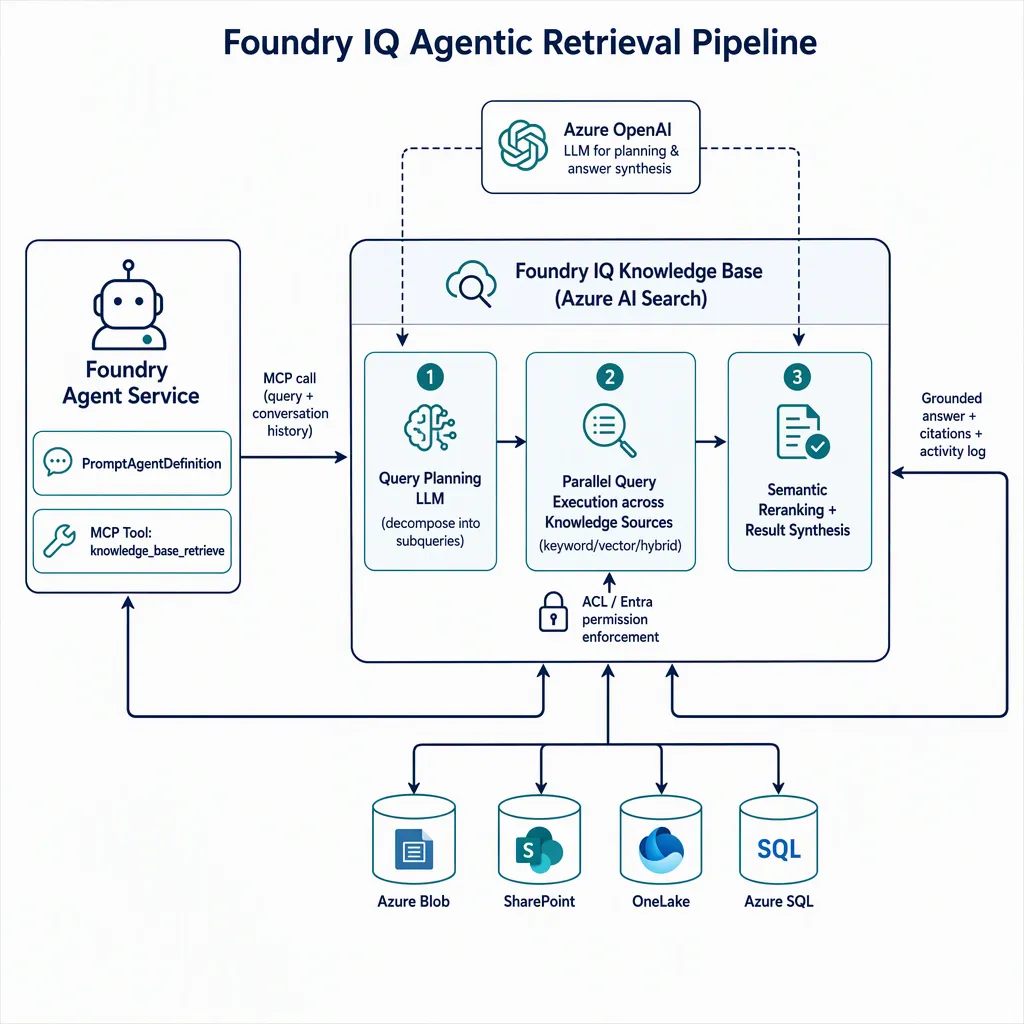
Foundry IQ دو نوع منبع دانش را تفکیک میکند. انتخاب بین این دو بر اساس موازنه بین تازگی دادهها (Freshness)، تأخیر (Latency) و میزان کنترل است.
منابع دانش ایندکسشده (Indexed Knowledge Sources): این منابع محتوا را از پیش از طریق یک خط لوله جذب میکنند که وظایف تکهبندی، تولید بردارها و استخراج متادیتا را بر عهده دارد. انواع پشتیبانیشده عبارتند از:
- ایندکسهای جستوجوی موجود (Search Index)
- Azure Blob
- Azure SQL (در حالت پیشنمایش)
- فایلهای محلی (در حالت پیشنمایش)
- OneLake
- SharePoint ایندکسشده (در حالت پیشنمایش)
منابع دانش راه دور (Remote Knowledge Sources): این منابع محتوا را در لحظهی پرسوجو بهصورت زنده فراخوانی میکنند. این روش باعث میشود تکرار دادهها صفر شود و مجوزهای بومی منبع بهطور مستقیم اجرا گردند. انواع پشتیبانیشده عبارتند از:
- SharePoint راه دور (پیشنمایش، از طریق Copilot Retrieval API)
- Fabric Data Agent (پیشنمایش)
- Fabric Ontology (پیشنمایش)
- سرورهای MCP (پیشنمایش)
- Work IQ (پیشنمایش)
- وب (از طریق Bing)
نکته کلیدی این است که Foundry Agent Service منحصراً از طریق پروتکل زمینهٔ مدل (Model Context Protocol یا MCP) با این پایگاهها ارتباط برقرار میکند. پایگاه دانش یک نقطه انتهایی (Endpoint) خاص MCP را در مسیر {search_service_endpoint}/knowledgebases/{knowledge_base_name}/mcp?api-version=2026-08-01-preview ارائه میدهد که تنها یک ابزار را فراهم میکند: knowledge_base_retrieve.
این طراحی به این معناست که پایگاه دانش یک «ابزار راه دور» است، نه یک تابع داخلی در فرآیند اجرا. اگرچه این معماری باعث ایجاد یک رفتوبرگشت شبکهای (Network Round-trip) و سربار مربوط به قالببندی MCP میشود، اما اجازه میدهد یک پایگاه دانش واحد توسط هر کلاینت سازگار با MCP، از جمله Copilot Studio یا Microsoft Agent Framework مصرف شود. در ردیابیهای عامل (Agent Traces)، این موضوع به جای تأخیر مدل، به عنوان تأخیر ابزار (در بازههای mcp_approval_request یا tool-call) ظاهر میشود.
واقعیت اجرای مجوزها
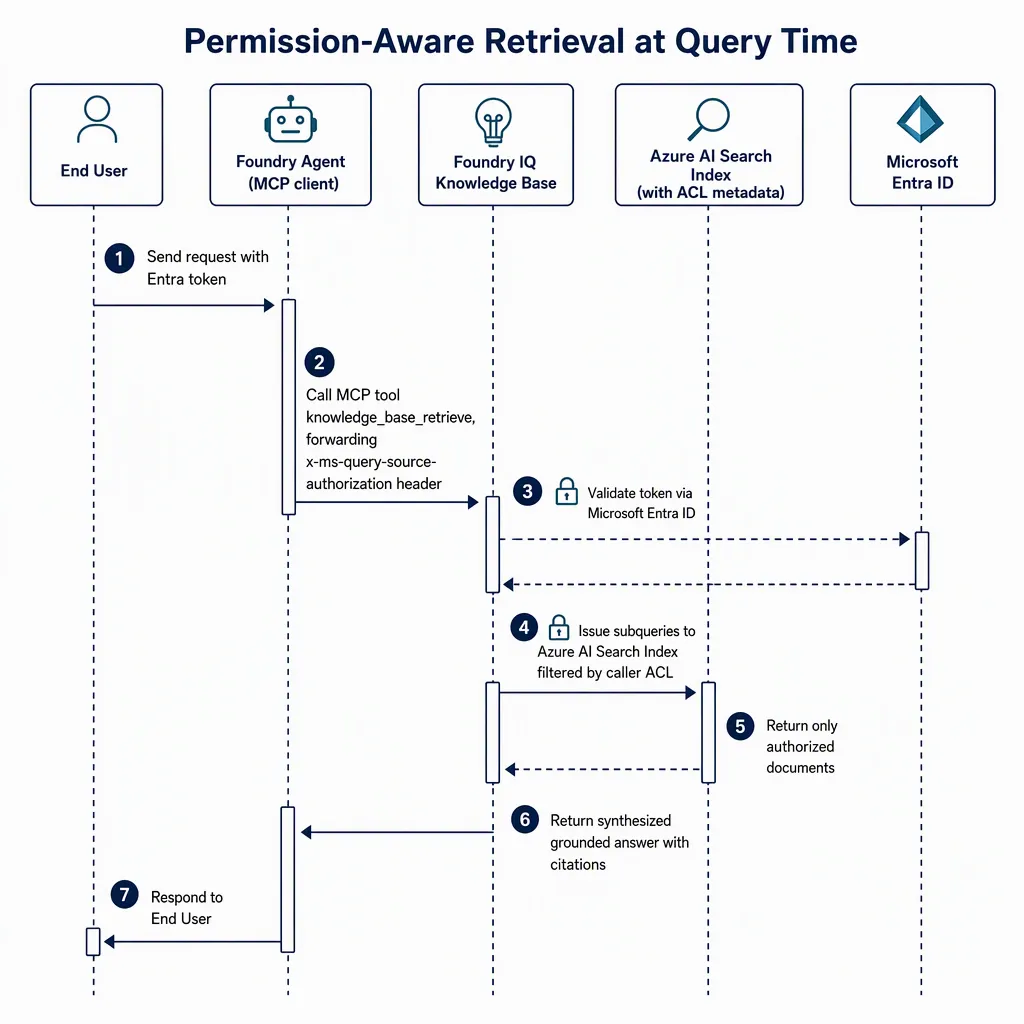
امنیت در Foundry IQ خودکار نیست و بهشدت به نوع منبع بستگی دارد. طبق مستندات فنی، اشتباه گرفتن این دو مکانیزم یک خطای رایج و خطرناک است:
- منابع SharePoint راه دور: سیستم هدر احراز هویت (Authorization Header) کاربر را مستقیماً به Copilot Retrieval API مربوط به SharePoint میفرستد. در اینجا، SharePoint مدل مجوزهای بومی خود را در لحظه پرسوجو اجرا میکند و از هرگونه عدم تطابق بین منبع و ایندکس جلوگیری میشود.
- منابع ایندکسشده: توسعهدهندگان باید فیلدهای متادیتای لیست کنترل دسترسی (ACL) را بهصورت دستی با ایندکس جستوجو همگام کنند. برای اجرای این مجوزها، هویت کاربر فراخوان باید در زمان پرسوجو از طریق هدر
x-ms-query-source-authorizationارسال شود.
اگر این فیلدها پر نشوند و هدر ارسال نگردد، ایندکس نسبت به مجوزها «کور» خواهد بود. همچنین، توسعهدهندگان باید «نشت تاریخچه گفتگو» (Conversation-history leakage) را در نظر بگیرند. از آنجایی که مدل برنامهریز پرسوجو، پرسوجوی خام و تاریخچه را دریافت میکند، محتوای حساس از مراحل قبلی گفتگو ممکن است به مدل برنامهریز ارسال شود؛ بنابراین، سیاستهای اقامت دادههای (Data Residency) استقرار Azure OpenAI به یک مرز امنیتی حیاتی تبدیل میشود.
موازنه تولید و هزینه
پیادهسازی Foundry IQ نیازمند مدیریت دقیق نسخههای API است. تا تاریخ ۲۹ سپتامبر ۲۰۲۶، نسخه GA (نسخه ۲026-04-01) تنها از استدلال حداقلی و نتایج استخراجی برای انواع منابع GA پشتیبانی میکند. برای باز کردن قابلیتهای برنامهریزی پرسوجو مبتنی بر LLM، سنتز پاسخ و استفاده از منابع پیشنمایش (مانند SharePoint یا وب)، توسعهدهندگان باید از نسخه 2026-08-01-preview استفاده کنند.
هزینهها در یک صورتحساب جداگانه برای Foundry IQ نیستند، بلکه در خدمات زیربنایی جمع میشوند. یک پرسوجوی پیچیده با استدلال «متوسط» میتواند موارد زیر را فعال کند:
۱. توکنهای Azure OpenAI: یک فراخوانی برای برنامهریزی پرسوجو و یکی برای سنتز پاسخ نهایی. این هزینهها بر اساس استقراری که روی پایگاه دانش پیکربندی شده محاسبه میشود، نه مدلِ خودِ عامل.
۲. محاسبات Azure AI Search: چندین پرسوجوی موازی و مراحل بازرتبهبندی معنایی L2.
۳. هزینههای API راه دور: هزینههای مربوط به فراخوانیهای Copilot Retrieval API در SharePoint یا فراخوانیهای Fabric Data Agent.
مسیر پیادهسازی
برای استقرار، توسعهدهندگان ابتدا یک اتصال ARM به نقطه انتهایی MCP پایگاه دانش با استفاده از ProjectManagedIdentity ایجاد میکنند. این کار اجازه میدهد هویت سیستمتعیینشدهی پروژه بدون نیاز به مدیریت کلیدهای API، در Azure AI Search احراز هویت شود.
این فرآیند نیازمند سه تخصیص RBAC مشخص است:
- نقش Foundry Project Manager روی منبع والد پروژه.
- نقش Search Index Data Reader (و نقش Contributor در صورت نیاز به نوشتن) برای هویت مدیریتشدهی پروژه در سرویس Search.
- نقش Cognitive Services User برای هویت سیستمتعیینشدهی خودِ سرویس جستوجو در حساب Foundry (این مورد برای اینکه سرویس Search بتواند جهت برنامهریزی و سنتز، مدل LLM را فراخوانی کند، ضروری است).
سپس عامل با یک PromptAgentDefinition تعریف میشود که شامل MCPTool است. پرامپت سیستمی در اینجا حیاتی است؛ مایکروسافت اشاره میکند که دستورات صریح برای اجبار به ارجاعدهی (مثلاً با فرمت [message_idx:search_idx | source_name]) و الزام به استفاده از ابزار، نرخ توهم (Hallucination) را بهشدت کاهش داده و نرخ موفقیت فراخوانیهای بازیابی را افزایش میدهد.
سناریوی واقعی: دستیار سیاستهای HR
تصور کنید شرکتی فایلهای PDF سیاستهای HR در SharePoint، یک نمودار سازمانی در Azure SQL و پرسشهای متداول مزایا در یک Fabric Lakehouse دارد. به جای ساخت سه خط لوله مجزا، تیم یک پایگاه دانش واحد (hr-policy-kb) میسازد که به سه منبع دانش اشاره میکند: یک منبع SharePoint ایندکسشده، یک منبع Azure SQL و یک منبع OneLake یا Fabric Data Agent.
دو عامل مجزا — یک بات داخلی برای کارکنان و یک ابزار تحلیل برای مدیران — به این پایگاه دانش واحد متصل میشوند. وقتی مدیری درباره شرایط مرخصی زایمان در آلمان برای تیم خاص خود میپرسد، خط لوله درخواست را به یک جستوجوی سیاست (در SharePoint) و یک جستوجوی نمودار سازمانی (در SQL) تجزیه میکند. هدر ACL تضمین میکند که مدیر تنها گزارشهایی را ببیند که مجاز به مشاهده آنهاست، در حالی که هر دو عامل از بهبودهای متمرکز در بازرتبهبندی و امنیت بهرهمند میشوند.
اشتباهات رایج و توصیهها
- پروژههای Hub-based: ادغام MCP در Foundry IQ نیازمند پروژههای استاندارد Foundry است؛ پروژههای مبتنی بر Hub پشتیبانی نمیشوند.
- همراستایی منطقه (Region Alignment): بازیابی عاملمحور تنها در مناطق خاصی از Azure AI Search در دسترس است. مطمئن شوید سرویس جستوجوی شما در منطقه صحیح مستقر شده است.
- تست قرارداد ارجاعات: دستورات عامل را به عنوان مصنوعات نسخهبندی شده (Versioned Artifacts) در نظر بگیرید. تست کنید که آیا عامل در صورت عدم دریافت پاسخ از پایگاه دانش، بهجای استفاده از حافظه پارامتریک، بهدرستی پاسخ «نمیدانم» را میدهد یا خیر. این رویکرد برای حذف نویزهای حافظه مشابه است با آنچه در سیستم Strands Agents برای استخراج حقایق بادوام پیاده شده است.
- بودجه تأخیر (Latency Budgeting): به دلیل اینکه برنامهریزی پرسوجو یک رفتوبرگشت LLM و چندین مرحله بازرتبهبندی اضافه میکند، بازیابی عاملمحور کندتر از RAG ساده است. تأخیر P95 فراخوانی ابزار را در OpenTelemetry اندازه بگیرید تا تصمیم بگیرید آیا سطح استدلال را از «متوسط» به «کم» یا «حداقلی» کاهش دهید یا خیر.
- تثبیت API (API Pinning): به پیشفرضهای پورتال تکیه نکنید، زیرا اغلب از طرحهای (Schemas) پیشنمایش استفاده میکنند. نسخه REST API را در کد خود ثابت کنید تا از تغییرات ناگهانی در زمان انتقال به نسخه GA جلوگیری شود.
تحلیل جریان معماری و منطق
برای درک نحوه جریان یک پرسوجو، نقش سرویسهای مالک را بررسی میکنیم. پایگاه دانش (Azure AI Search) ارکستراتور خط لوله است و پارامترهای تلاش برای استدلال را مدیریت میکند. منابع دانش (Azure AI Search) محتوا را تعریف میکنند. بازرتبهبند معنایی (Azure AI Search) رتبهبندی سطح ۲ را انجام میدهد. LLM (از طریق Foundry Models در Azure OpenAI) قدرت برنامهریزی و سنتز را فراهم میکند. در نهایت، Foundry Agent Service پایگاه دانش را به عنوان یک ابزار MCP مصرف میکند.
جزئیات پیادهسازی در SDK
هنگام پیکربندی MCPTool در SDK پایتون، توسعهدهندگان باید به دو پارامتر خاص توجه کنند:
require_approval="never": این یک تصمیم امنیتی است. در حالی که برای بازیابیهای فقط-خواندنی قابل دفاع است، اما اگر منبع دانش (مانند Fabric Data Agent) بتواند اثرات جانبی هزینهبر یا عملیات نوشتاری ایجاد کند، باید بازبینی شود.allowed_tools=["knowledge_base_retrieve"]: این پارامتر به عنوان یک لیست سفید (Allow-list) عمل میکند. اگرچه در حال حاضر این تنها ابزار ارائه شده است، اما از گسترش بیصدای قابلیتها در صورتی که API سمت سرور در آینده ابزارهای جدیدی اضافه کند، جلوگیری میکند.
مقایسه با جایگزینها
Foundry IQ یک الگوریتم بازیابی جدید نیست، بلکه یک لایه استانداردسازی است. در مقایسه با سایر رویکردها:
- RAGهای دستساز: کنترل کاملی برای دامنههای بسیار تخصصی (مانند ژنومیک) ارائه میدهند، اما توسعهدهنده باید مسئولیت تجزیه پرسوجو، بازرتبهبندی و اجرای ACL را برای هر عامل بهطور جداگانه بر عهده بگیرد.
- تنظیم پرامپت/ابزار به تنهایی: برای پایگاههای دانش کوچک و ایستا کاربرد دارد، اما در مقیاس بیش از چند سند شکست میخورد و فاقد زیرساخت ارجاعدهی است.
- استفاده مستقیم از Azure AI Search: همان موتور را فراهم میکند اما تجربه کاربری نویسندگی در پورتال Foundry و قرارداد استاندارد MCP برای عاملهای Foundry را از دست میدهد.
- سرویسهای RAG شخص ثالث: استراتژیهای چند-ابری (Multi-cloud) را پشتیبانی میکنند اما ادغام بومی با Purview و اتصال مستقیم MCP به Foundry Agent Service را ندارند. این سطح از یکپارچگی باعث میشود بسیاری задума کنند که آیا ابزارهای SaaS فعلی تا سه سال آینده منسوخ خواهند شد و جای خود را به اکوسیستمهای متمرکزتر میدهند.
چکلیست نهایی تولید
قبل از انتقال به محیط تولید، تیمها باید موارد زیر را تأیید کنند:
- بازسازی ACL: اطمینان حاصل کنید که هر ایندکس قدیمی که فاقد مجوز بود، با فیلدهای متادیتای ACL بهروزرسانی شده است.
- بهداشت هویت: تأیید کنید که هویت سیستمتعیینشدهی سرویس Search نقش
Cognitive Services Userرا دارد؛ در غیر این صورت، برنامهریزی و سنتز بهطور بیصدا دچار افت کیفیت میشوند. - بودجه SLA: تأخیر P95 فراخوانی ابزار را در زمان پاسخدهی کلی عامل لحاظ کنید، زیرا بازیابی عاملمحور ذاتاً کندتر از خط لولههای تک-پرسوجویی است.
- نسخهبندی دستورات: با پرامپت سیستمی مانند کد رفتار کنید. یک پرامپت با عبارتبندی ضعیف، بهطور محسوسی نرخ فراخوانی ابزار
knowledge_base_retrieveتوسط عامل را کاهش میدهد.
گام بعدی شما
- اگر از Azure AI Search استفاده میکنید، مدل دسترسیهای خود را از سطح ایندکس به سطح لایهی مدیریت Foundry IQ منتقل کنید.
- تأخیرهای ابزار-فراخوانی (Tool-call latency) را در OpenTelemetry رصد کنید تا سطح استدلال (Reasoning Effort) را بهینه کنید.
- پروتکل MCP را برای یکپارچهسازی عاملهای مختلف با یک منبع دانش واحد بررسی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو