۱.۳ پتافلاپس؛ این عدد سقف جدیدی است که اینتل برای محاسبات FP8 تعریف کرده تا جایگاه خود را در میدان سختافزارهای هوش مصنوعی تثبیت کند. در ۱۲ اکتبر ۲۰۲۶، این شرکت رسماً از تراشههای D-Series پردهبرداری کرد و سختافزاری را که پیشتر با نام «Crescent Island» شناخته میشد، وارد خط تولید کرد.
باید بدانید که برچسب «GPU» در اینجا به معنای کارت گرافیکهای گیمینگ نیست. این تراشهها برای بازاری طراحی شدهاند که در آن هوش مصنوعی زاینده (Generative AI) — شبیه به یک کارخانه عظیم تولید محتوا که به جای مواد خام، از دادهها تغذیه میکند — به قدرت محاسباتی موازی و عظیمی برای استنتاج (Inference) — یعنی همان لحظه تولید جواب توسط مدل، مثل خودِ آشپزی و نه یادگیری دستور پخت — نیاز دارد.
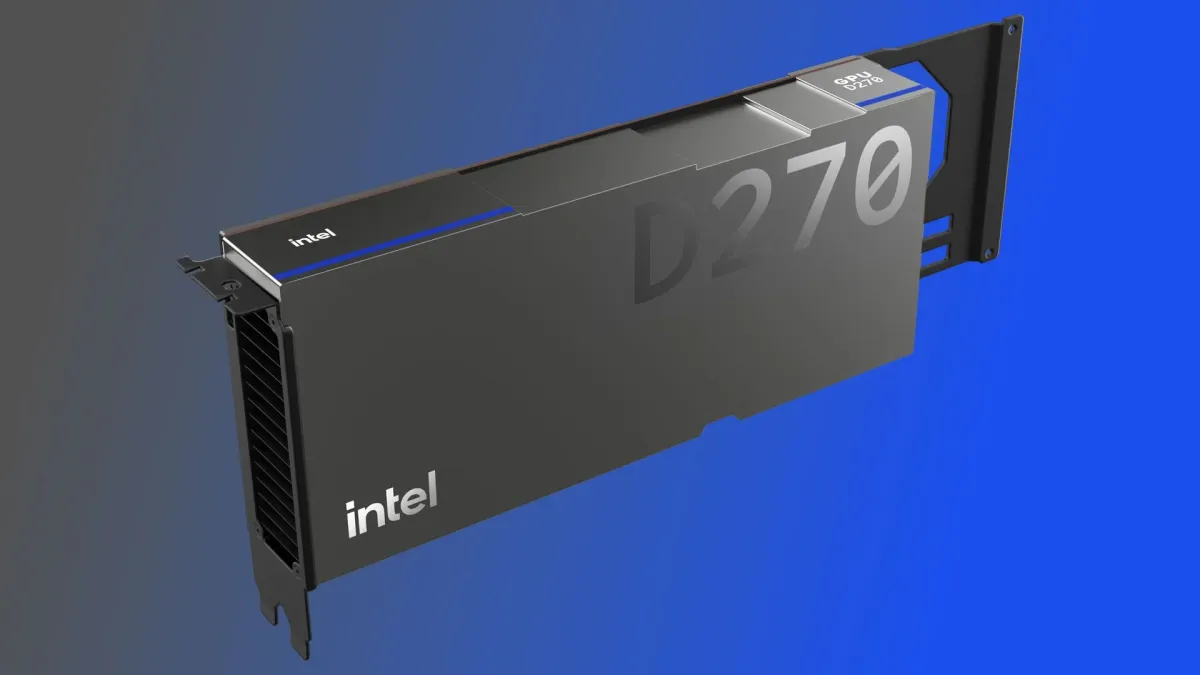
به نقل از مستندات رسمی اینتل، سری D-Series بر پایه معماری Xe3P ساخته شده و مشخصات فنی زیر را ارائه میدهد:
- قدرت محاسباتی: حداکثر ۱.۳ PFLOPS برای محاسبات تخصصی هوش مصنوعی.
- حافظه: پشتیبانی از حداکثر ۴۸۰ گیگابایت حافظه LPDDR5X.
- پهنای باند: نرخ انتقال داده ۱.۵ ترابایت بر ثانیه.
- توان و فرم: مصرف انرژی ۳۵۰ وات (TDP) در قالب PCIe با سیستم خنککننده بادی.
همانطور که در تحلیلهای قبلی ما دربارهی رقابت سختافزاری شتابدهندهها اشاره کردیم، تمرکز بر حافظه LPDDR5X با ظرفیت بالا نشان میدهد که اینتل قصد دارد بارهای کاری «محدود به حافظه» را هدف قرار دهد. این یعنی اجرای مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — روی یک کارت واحد، بدون نیاز به خوشههای پیچیده از چندین GPU.
طبق گزارش تحلیلگران سختافزار، این تغییر برای مالکان کسبوکارها به معنای کاهش فضای فیزیکی زیرساختهای هوش مصنوعی است. حافظه بیشتر در هر تراشه اجازه میدهد مدلهای خصوصی سازمانی بدون هزینههای برق سرسامآورِ خوشههای سطح بالای H100 مستقر شوند. این رویکرد برای سازمانهایی که به دلیل مسائل امنیتی نیاز به استقرار مدلها در محیطهای ایزوله دارند، مشابه راهکارهای اجرای هوش مصنوعی در محیطهای Air-Gapped است که امنیت دادهها را در اولویت قرار میدهند.
گام بعدی شما
- نتایج بنچمارکهای اولیه معماری Xe3P را در برابر محصولات انویدیا دنبال کنید تا ببینید آیا اعداد تئوریک به سرعت واقعی تبدیل میشوند یا خیر.
- اگر در حال طراحی زیرساخت مدلهای متوسط هستید، هزینه استقرار تککارت D-Series را با خوشههای چند-GPU مقایسه کنید.
- بررسی کنید که آیا مدلهای فعلی شما با پهنای باند ۱.۵ ترابایت بر ثانیه سازگار هستند.
اما نبرد واقعی در لایه نرمافزاری و بهینهسازی درایورها رخ میدهد؛ تحلیل ما دربارهی اکوسیستم CUDA و جایگزینهای آن را از دست ندهید.



گفتگو