اگر امروز برای مدیریت دستهای از عاملهای هوش مصنوعی در مرکز داده هزینه میکنید، احتمالاً با دیوارِ کمبود حافظه برخورد کردهاید. اینتل با معرفی D270، دقیقاً روی همین نقطه ضعف دست گذاشته تا استنتاج مدلهای با زمینه بلند را از یک کابوس هزینهای به یک فرآیند بهینه تبدیل کند. ۴۸۰ گیگابایت حافظه، ستون اصلی Intel GPU D270 است؛ سختافزاری که با مأموریتی خاص وارد مراکز داده شده است: حل گلوگاه حافظه در هوش مصنوعی عاملمحور (Agentic AI).
در ۱۲ اکتبر ۲۰۲۶، اینتل این ظرفیت را به عنوان پاسخی مستقیم به تغییر ماهیت مدلها معرفی کرد؛ مدلهایی که اکنون بیش از آنکه بنویسند، میخوانند و برای استدلالهای چندمرحلهای و مدیریت زمینههای طولانی (Long Contexts) به حافظهای عظیم نیاز دارند. همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی استنتاج اشاره کردیم، مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — در حالت عاملمحور، فشار محاسباتی را به مرحله پیشپُرکردن (Prefill) منتقل میکنند.
بیشتر زیرساختهای فعلی برای آموزش یا استنتاجهای کوتاه طراحی شدهاند. اما گردشکارهای عاملمحور (Agentic) — جایی که مدل ابزارها را فراخوانی میکند، مراحل را استدلال میکند و تاریخچه طولانی را حفظ میکند — باعث میشود سختافزار بتواند پرامپتهای حجیم و جلسات همزمان را بدون نیاز به سیستمهای خنککننده مایع یا حافظههای بسیار گرانقیمت HBM (حافظه پهنایباند بالا) مدیریت کند.
زمینه و ضرورت هوش مصنوعی عاملمحور
به گزارش اینتل، هوش مصنوعی عاملمحور اساساً بار کاری مراکز داده را تغییر داده است. برخلاف چتباتهای سنتی، عاملها در حلقههای تکرار شونده عمل میکنند. آنها زمینههای طولانی را میخوانند، گردشکارهای چندمرحلهای را اجرا میکنند و چندین بار مدل را فراخوانی میکنند. این رفتار، فشار محاسباتی را به مرحله پیشپُرکردن — یعنی لحظهای که مدل ورودی را تحلیل میکند تا آماده تولید جواب شود — منتقل میکند. این تغییر در الگوهای مصرف، دقیقاً همان عاملی است که تقاضای برق در مراکز داده را به شدت افزایش داده و زیرساختهای انرژی را به چالش کشیده است.
با رشد این تقاضاها، چالشها فراتر از پهنای باند ساده میروند. مقیاسبندی هوش مصنوعی عاملمحور نیازمند توانایی مدیریت ناوگانهای عامل (Agentic Fleets) در طول هزاران گام استدلال است. برای حفظ توان عملیاتی (Throughput) در طول حلقه عامل، این عاملها باید در حافظه «ساکن» (Resident) باقی بمانند. این امر از جهشهای تأخیر (Latency) ناشی از بارگذاری مجدد و مداوم مدل جلوگیری میکند.
علاوه بر این، استدلال بر اساس کل زمینه (Whole-context reasoning) به یک اولویت تبدیل شده است. برای دستیابی به استدلالهای غنیتر، سیستم باید بخش بیشتری از مدل و زمینه طولانی را در حافظه نگه دارد. سری D اینتل قصد دارد این قابلیت را با استفاده از تعداد GPU کمتر و حذف نیاز به HBM گرانقیمت فراهم کند.
ماهیت بارهای کاری عاملمحور
تفاوت اصلی تعاملات استاندارد با سیستمهای عاملمحور در تبدیل یک تکلیف ساده به یک توالی پیچیده است. این توالی معمولاً شامل چندین دور فراخوانی مدل، استفاده از ابزار، بازیابی اطلاعات (Retrieval)، استدلال و در نهایت تولید پاسخ است.
چون این عاملها پیش از تولید هر پاسخ، حجم عظیمی از اطلاعات را پردازش میکنند، بار کاری به شدت تحت سلطه مرحله پیشپُرکردن است. این وضعیت نیازمند تعادلی خاص بین ظرفیت حافظه و بهرهوری محاسباتی است تا از ایجاد گلوگاه در طول پردازش اولیه پرامپتهای بلند جلوگیری شود.
اقتصاد استنتاج
برای مقیاسبندی ظرفیت سرویسدهی، کنترل هزینهها کلید اصلی است. اینتل روی بیشینه کردن تعداد توکن در هر رک و هر وات تمرکز کرده است. با استفاده از زیرساختهای استاندارد PCIe، متراکم و خنککننده هوا، D270 اجازه میدهد استنتاج بیشتری در همان توان مصرفی و رکهایی که سازمانها در حال حاضر دارند، انجام شود.
این رویکرد، تضادهای معمول بین توان مصرفی، هزینه و پیچیدگی استقرار را حذف میکند. مشتریان میتوانند قابلیتهای عاملمحور خود را بدون نیاز به بازطراحی کامل شبکه برق یا معماری خنککننده مرکز داده گسترش دهند.
معماری سختافزاری و مشخصات فنی
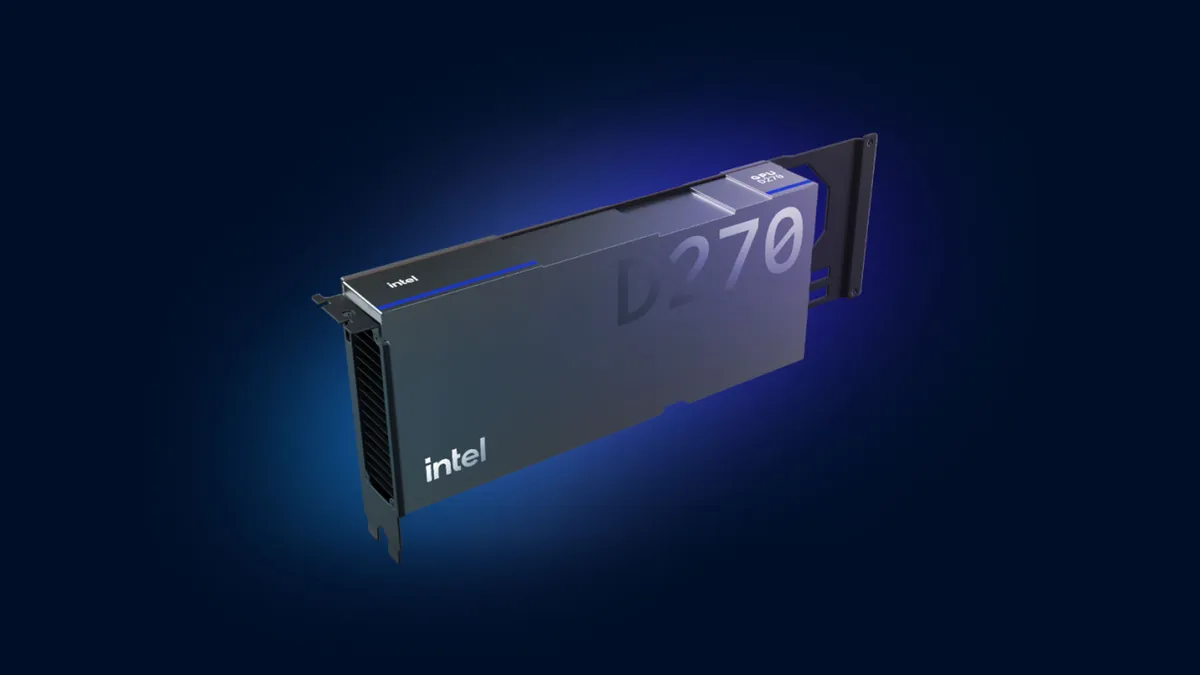
بر اساس مستندات رسمی اینتل، D270 (که پیشتر با نام کد Crescent Island شناخته میشد) فضای تراشه را از خطوط گرافیکی و رهگیری پرتو (Ray-tracing) گرفته و به هستههای Xe3P و محاسبات ماتریسی اختصاص داده است تا بهرهوری استنتاج به حداکثر برسد. این بازتخصیص تضمین میکند که قدرت محاسباتی دقیقاً در جایی قرار گیرد که برای بارهای کاری هوش مصنوعی بیشترین اهمیت را دارد.
مشخصات فنی کلیدی عبارتند از:
- حافظه: تا ۴۸۰ گیگابایت حافظه LPDDR5X، طراحی شده برای استنتاجهای حافظهمحور و کممصرف در محیطهای مرکز داده.
- قدرت محاسباتی: ۳۲ هسته Xe3P و ۲۵۶ موتور XMX برای شتابدهی به پیشپُرکردن و کاهش هزینههای مرتبط با هوش مصنوعی عاملمحور با زمینه بلند.
- عملکرد: اوج تئوریک ۱.۳ PFLOPS در محاسبات FP8 (به نقل از dev.to).
- پهنای باند: ۱.۵ ترابایت بر ثانیه پهنای باند حافظه.
- توان: TDP معادل ۳۵۰ وات با خنککننده غیرفعال (Passive air-cooling).
- اتصال: فرمفاکتور و رابط استاندارد PCIe 5.0.
مکانیزمهای طراحی دقیق
اینتل D270 را به طور خاص برای نیازهای تولیدی (Production) هوش مصنوعی ساخته است. تمرکز طراحی بر چندین مکانیزم کلیدی است:
انعطافپذیری دقت (Precision):
- سختافزار از طیف گستردهای از دقتها برای تناسب با بارهای کاری خاص پشتیبانی میکند.
- استنتاج بومی با دقت پایین (Low-precision) برای دستیابی به حداکثر سرعت ارائه میدهد.
- از FP64 برای محاسبات علمی پشتیبانی میکند.
- در اینجا، نوع بار کاری است که دقت را تعیین میکند، نه محدودیتهای سختافزاری.
مدیریت حرارتی:
- طراحی ۳۵۰ واتی با خنککننده هوا از سیستم خنککننده غیرفعال استفاده میکند.
- این امر اجازه میدهد GPU در رکهای موجود بدون نیاز به نوسازی برای خنککننده مایع نصب شود.
- این طراحی شکاف بین مراحل ارزیابی و استقرار را در رابطه با ارتقای تجهیزات مرکز داده از بین میبرد.
سازگاری با زیرساخت:
- با استفاده از فرمفاکتور استاندارد PCIe 5.0، D270 نیاز به شبکههای اختصاصی (Proprietary) را حذف میکند.
- هیچ سیستم سفارشی و خاصی برای استقرار مورد نیاز نیست.
- این محصول طوری طراحی شده که در سرورهایی که سازمانها در حال حاضر اجرا میکنند، جای بگیرد.
ظرفیت حافظه:
- ظرفیت بالای حافظه موجود به طور خاص برای مدیریت رشد KV Cache (حافظه موقت کلید-مقدار) در طول استنتاج طراحی شده است.
- این مورد، گلوگاه اصلی در گردشکارهای متکی به بازیابی (Retrieval-heavy) است.
- این معماری از مدلهای بزرگتر و زمینههای طولانیتر را به طور همزمان پشتیبانی میکند.
طراحی برای حلقه عاملمحور
یک درخواست کاربر در سیستمهای عاملمحور اغلب به دهها فراخوانی داخلی مدل، استفاده از ابزار، بازیابی، استدلال و تولید پاسخ تبدیل میشود. D270 طوری طراحی شده است که این عاملها را «ساکن» در حافظه نگه دارد. این کار از بارگذاری مکرر وزنهای مدل و زمینهها جلوگیری میکند؛ اتفاقی که معمولاً توان عملیاتی را در ناوگانهای بزرگ عاملها نابود میکند.
با پشتیبانی از زمینههای ۱۰۰ هزار توکنی و دهها جلسه همزمان، این سختافزار استدلالهای غنیتر را با GPUهای کمتر ممکن میکند. اینتل ادعا میکند که این رویکرد، تعداد توکن در هر رک و هر وات را با استفاده از زیرساخت استاندارد PCIe 5.0 به جای شبکههای اختصاصی یا سیستمهای سفارشی خنککننده مایع، به حداکثر میرساند.
این تمرکز بر طراحی «بهینهشده برای استنتاج» یعنی GPU برای اجرای مدلها در محیط تولید (Production) تنظیم شده است، نه برای آموزش آنها در مقیاس عظیم. اولویت با پردازش پرامپت، سرویسدهی با همزمانی بالا و عملکرد در سطح سیستم است، نه توان خام مورد نیاز برای آموزش اولیه مدل.
کاربردهای عملی در محیط تولید
اینتل D270 را برای مجموعهای خاص از بارهای کاری استنتاج هوش مصنوعی در محیط تولید بهینه کرده است. این موارد عبارتند از:
- هوش مصنوعی عاملمحور: مدیریت حلقههای چندمرحلهای عاملهای خودمختار.
- RAG با زمینه بلند: پشتیبانی از تولید بازیابیافزا (RAG) — مثل دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — با مجموعههای عظیم اسناد.
- دستیارهای سازمانی: ابزارهای درک سند و دستیارهای کدنویسی با قابلیت اطمینان بالا.
- هوش مصنوعی چندوجهی: مدیریت ورودیهای پیچیده در رسانههای مختلف و مدلهای انتشار (Diffusion Models).
- سرویسدهی با همزمانی بالا: مدیریت جلسات همزمان متعدد برای ارائهدهندگان SaaS و GPUaaS.
استقرار و اکوسیستم
برای تضمین پذیرش سریع، D270 از روز اول (Zero-day) از مدلهای باز پیشرو پشتیبانی میکند. این سختافزار با اکوسیستم باز PyTorch و چارچوبهای سرویسدهی مانند vLLM، SGLang و OpenAI Triton ادغام شده است. این یعنی توسعهدهندگان میتوانند سختافزار را در گردشکارهای موجود هوش مصنوعی خود استقرار دهند بدون اینکه نیاز به بازنویسی کل پشته نرمافزاری خود داشته باشند. برای کسانی که به دنبال استقرار محلی هستند، انتخاب توزیعهای لینوکسی بهینه میتواند فرآیند پیادهسازی این مدلها را در محیطهای شخصی یا سازمانی تسهیل کند.
مخاطبان هدف و پروفایل استقرار
مخاطبان اصلی برای این استقرار عبارتند از:
- معماران: معماران سیستمهای هوش مصنوعی و معماران پلتفرم AI.
- رهبران مهندسی: رهبران مهندسی زیرساخت و ابر.
- تصمیمگیرندگان: تصمیمگیرندگان هوش مصنوعی در سطح سازمان.
- ارائهدهندگان خدمات: ارائهدهندگان SaaS و GPUaaS.
- ابرهای تخصصی: تیمهای ابر حاکمیتی یا دولتی که به شتابدهندههای غنی از حافظه نیاز دارند.
این کاربران میتوانند D270 را در محیطهای موجود مرکز داده بدون نیاز به نوسازیهای تخصصی خنککننده مایع ارزیابی کنند. این ویژگی، آن را به انتخابی ایدهآل برای استقرار در ابرهای حاکمیتی تبدیل میکند که باید از محدودیتهای سختگیرانه تجهیزات مرکز داده پیروی کنند.
چرخش اقتصادی
از منظر تجاری، D270 نشاندهنده حرکت به سمت سختافزارهای «بهینهشده برای استنتاج» است. در حالی که آموزش مدلها به مقیاس عظیم و HBM نیاز دارد، استنتاج در محیط تولید اغلب توسط هزینه برق و محدودیتهای فیزیکی رک محدود میشود.
اینتل با شرطبندی روی LPDDR5X و خنککننده هوا، معتقد است سازمانها پهنای باند «به اندازه کافی خوب» را با ظرفیت عظیم ترجیح میدهند تا عملکرد افراطی و هزینه سرسامآور شتابدهندههای مبتنی بر HBM. این رویکرد مانع ورود برای ابرهای حاکمیتی و استقرارهای دولتی را کاهش میدهد که به شتابدهندههای غنی از حافظه نیاز دارند اما نمیتوانند تجهیزات مرکز داده خود را ارتقا دهند.
این تغییر نشان میدهد صنعت از عصر «زور خالص» در آموزش، به عصر عاملهای هوشمند، بهینه و پایدار وارد شده است. برنده این میدان کسی نیست که بالاترین TFLOPS را دارد، بلکه کسی است که بیشترین توکن را در هر وات در یک رک استاندارد سرو میکند.
برای اینکه بدانید این محصول چگونه در نقشه راه شما جای میگیرد، باید بنچمارکهای آتی D270 در برابر RTX Pro 6000 را دنبال کنید. پیشبینیهای عملکرد در برابر RTX Pro 6000 بر اساس تحلیلهای داخلی تا فوریه ۲۰۲۶ است، هرچند عملکرد واقعی بسته به کاربرد و پیکربندی متفاوت خواهد بود.
گام بعدی شما
- اگر در حال طراحی زیرساخت برای عاملهای هوش مصنوعی هستید، توازن بین پهنای باند و ظرفیت حافظه در اولویت قرار دهید.
- بنچمارکهای آتی D270 در برابر RTX Pro 6000 را دنبال کنید تا میزان کاهش هزینه استنتاج را بسنجید.
- بررسی کنید که آیا گردشکارهای شما به دلیل حجم KV Cache دچار تأخیر شدهاند یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو