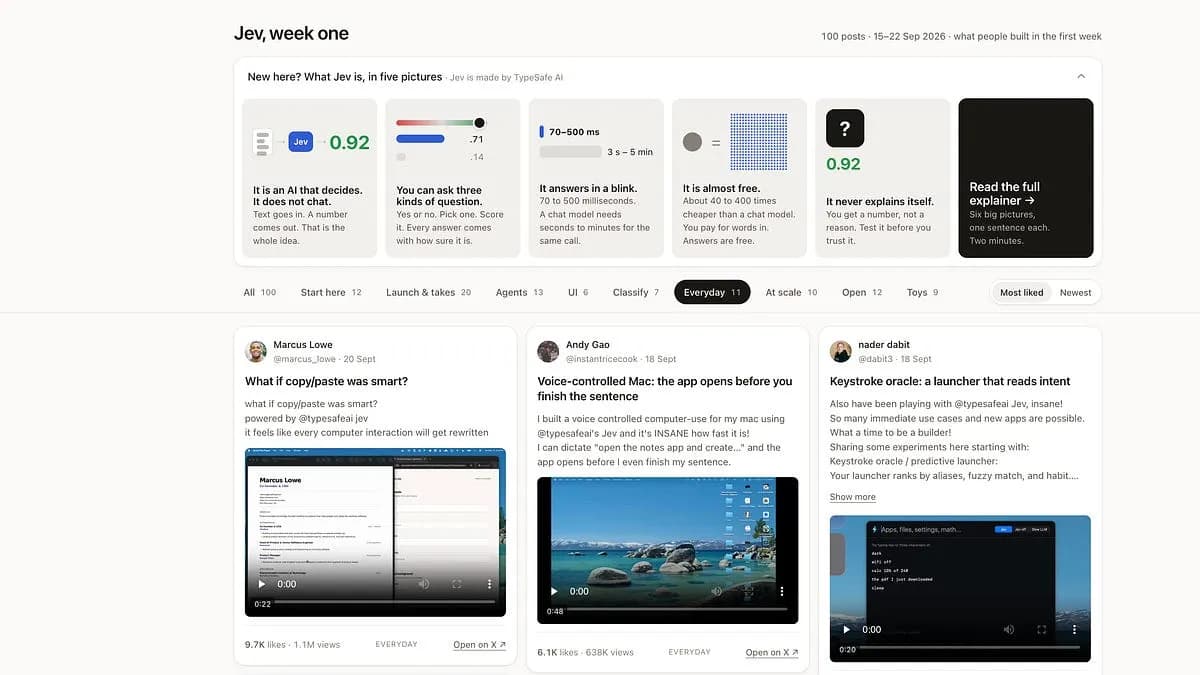
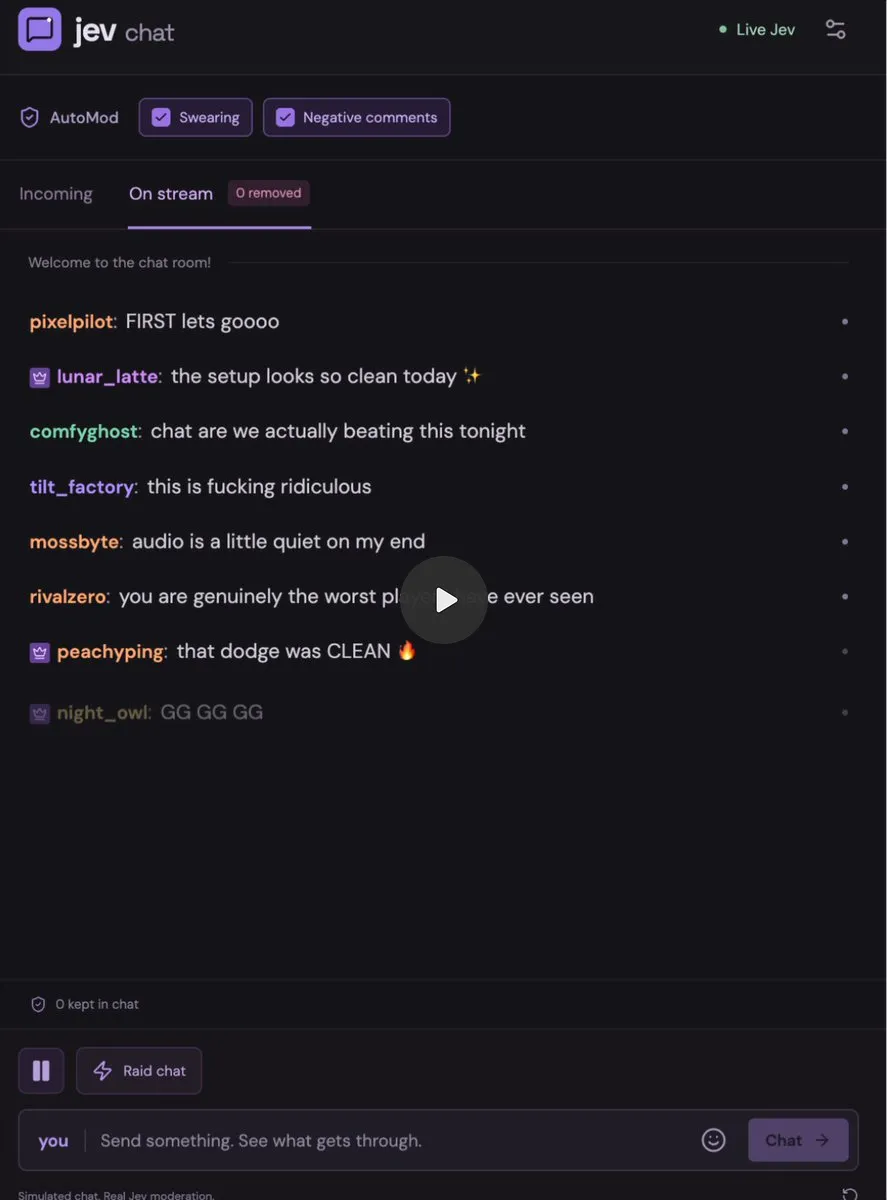
تصور کنید به جای یک مقالهٔ ۱۰ صفحهای دربارهٔ رنگ آسمان، فقط یک کلمه «بله» دریافت کنید. برای توسعهدهندگانی که به دنبال اجرای سریع دستورات در نرمافزار هستند، همین یک کلمه تفاوت بین یک ابزار کاربردی و یک چتبات کند است. در واقع، در حالی که مدلهای زبانی بزرگ (LLM) عمومی مانند استادانی هستند که مفاهیم را توضیح میدهند، نسل جدیدی از هوش مصنوعی متمرکز بر سازندگان به نام Jev مانند یک کلید برق عمل میکند و تمرکز را از گپوگفتهای محاورهای به توابع کاربردی با سرعت بالا تغییر میدهد. Jev پاسخهای فوری «بله/خیر» یا دستهبندیهای قطعی ارائه میدهد تا تعاملات نرمافزاری را تقویت کند. همانطور که آرون فرانسیس (Aaron Francis) توضیح میدهد، اگر از مادرتان بپرسید «آیا آسمان آبی است»، او بلافاصله میگوید «بله»؛ این یعنی Jev. اما اگر از پدرتان بپرسید «چرا آسمان آبی است»، او ده دقیقه صحبت میکند؛ این یعنی یک LLM استاندارد.
در دنیای فعلی، اکثر برنامهنویسان از مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — استفاده میکنند. اما مشکل اینجاست که این مدلها بیش از حد «پر حرف» هستند. توسعهدهندگان اغلب با پاسخهای طولانی و حاشیهای دستوپنجه نرم میکنند، در حالی که تنها به یک توکن (Token) — تکههای کوچکی از متن، شبیه برشهای یک کیک طولانی که مدل تکهتکه میخورد — برای فعال کردن یک دستور نرمافزاری نیاز دارند. پاسخهای طولانی مدلهای پیشرو باعث کندی و افزایش هزینه میشود. به همین دلیل مدل Jev معرفی شده است؛ ابزاری که بهطور خاص برای زندگی در دل اپلیکیشنهای دیگر ساخته شده و دقت و سرعت را بر گفتگو اولویت میدهد.
طبق گزارش Ben's Bites در ۲۲ سپتامبر ۲۰۲۶، مدل Jev با تمرکز بر خروجیهای ساختاریافته از LLMهای استاندارد متمایز میشود. این مدل برای چت کردن نیست، بلکه برای سازندگانی است که میخواهند آن را درون یک ابزار به کار بگیرند. Jev برای پاسخ به سوالات خاص و محدود طراحی شده است، مانند:
- طبقهبندی دوگانه (Binary Classification): پاسخهای بله/خیر (مثلاً: «آیا این متن یک تبلیغ است؟»)
- دستهبندی (Categorization): انتخاب از بین گزینههای مشخص (مثلاً: «این مورد به کدام پوشه تعلق دارد؟»)
- امتیازدهی (Scoring): اختصاص یک عدد به میزان مرتبط بودن یک نتیجه (مثلاً: «این نتیجه چقدر مرتبط است؟»)
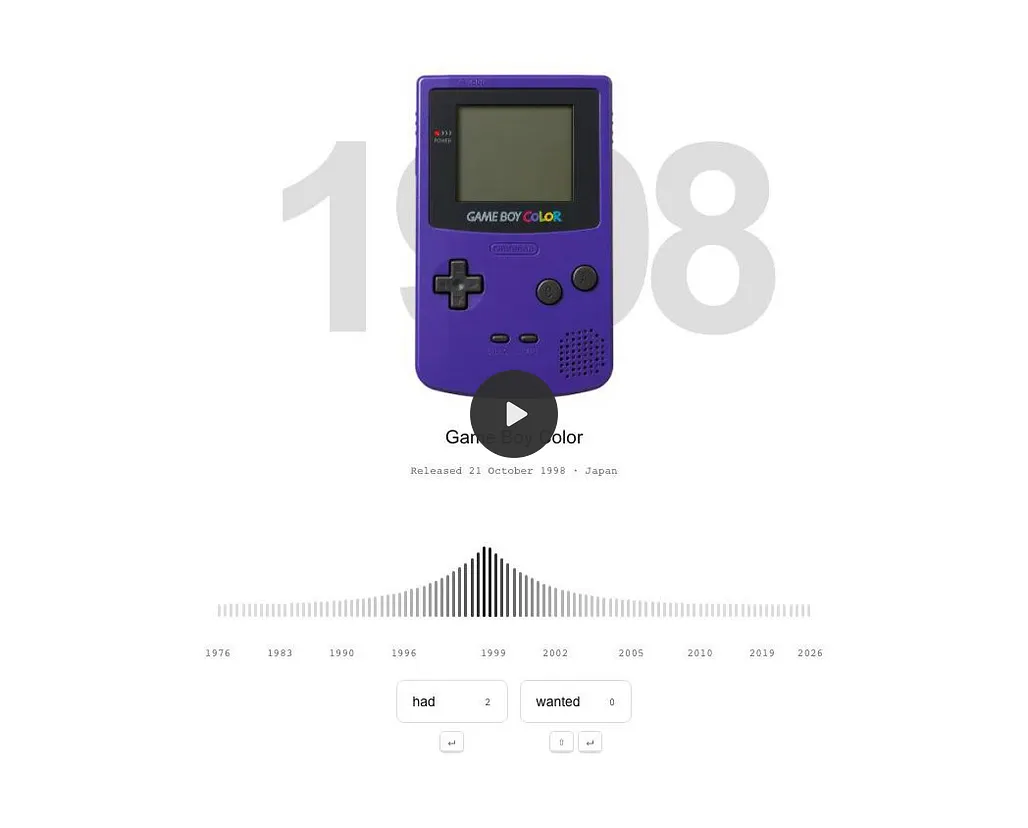
بر اساس بررسیهای اولیه، پذیرندگان زودرس از Jev برای ساخت افزونههای سبک و با کاربرد بالا استفاده میکنند. چون این مدل میتواند متن را پردازش کرده و یک تریگر (Trigger) ساده برگرداند، برای کارهایی که به سرعت در لحظه (Real-time) نیاز دارند ایدهآل است. نمونههایی از این کاربردها عبارتند از:
- بهینهسازی یوتیوب: افزونهای که بخشهای اسپانسر ویدیوها را بهطور خودکار شناسایی کرده و از آنها عبور میکند.
- مدیریت چت: فیلتر کردن نظرات منفی از یک چت در لحظه؛ موردی که اخیراً توسط Dev Ed به نمایش گذاشته شد.
- مدیریت ایمیل: جستوجوی جیمیل بر اساس «قصد کاربر» (Intent) یا فیلتر کردن لیستهای انجامکار (To-do lists) بهصورت هوشمندتر از جستوجوهای ساده بر اساس کلمات کلیدی.
علاوه بر فیلترهای ساده، Jev در حال قدرت بخشیدن به نسل جدیدی از تعاملات در سطح سیستمعامل است. این شامل تجربههای جدید و هوشمندتری از کپی-پیست، کشیدن و رها کردن (Drag-and-Drop) و قابلیت جستوجوی Cmd+F است. همچنین از این مدل برای کنترل مک از طریق صدا استفاده میشود. این اپلیکیشنها به زمان پاسخدهی تقریباً آنی نیاز دارند که Jev فراهم میکند؛ در حالی که استفاده از مدلهای پیشرو (Frontier Models) برای این کارها یا بسیار گران است یا بیش از حد کند.
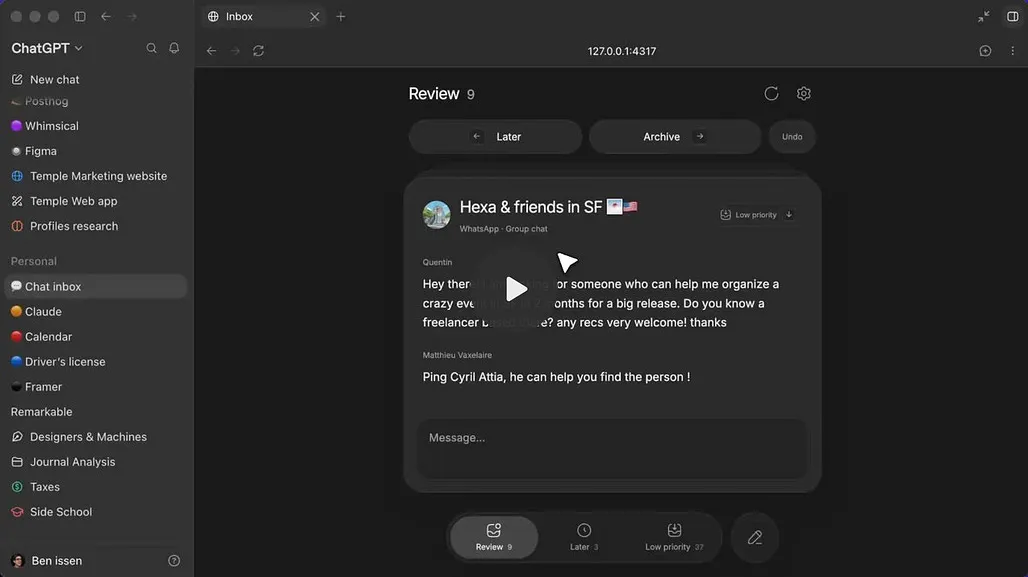
در حالی که Jev گیتهای منطقی را مدیریت میکند، مدلهای دیگر به سمت عاملهای (Agents) کامل پیش میروند. برای نمونه، Claude Code به سمت یک سیستم چت واحد (Master Chat) حرکت کرده است که ساختار پوشهای قدیمی را جایگزین میکند. در این سیستم، نیازمندیها، افکار و وظایف همگی در یک مکان ریخته میشوند و سپس هوش مصنوعی رشتههای (Threads) مجزایی را برای اجرای کارها ایجاد میکند. این رشتهها در حال حاضر به صورت جلسات ابری (Cloud Sessions) اجرا میشوند، هرچند انتظار میرود بهزودی پشتیبانی محلی (Local) نیز اضافه شود. این تغییر در حال حاضر در نسخه بتا است.
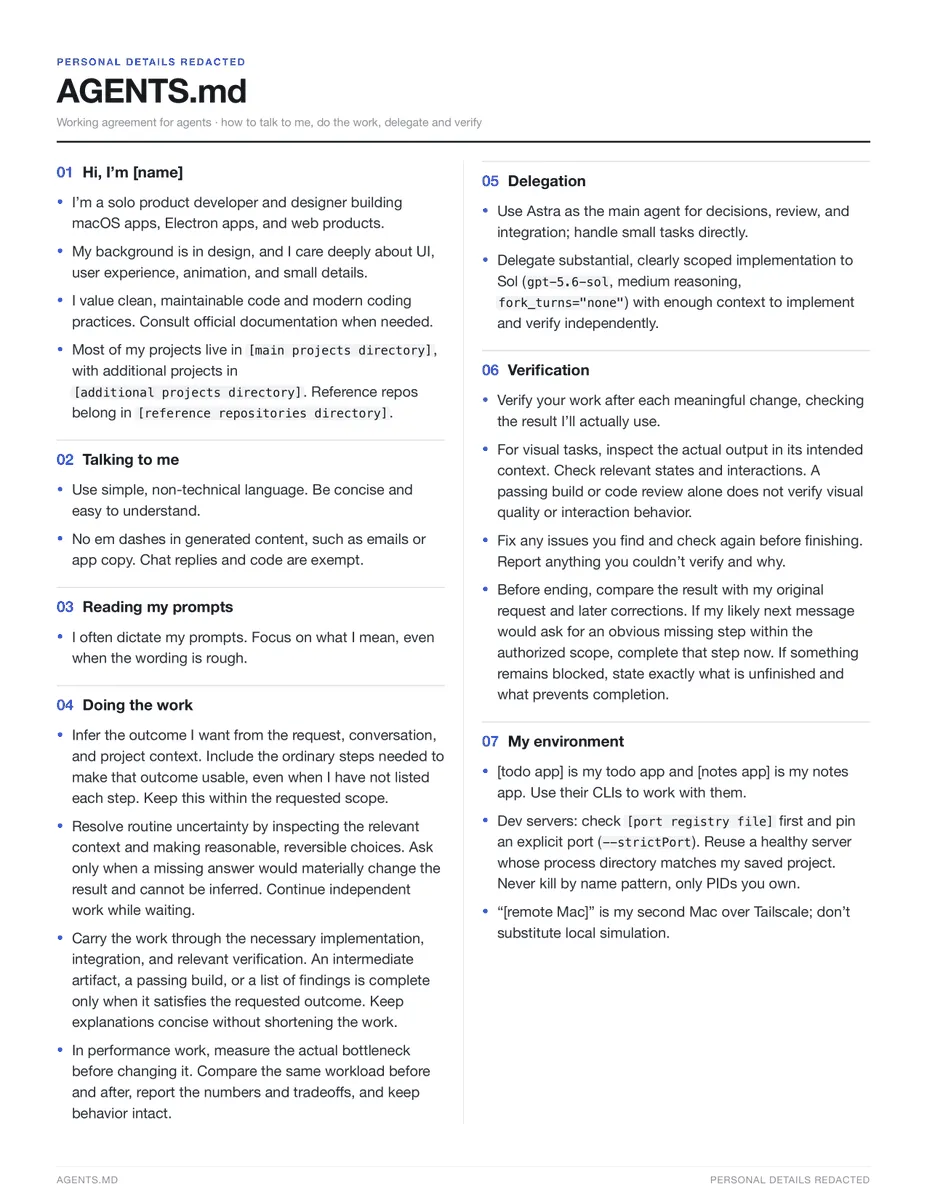
همچنین Claude Code اکنون از طریق ویژگی جدیدی به نام Claude Mods، از فایل AGENTS.md پشتیبانی میکند. این قابلیت به کاربران اجازه میدهد دستورالعملهای خاصی را برای هدایت رفتار عاملها ارائه دهند. برخی کاربران، مانند argofowl@، اشاره کردهاند که تغییر دادن فایل agents.md باعث شده است مدل Astra عملکرد پایدارتر و محکمتری نسبت به Fable 5.1 داشته باشد.
در همین راستا، Meta در حال گسترش عامل شخصی خود به نام Muse است که بهشدت از OpenClaw الهام گرفته شده است. Muse دارای یک اپلیکیشن مک و یک پلتفرم توسعهدهنده برای ساخت کانکتورهاست که به کاربران اجازه میدهد سرویسهای خارجی را ادغام کنند. اگرچه آمازون در ابتدا قابلیت خرید در Muse را مسدود کرده بود، اما متا از طریق مشارکت با Shopify در حال حل این مشکل است.
در بخش مدلهای پیشرو، Grok 4.7 با نتایج متناقضی عرضه شده است. در حالی که این مدل در بنچمارکها از GPT-5.6-Sol و Opus 5 پیشی گرفته است، اما برای دستیابی به این نتایج توکنهای بسیار بیشتری مصرف میکند. این ناکارآمدی باعث کاهش بهرهوری هزینهای آن شده و منجر شده تا برخی کاربران آن را ضعیفتر از Grok 4.6 بدانند.
برای توسعهدهندگان عاملهای صوتی، Speechmatics مدل Agent STT را معرفی کرده است که توسط Linden پشتیبانی میشود؛ یک مدل تبدیل گفتار به متن (Speech-to-Text) که بهطور اختصاصی برای عاملهای صوتی ساخته شده است. قیمت این سرویس ۰.۳۰ دلار در ساعت (۰.۱۵ دلار پس از تخفیفها) است که آن را ۲۵٪ ارزانتر از Deepgram Flux میکند. توسعهدهندگان میتوانند از طریق Pipecat، LiveKit یا API مستقیم Speechmatics به آن دسترسی داشته باشند.
بر اساس تجربه توسعهدهندهای به نام Hassan (@nutlope)، رویکرد جدید ساخت نرمافزار به یک «کارخانه نرمافزاری» تبدیل شده است که شامل یک فرآیند چهار مرحلهای است:
۱. جمعآوری (Collection): گردآوری ایدهها و الهامات در طول هفته.
۲. رتبهبندی (Ranking): استفاده از یک عامل در آخر هفته برای رتبهبندی بهترین ایدهها.
۳. تولید (Production): فعال کردن ۵ تا ۱۰ عامل موازی برای ساخت نمونههای اولیه (POC).
۴. حذف (Culling): حذف تقریباً ۶۰٪ از پروژهها و تکرار و بهبود روی ۲ یا ۳ دموی نهایی و مستحکم.
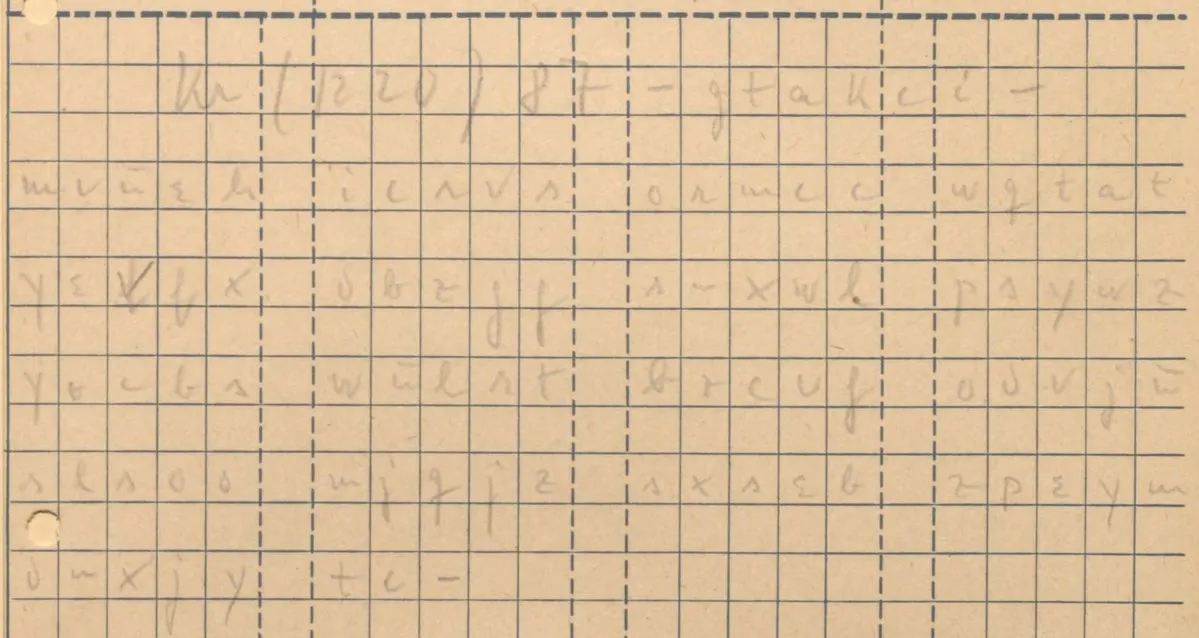
از دیگر دستاوردهای اخیر میتوان به GPT-6 Astra اشاره کرد که گزارش شده توانسته است یک پیام رمزنگاریشده ارتش آلمان از سال ۱۹۴۱ (Enigma) را که دههها حلنشده بود، رمزگشایی کند. Astra بهطور خودکار آرشیوهای تاریخی را جستوجو کرد، حروف نامطمئن را مقایسه نمود، سرنخهای زمینهای یافت، یک شبیهساز Enigma ساخت و کدهای تحلیل رمز موازی را نوشت و اجرا کرد.
در نهایت، گرایشی فزاینده به سمت سیستمعاملهای محلی (Local-first) دیده میشود. Underdog نمونهای بارز است؛ این ابزار به عنوان یک مینی-سیستمعامل برای ایمیلها، تقویمها و اپلیکیشنها عمل میکند و از مدلهای محلی استفاده میکند تا تضمین شود هیچ دادهای به هیچ کجا ارسال نمیشود. این موضوع بازتابدهنده یک تغییر گستردهتر است که در آن کاربران در حال حذف کلاینتهای سنتی ایمیل هستند. برخی کاربران اکنون تمام iMessageها و ایمیلهای خود را از طریق یک رابط عامل واحد مدیریت میکنند و با Gmail به جای یک اپلیکیشن اصلی، به عنوان یک پایگاه داده ساده برخورد میکنند.
این تغییر به سمت مدلهای تخصصی و سریع مانند Jev و سیستمعاملهای محلی نشان میدهد که عصر «یک مدل برای همه کارها» به پایان رسیده است. ما در حال ورود به دوره «ارکستراسیون هوش مصنوعی» هستیم؛ جایی که یک مدل سریع منطق را مدیریت میکند، یک مدل استدلالی برنامهریزی را بر عهده دارد و یک مدل محلی حریم خصوصی را تضمین میکند.
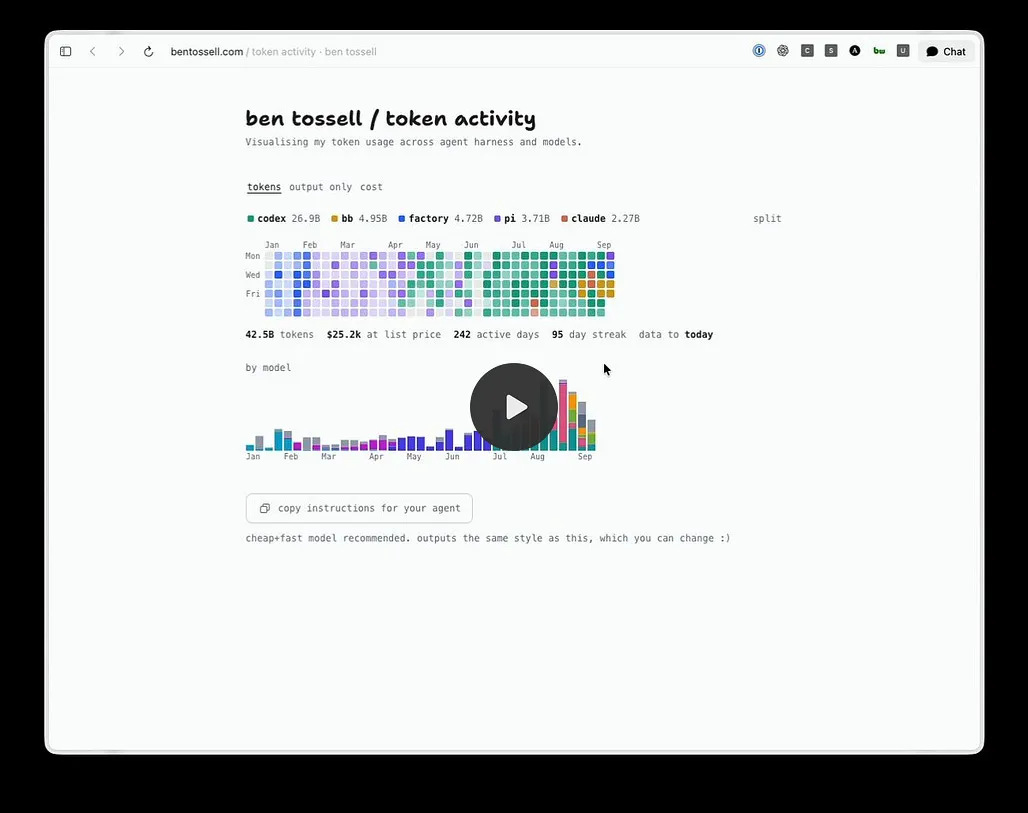
برای مشاهده این تحول در عمل، میتوانید سایت «دستگاههای فراموششده» (forgotten devices) ساخته بن توسیل را بررسی کنید. این پروژه ۵۰ سال از دستگاهها — از جمله Tamagotchi, Furby, Walkman و پلیاستیشن ۱ — را به نمایش گذاشته و از Astra برای تولید تصاویر و از یک مهارت عاملی (Agent Skill) برای ساخت ویدیوهای دمو با زوم و نریشن صوتی استفاده کرده است. این نوع تلفیق ابزارهای هوش مصنوعی برای خلق تجربههای بصری، یادآور پروژه موزه سه-بعدی Loupe است که با ترکیب Claude و Codex ساخته شد تا مرزهای تولید محتوای تعاملی را جابهجا کند.
گام بعدی شما
- اگر در حال توسعه ابزاری هستید که نیاز به پاسخهای بله/خیر سریع دارد، به جای LLMهای عمومی از مدلهای تخصصی طبقهبندی استفاده کنید.
- برای کاهش هزینه API، توابع ساده را از مدلهای پیشرو جدا کرده و به مدلهای کوچکتر (SLM) منتقل کنید.
- ساختار
AGENTS.mdرا برای شخصیسازی رفتار عاملهای خود در Claude Code بررسی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو