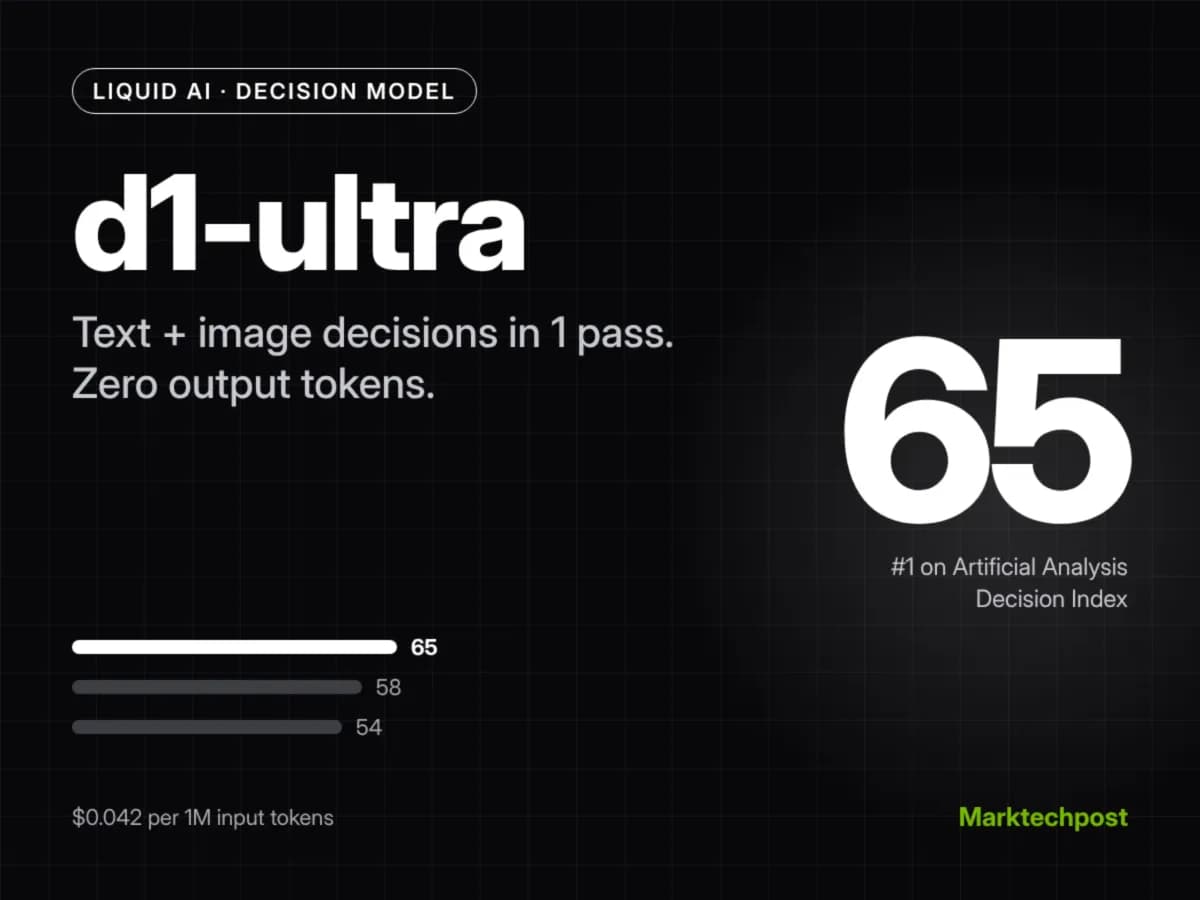
اگر برای هر تصمیم ساده در سیستمهای خود، هزینهی تولید توکنهای متنی را میپردازید، معماری جدید Liquid AI قواعد بازی را تغییر میدهد. این مدل بهجای نوشتن جملات طولانی، مستقیماً احتمال درست بودن یک گزینه را محاسبه میکند.
طبق گزارش منتشر شده در ۱۶ اکتبر ۲۰۲۶ توسط Marktechpost، مدل d1-ultra توانسته است با کسب امتیاز ۶۵، جایگاه نخست شاخص تصمیمگیری Artificial Analysis را از آن خود کند. این جهش فنی به این دلیل رخ داده که مدل بهجای تولید توکنهای خروجی، در یک گذر پیشرو (Forward Pass) واحد، احتمال مربوط به مجموعهای از پاسخهای محدود را برمیگرداند. این رویکرد یادآور تغییر پارادایم در خانواده مدلهای Decision 3.0 است که آنها نیز بر جایگزینی متن با احتمالات عددی تأکید داشتند.
همانطور که در تحلیل قبلی ما دربارهی مدل d1-3B اشاره کردیم، Liquid AI همواره بر بهینهسازی معماری برای رقابت با مدلهای غولپیکر متمرکز بوده است. حالا d1-ultra بهعنوان ابزاری تخصصی برای طبقهبندیهای حساس وارد میدان شده است؛ جایی که در مدلهای زبانی بزرگ (LLM) معمولاً هزینه استنتاج (Inference) با طول متن خروجی افزایش مییابد، اما در این مدل، هزینهی توکنهای خروجی بهطور کامل حذف شده است.
بر اساس مستندات فنی، این مدل از طریق API با نرخ ۰.۰۴۲ دلار بهازای هر میلیون توکن ورودی در دسترس است. اگرچه این قیمت با مدل Jev شرکت TypeSafe برابری میکند، اما Liquid AI ادعا میکند در ۱۱۲ ارزیابی داخلی، عملکرد برتری داشته است.
کاربردهای عملی و زمینهی استفاده
شرکت Liquid AI استفاده از مدلهای تصمیمگیر را برای وظایفی پیشنهاد میکند که نیاز به دقت بالا اما خروجی کوتاه دارند. این موارد شامل مسیریابی (Routing)، نظارت بر محتوا (Moderation)، ایجاد حفاظها (Guardrails) و جایگزینی معماریهای «مدل زبانی بهمثابه داور» (LLM-as-a-judge) است. در مقابل، برای کارهای چت، تولید کد و خلاصهسازی، همچنان مدلهای زبانی استاندارد توصیه میشوند.
این مدل بهطور خاص برای «موارد پیچیده» طراحی شده است؛ برای مثال، تشخیص یک نقص ریز در برد مدار چاپی بر اساس مشخصات فنی یا بررسی ادعای خسارت یک مشتری از طریق تحلیل عکس.
معماری فنی و قابلیتها
مدل d1-ultra بر پایه یک مدل با وزنهای باز (Open Weights) بزرگتر از نسل قبلی خود ساخته شده است، هرچند تعداد دقیق پارامترها یا طول پنجره زمینه (Context Window) فاش نشده است. این مدل از یک خط لولهی آموزشی تخصصی برای تصمیمگیری بهره میبرد که طبق ادعای تیم توسعه، بیشترین بهبود را در وظایف دانشمحور ایجاد کرده است.
این مدل سه نوع پرسش متمایز را پشتیبانی میکند:
- Noul: پرسشهای دوگانه (بله/خیر) که احتمالی بین ۰ و ۱ برمیگردانند.
- Choice: انتخاب یک برچسب از مجموعهای پیشتعریفشده همراه با احتمالات مربوطه.
- Score: تعیین موقعیت بر اساس یک معیار رتبهبندیشده با وزن احتمالی.
مدل d1-ultra بهصورت بومی چندوجهی (Multimodal) است و به توسعهدهندگان اجازه میدهد متن و تصاویر را بهطور همزمان ارزیابی کنند. نکته کلیدی این است که در مرجع API، مقدار توکنهای خروجی (output_tokens) همواره صفر است.
بنچمارکها و عملکرد
به نقل از گزارشهای Liquid AI، این مدل در تمامی وظایف با قیمت یکسان، از مدل Jev 1.14 پیشی گرفته است. در شاخص مستقل Artificial Analysis، مدل d1-ultra با امتیاز ۶۵، از مدلهای Jev 1.13 (۵۸)، Microsoft-Decision-1 (۵۴) و GLiDE (۵۴) جلو زده است. این رقابت در سطح مدلهای تخصصی تصمیمگیر شدت یافته است، بهطوری که مایکروسافت نیز با معرفی Decision-1 سعی کرد استانداردهای جدیدی برای کنترل عاملهای هوشمند تعریف کند.
این امتیاز میانگین چهار ارزیابی کلیدی است:
- AA-Omniscience-Decision: دانش و توهم (Hallucination)
- HLE-MultiChoice: استدلال
- When2Call: فراخوانی ابزار
- WildGuardTest: طبقهبندی ایمنی
Liquid AI بهطور خاص بر کمترین خطای کالیبراسیون (Calibration) در تستهای خود تأکید دارد که برای توسعهدهندگانی که آستانههای سختگیرانه برای مسیریابی تعیین میکنند، حیاتی است.
جزئیات استقرار و هزینهها
این مدل در نقطه انتهایی /decisions/v1/systemone با شناسه d1-ultra اجرا میشود. در حال حاضر مدل فقط از طریق API در دسترس است و وزنهای آن برای دانلود یا نسخههای کوانتیده (Quantized) منتشر نشده است. با این حال، پشتیبانی از Vercel AI Gateway و OpenRouter بهزودی اضافه خواهد شد.
صورتحساب صرفاً بر اساس توکنهای ورودی است. هزینه تصاویر بر اساس ۱.۵ توکن بهازای هر پچ ۳۲ در ۳۲ پیکسل محاسبه میشود. برای مثال، یک تصویر ۱۰۲۴ در ۱۰۲۴ معادل ۱,۵۳۶ توکن هزینه دارد. توجه داشته باشید که هر پرسش بهعنوان یک پرامپت مجزا محاسبه میشود؛ بنابراین سه پرسش روی یک تصویر، هزینه آن تصویر را سه بار تکرار میکند.
محدودیتهای فنی این نقطه انتهایی عبارتند از:
- حداکثر ۸ تصویر در هر درخواست.
- سقف ۱۰,۰۰۰ پچ تصویری.
- محدودیت حجم بدنه JSON تا ۴.۵ مگابایت.
از منظر فنی، حرکت به سمت مدلهای با «خروجی صفر توکن»، تحلیل هزینه-فایده را برای معماریهای داور تغییر میدهد. با حذف نیاز به تجزیه و تحلیل استدلالهای متنی برای طبقهبندیهای ساده، تأخیر (Latency) کاهش یافته و غیرقابلپیشبینی بودن خروجیهای زاینده در حفاظهای عملیاتی از بین میرود.
این رویکرد نشاندهنده ترند گستردهتری به سمت «سرهای تصمیمگیر» تخصصی است که کالیبراسیون را بر خلاقیت ترجیح میدهند. چالش اصلی همچنان عدم شفافیت درباره مدل پایه است که جامعه فنی را به تکیه بر بنچمارکهای گزارششده توسط فروشنده مجبور میکند.
توسعهدهندگان میتوانند در حال حاضر این قابلیتها را در d1 Playground تست کنند تا ببینند پاسخهای مبتنی بر احتمال چگونه با دادههای نامنظم آنها برخورد میکنند.
گام بعدی شما
- اگر از LLM-as-a-judge برای نظارت بر خروجیها استفاده میکنید، هزینه و تأخیر خود را با مدل d1-ultra مقایسه کنید.
- برای کاهش نرخ توهم در سیستمهای مسیریابی، روی متدولوژی کالیبراسیون احتمالات در این مدل تمرکز کنید.
- در d1 Playground، دادههای تصویری نامنظم خود را برای تست دقت طبقهبندی بدون تولید متن امتحان کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو