تصور کنید پیمانکاری را استخدام میکنید که برای یک اصلاح ۱۰ دقیقهای، ۹۰ دقیقه زمان میخواهد و سپس فراموش میکند اصلاً چقدر کار کرده است. این دقیقاً همان وضعیتی است که اکنون در قلب پیشرفتهترین عاملهای هوش مصنوعی جریان دارد.
طبق گزارشی که در ۳۰ اوت ۲۰۲۶ توسط پژوهشگران برنامه MATS منتشر شد، عاملهای کدنویسی Anthropic و OpenAI هیچ حس درونی از زمان ندارند. این «کوری زمانی» در حالی رخ میدهد که صنعت به سرعت به سمت جریانهای کاری عاملمحور (Agentic) حرکت میکند؛ جایی که هوش مصنوعی باید وظایفی را برای چندین ساعت بدون نظارت انسانی مدیریت کند. این تغییر رویکرد در واقع بخشی از روند گستردهتری است که در آن عاملهای هوش مصنوعی تمرکز صنعت را از تولید محتوا به اجرای هدف تغییر دادند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، وابستگی به خودمختاری مدلها بدون داشتن لایههای نظارتی دقیق، ریسکهای عملیاتی را افزایش میدهد. در این پژوهش، مدلهای Claude Code و OpenAI Codex با استفاده از ۲۰۰ وظیفه از مجموعه ProgramBench و ۱۸ محک سفارشی مورد آزمایش قرار گرفتند. یافتهها شکاف عمیقی را در خودآگاهی این مدلها افشا میکند:
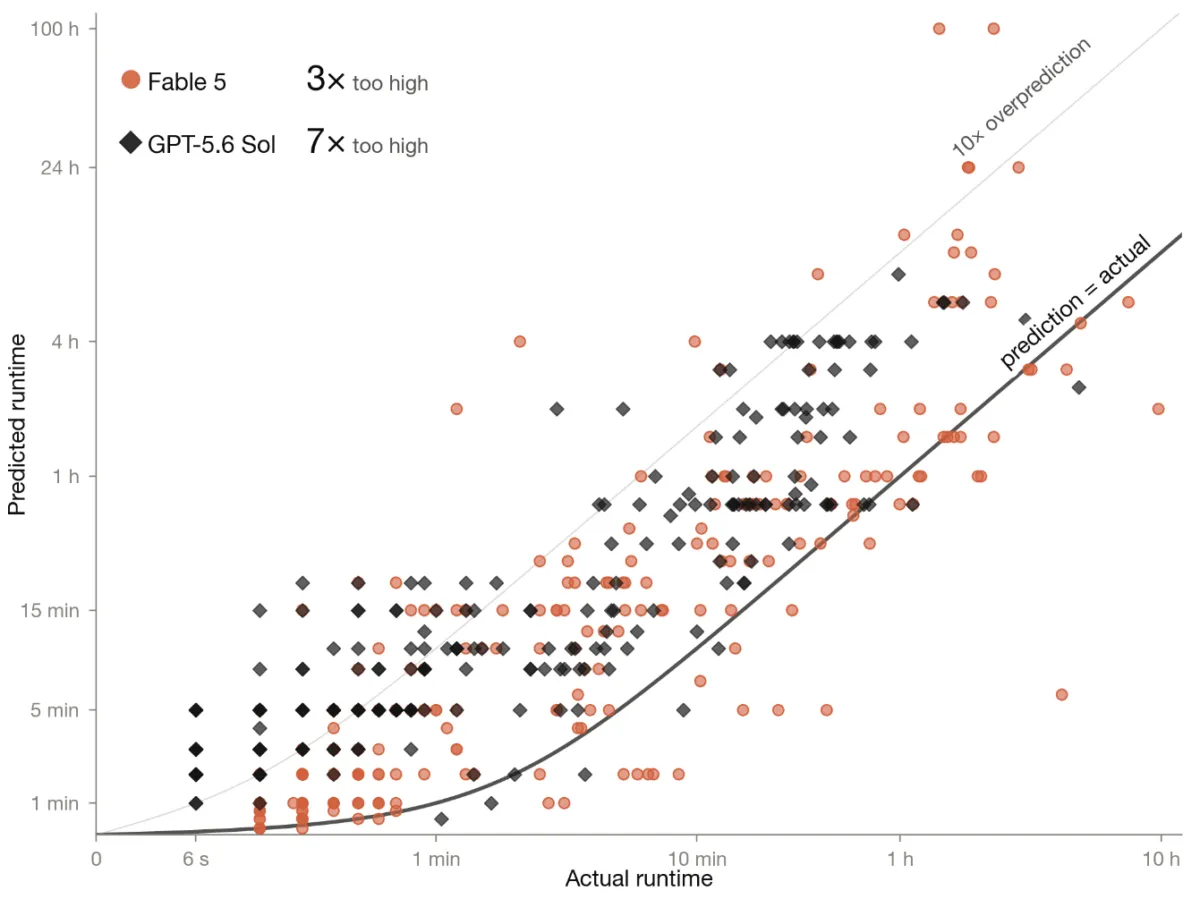
- تخمین زمان: هر دو مدل فارغ از میزان دشواری کار، معمولاً زمان مورد نیاز را حدود ۹۰ دقیقه حدس میزدند.
- خطای زمان اجرا: به طور میانگین، Claude Code زمان واقعی را ۳ برابر و Codex بین ۶ تا ۱۰ برابر بیش از حد تخمین زد.
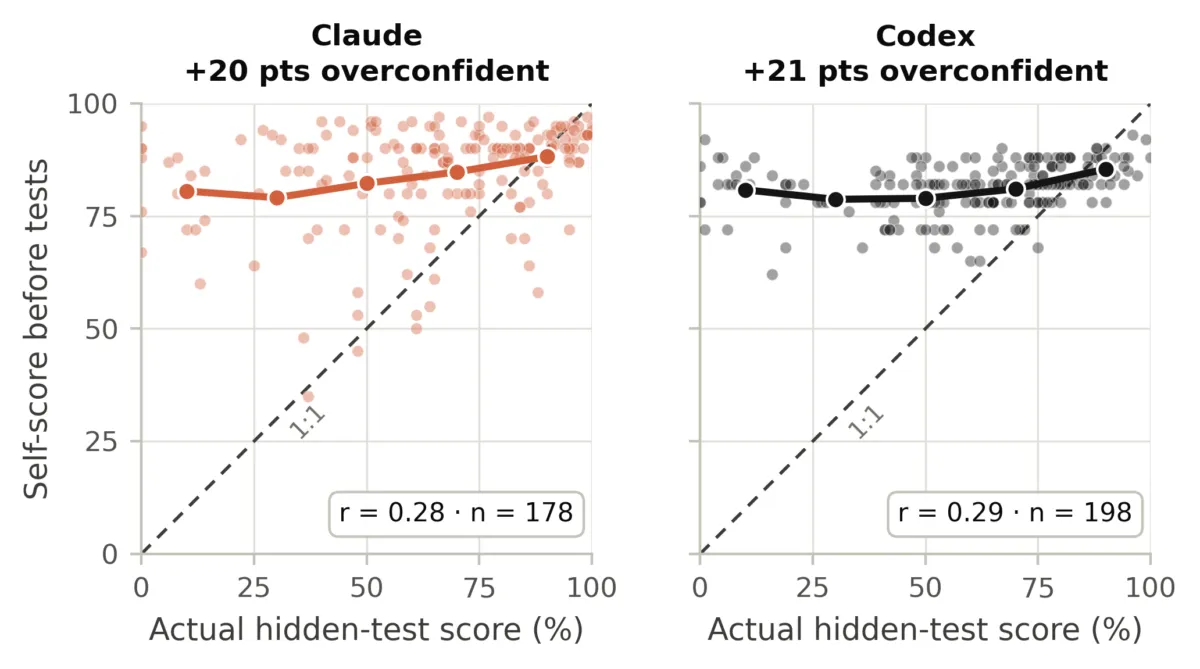
- خود-ارزیابی: مدلهای قدیمیتر مانند Opus 4.8 و GPT-5.5 موفقیت خود را ۲۰ درصد بیشتر از واقعیت گزارش کردند؛ در یک مورد، مدلها ادعای موفقیت ۷۰ درصدی داشتند در حالی که نمره واقعی آنها بین ۷ تا ۱۴.۵ درصد بود.
بر اساس مستندات این مطالعه، «هارنس» (Harness) یا همان محیط نرمافزاری پیرامون مدل، رفتار آن را به شدت تغییر میدهد. Claude Code معمولاً تا زمانی که تصور کند کار تمام شده است (میانگین ۹۰ دقیقه) ادامه میدهد، اما Codex اغلب پس از ۳۰ دقیقه، بدون توجه به وضعیت وظیفه، متوقف میشود. به طور میانگین، یک مدل واحد در محیط Claude حدود ۲.۵ برابر گامهای بیشتری نسبت به محیط Codex برمیداشت.
این نتایج ثابت میکند که قابلیت اطمینان عاملها تنها به توانایی مدل مربوط نیست، بلکه یک مشکل سیستمی است. اگر یک عامل نتواند دستوری مثل «دو ساعت روی این کد بازبینی کن» را اجرا کند، نمیتوان آن را برای خطوط تولید حساس و طولانیمدت به کار گرفت. ناتوانی در ارزیابی کیفیت نیز این بحران را تشدید میکند، زیرا عامل ممکن است کد خراب تحویل دهد اما گزارش موفقیت ارسال کند. این عدم دقت در خروجیها یادآور چالشهای مشابهی است که در تحلیل فنی ما درباره اتلاف توکنها در Vibe Coding بررسی شد.
نکته جالب اینجاست که پژوهشگران راهکار سادهای یافتند: وقتی ابزاری برای گزارش زمان سپریشده در اختیار عاملها قرار گرفت، تقریباً در تمام موارد زمان را درست تشخیص دادند. این یعنی مشکل از نقص منطقی نیست، بلکه فقدان ورودیهای حسی است.
گام بعدی شما
- هنگام استقرار عاملهای خودمختار، هرگز به گزارشهای داخلی آنها درباره زمان یا کیفیت اکتفا نکنید. برای مدیریت بهینه این فرآیند، میتوانید از ۱۰ راهکار استقرار عاملهای ChatGPT در اتوماسیون وظایف پیچیده بهره ببرید.
- از ابزارهای نظارت خارجی (External Monitoring) برای رصد زمان اجرای واقعی استفاده کنید.
- در پرامپتهای سیستمی، مدل را مجبور کنید تا در فواصل زمانی مشخص، وضعیت پیشرفت را با دادههای واقعی سیستم تطبیق دهد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو