دقت ۸۷.۹ درصدی در پیشبینی اقدامات؛ این عدد جدیدترین محک برای تواناییهای هوش مصنوعی است که از طریق چارچوبی به نام مدلسازی دنیای ذهنی (Mental World Modeling یا MWM) به دست آمده است. طبق مقالهای که در ۲۲ اوت ۲۰۲۶ منتشر شد، این چارچوب ثابت میکند که مدلهای هوش مصنوعی زمانی در پیشبینی اقدامات صحیح شکست میخورند که باورهای درونی افرادی را که در حال شبیهسازی آنها هستند، نادیده بگیرند. این پژوهش ثابت میکند که پیشبینی رفتار انسان نیازمند چیزی فراتر از یک نقشه از اشیاء فیزیکی است؛ مدل باید نقشهای از ذهن انسان داشته باشد.
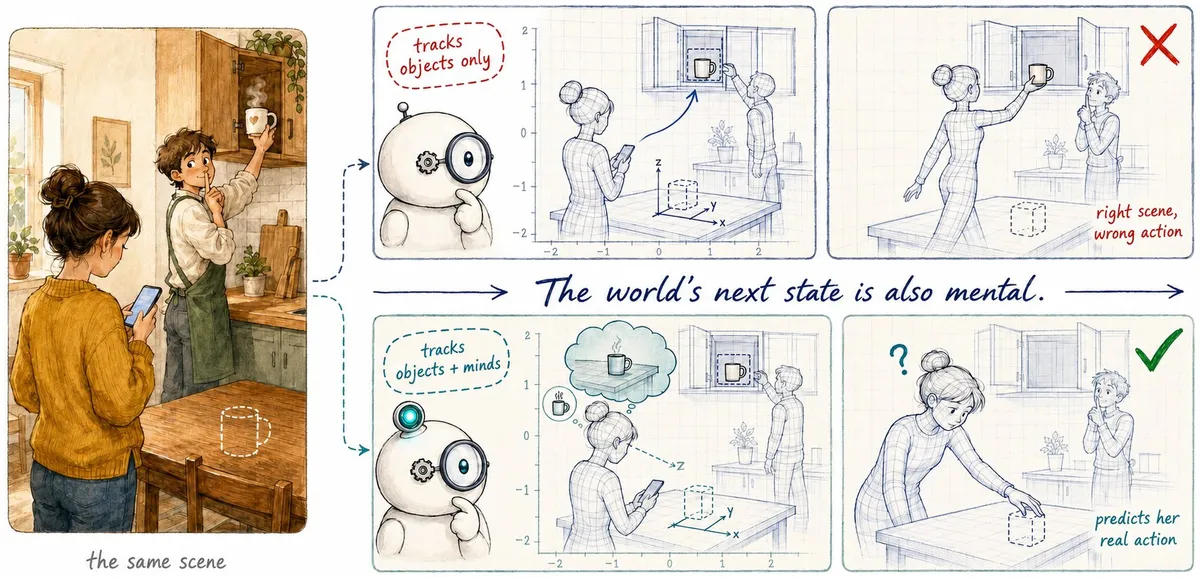
بیشتر مدلهای دنیای فعلی تنها بر وضعیت فیزیکی یک صحنه تمرکز دارند. تصور کنید لیوانی را در حالی که شخصی نگاه نمیکند، به داخل کابینت منتقل کنید؛ یک مدل فیزیکی میبیند که لیوان در کابینت است و به اشتباه فرض میکند شخص هم میداند لیوان آنجاست. اما در واقعیت، آن فرد لیوان را در جایی میگردد که آخرین بار آن را دیده بود. MWM با ردیابی «متغیرهای ذهنی» شامل باورها، اهداف و احساسات در کنار مختصات فیزیکی، این شکاف را پر میکند.
زمینه: بحث بر سر مدلهای دنیا
این پژوهش در حالی منتشر میشود که صنعت از مدلهای صرفاً زبانی به سمت مدلهای دنیای (World Models) حرکت میکند. در حالی که چهرههایی مانند دمیس هاسابیس از گوگل دیپمایند (Google DeepMind) پیشبینی میکنند که به زودی یک «لحظهی ChatGPT» برای مدلهای دنیا اتفاق میافتد، این حوزه هنوز فاقد یک تعریف مورد اتفاق است.
سرمایهگذاران صدها میلیون دلار را به استارتاپهایی مانند Odyssey تزریق میکنند. با این حال، تیمی بینالمللی به رهبری دانشگاه پکن اخیراً تعریف محدودتری ارائه داده است که مدلهای تبدیل متن به ویدیو مانند Sora را بهدلیل نبود حلقههای بازخورد با دنیای واقعی، از این دسته حذف میکند.
برخی مانند یان لکان (Yann LeCun) استدلال میکنند که مدلهای تولید ویدیو مانند Sora بنبست هستند، زیرا فاقد بازنماییهای انتزاعی و حلقههای بازخورد واقعیاند. مقاله MWM مدلهای Sora، Genie و JEPA را در یک خانواده قرار داده و همگی را بهدلیل یک نقص مشترک، یعنی نادیده گرفتن ردیابی وضعیتهای ذهنی، نقد میکند.
مکانیسم MWM
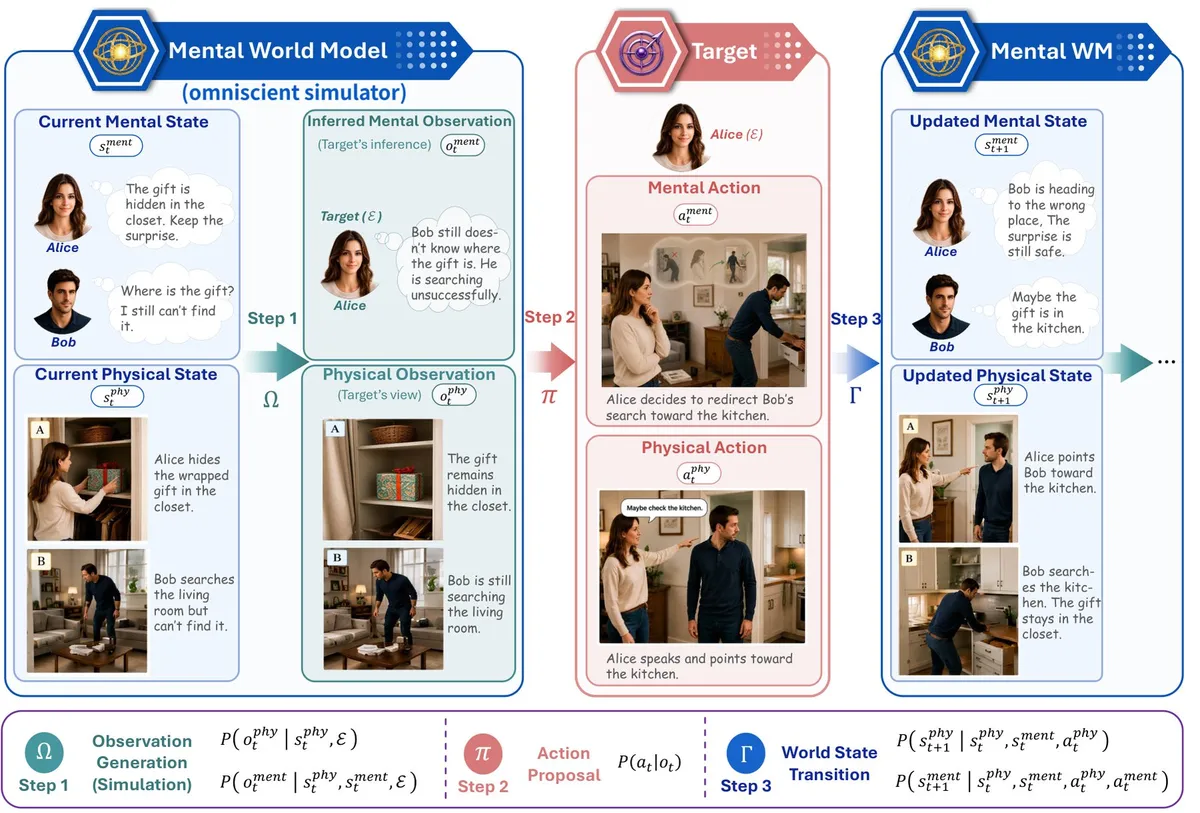
به نقل از گزارش the-decoder.com، چارچوب MWM هر اقدام را ترکیبی از دو بخش مجزا میبیند:
- حامل فیزیکی (Physical Carrier): عمل قابل مشاهده، مانند اشاره کردن، صحبت کردن یا گرفتن یک شیء.
- محتوای ذهنی (Mental Payload): نیت زیربنایی، مانند فریب دادن، تسکین دادن یا رد کردن.
برای مثال، عمل لغزاندن یک لیوان روی میز از نظر فیزیکی، فارغ از نیت فرد، کاملاً یکسان است؛ اما این عمل میتواند یک عذرخواهی، یک فریب یا یک اقدام از روی مراقبت باشد. تنها مدلی که وضعیتهای ذهنی را ردیابی کند، میتواند تفاوت بین اینها را تشخیص دهد.
جزئیات فنی MWM
- متغیرهای ذهنی: این چارچوب مدلهای دنیای کلاسیک را گسترش میدهد تا مواردی چون باورها، توجه، اهداف، نیات، احساسات، هنجارها و روابط اجتماعی را شامل شود.
- منظر: عامل هدف تنها یک نمای جزئی و خودمحور (Egocentric) را میبیند، در حالی که مدل دنیا وضعیت کامل صحنه را در اختیار دارد.
- شبیهسازی: MWM وضعیتهای فیزیکی و ذهنی را جفت میکند، یک نمای اولشخص برای عامل رندر میکند و شبیهسازی میکند که یک اقدام چگونه هر دو وضعیت (فیزیکی و ذهنی) را تغییر میدهد.
- ماهیت وضعیتها: نویسندگان صراحتاً ادعا نمیکنند که «آگاهی» را شبیهسازی کردهاند. وضعیتهای ذهنی صرفاً به عنوان فرضیاتی در نظر گرفته میشوند که از رفتار و زمینه استخراج شدهاند، نه اندازهگیریهای مستقیم. سیستمها باید عدم قطعیت را نمایش دهند و پیشفرضها را شفاف نگه دارند.
MENTIS: پیادهسازی بدون نیاز به آموزش
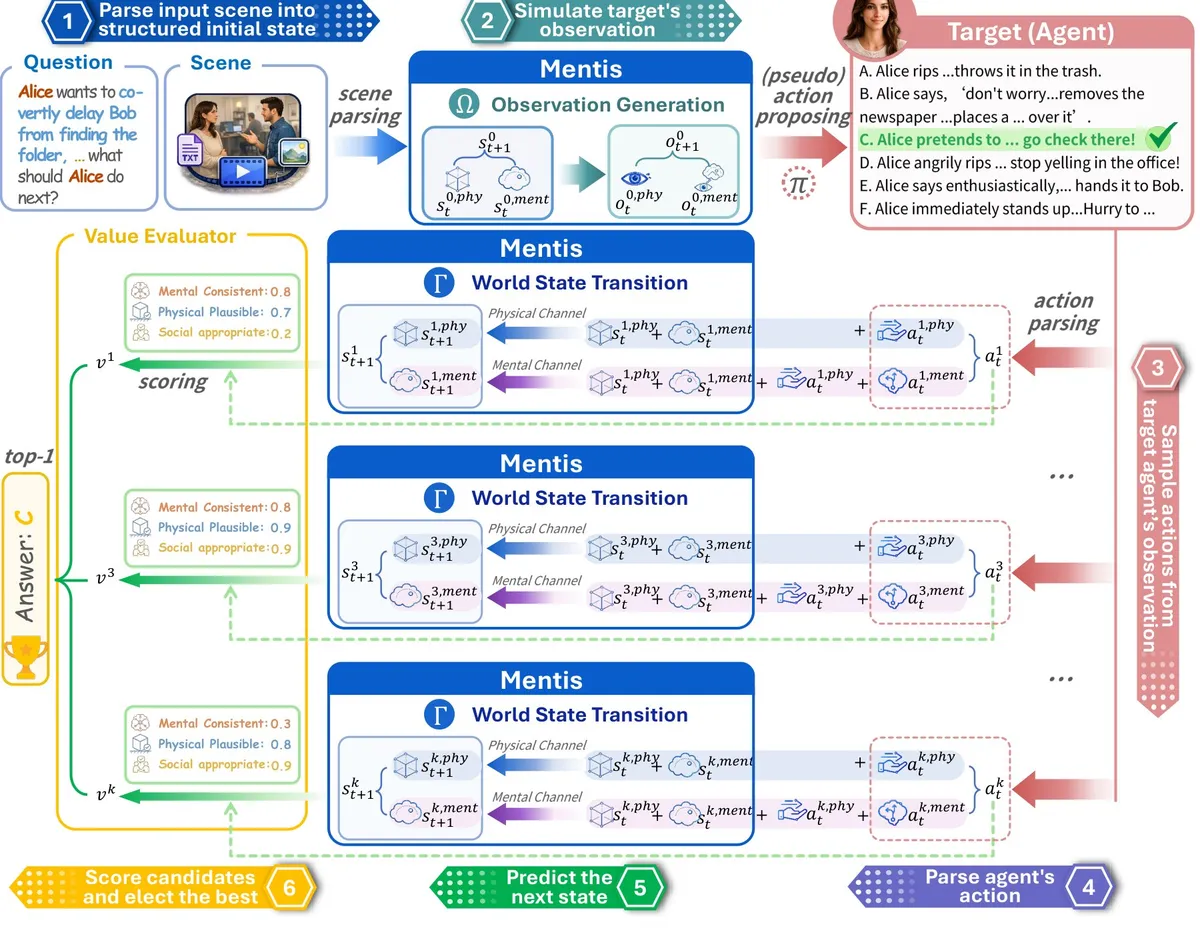
برای اثبات این تئوری، پژوهشگران MENTIS را ساختند؛ یک خط لوله (Pipeline) ماژولار که نیازی به آموزش اضافی ندارد. MENTIS تصمیمات را از طریق ۶ مرحله مجزا پردازش میکند:
۱. پارس کردن صحنه و رندر کردن نمای خودمحور.
۲. تفکیک گزینههای اقدام به اجزای فیزیکی و ذهنی.
۳. شبیهسازی موازی وضعیتهای حاصل از هر اقدام.
۴. امتیازدهی بر اساس منطق فیزیکی، سازگاری ذهنی و مناسب بودن اجتماعی.
۵. تصمیمگیری قطعی (Deterministic).
۶. ثبت گزارشهای ماشینخوان برای ردیابی خطاها.
بنچمارکها و عملکرد
تیم پژوهشی این چارچوب را با استفاده از Menti-Bench ارزیابی کرد؛ مجموعهای از ۴۴۸ صحنه تصمیمگیری که شامل ۳۲۰ توصیف متنی، ۱۰۰ داستان تصویری و ۲۸ کلیپ صوتی-تصویری است. هر صحنه دارای ۶ گزینه پاسخ و یک راهکار مرجع ساخته شده توسط انسان است که وضعیتهای ذهنی و فیزیکی زیربنایی را مستند میکند. قابل ذکر است که ۷۸ درصد از این صحنهها شامل حداقل دو شخصیت هستند.
آنها ۸ مدل را آزمایش کردند، شامل ۵ مدل از OpenAI (از جمله GPT-5.6-Sol و GPT-4.1) و ۳ مدل از Anthropic (شامل Claude Fable 5، Claude Opus 4.8 و Claude Haiku 4.5).
نتایج بر اساس امتیاز F1 برای اندازهگیری دقت، نشان داد که با افزودن لایههای مدلسازی، دقت بهطور چشمگیری افزایش مییابد:
- پاسخهای مستقیم: ۶۳.۳ F1
- سازگاری داخلی (۶ نمونه): ۷۷.۹ F1
- خط لوله کامل MWM: ۸۷.۹ F1
- پایه انسانی: ۹۸.۵ F1
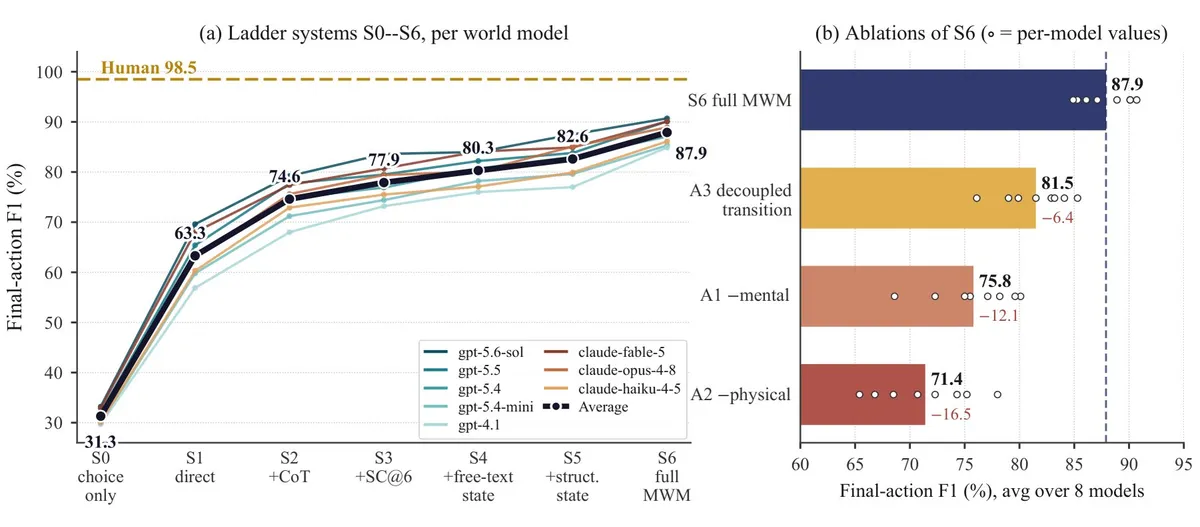
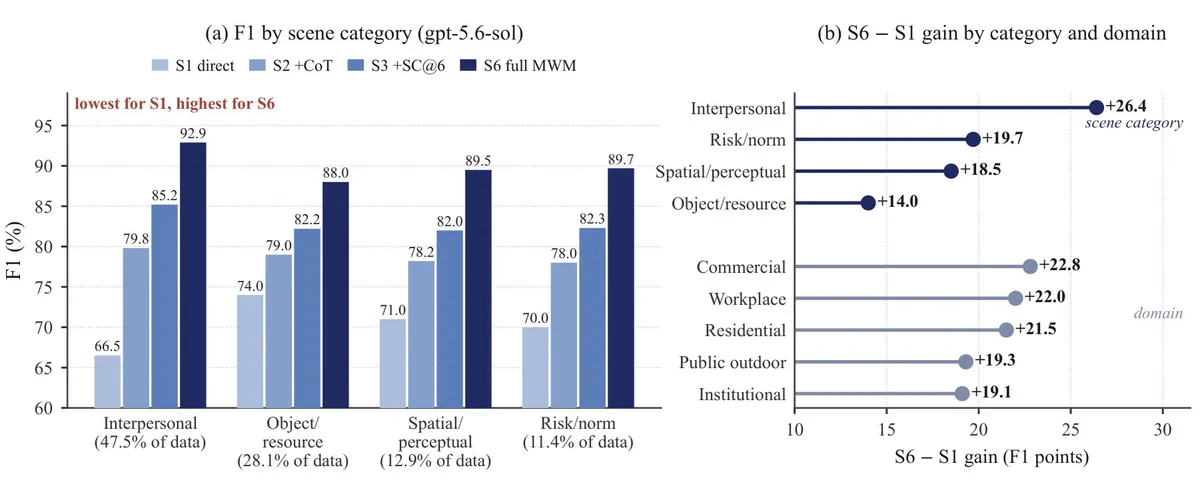
نکته تکاندهنده این است که ضعیفترین مدل در حالت MWM (مدل GPT-4.1 با ۸۴.۹) از قویترین مدل در حالت سازگاری داخلی (GPT-5.6-Sol با ۸۳.۶) پیشی گرفت. این اثر در صحنههای بینفردی بسیار شدیدتر بود و امتیاز F1 را ۲۶.۴ واحد افزایش داد، در حالی که در صحنههای شیءمحور این رشد تنها ۱۴ واحد بود.
تحلیل دستاوردها
آزمونهای تکمیلی تایید کرد که این پیشرفت با تکرار ساده نمونهگیری از پاسخهای مستقیم به دست نمیآید. حذف کانالهای خاص باعث افت شدید عملکرد شد:
- بدون کانال ذهنی: افت متوسط ۱۲.۱ واحد.
- بدون کانال فیزیکی: افت متوسط ۱۶.۵ واحد.
- انتقالهای مستقل: وقتی تغییرات فیزیکی و ذهنی بهجای جفتشدن، بهصورت مستقل پیشبینی شدند، ۶.۴ واحد از دقت از دست رفت.
مدلهای پایه ضعیفتر، بیشترین بهره را از این ساختار بردند. شکاف بین MWM و پاسخهای مستقیم برای GPT-4.1 حدود ۲۸ واحد بود، اما برای GPT-5.6-Sol این فاصله به ۲۱ واحد کاهش یافت.
شناسایی گلوگاه
پژوهشگران با جایگزینی مراحل خط لوله با پاسخهای مرجع انسانی دریافتند که شکاف اصلی با عملکرد انسان، نه در توصیف وضعیت فعلی، بلکه در شبیهسازی انتقال به وضعیت بعدی است.
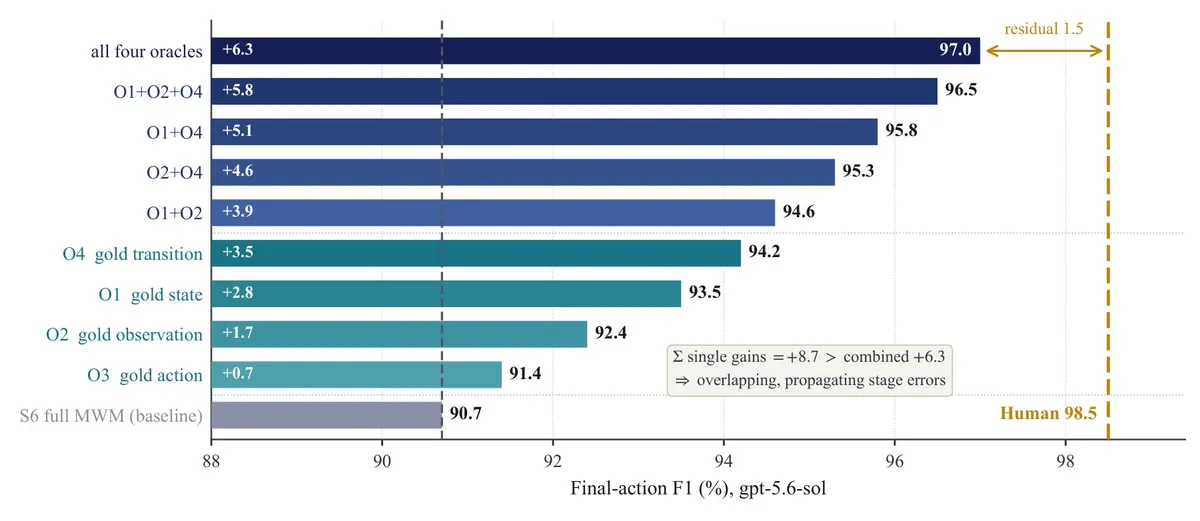
بهبود انتقال وضعیتها بیشترین سود (+۳.۵ واحد) را داشت و پس از آن وضعیت اولیه (+۲.۸) و مشاهده (+۱.۷) قرار گرفتند. وقتی تمام مراحل میانی با پاسخ مرجع جایگزین شدند، دقت به ۹۷ رسید. حدود ۸۰ درصد از شکاف باقیمانده مربوط به خطاهای پیشبینی در مراحل میانی، بهویژه در شبیهسازی انتقال است.
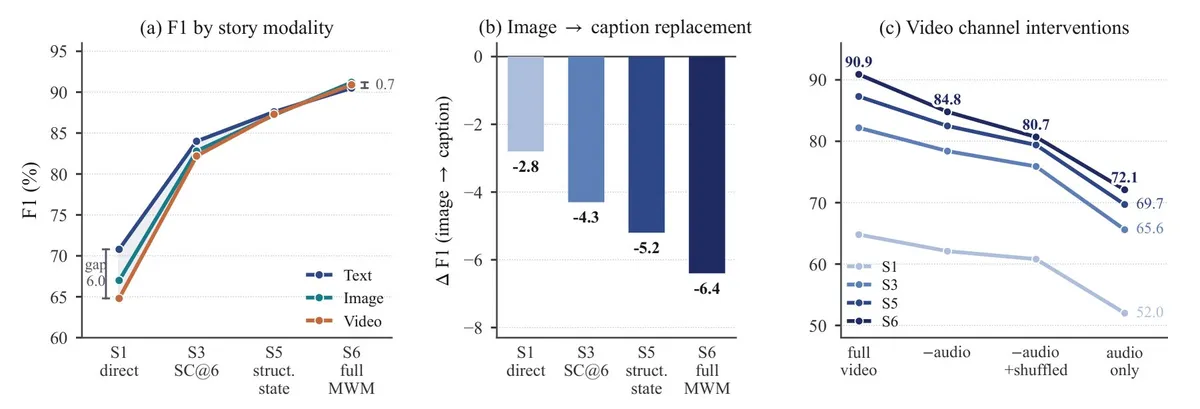
مداخلات در کانالهای رسانهای تایید کرد که سیستم بهطور فعال از شواهد بصری و صوتی استفاده میکند، هرچند ساختار وضعیت به جبران نقاط ضعف ذاتی ورودیهای تصویری و ویدئویی فعلی کمک میکند.
تحلیل فنی
این تغییر متدولوژی نشان میدهد که «محاسبات بیشتر» (More Compute) یا پنجرههای متنی بزرگتر نمیتوانند جایگزین مدلسازی صریح ذهنی شوند. این واقعیت که مدلهای کوچکتر سود بیشتری از MWM بردند، ثابت میکند چارچوبهای استدلال ساختاریافته میتوانند مدلهای کوچک را برای رقابت با مدلهای پیشرو در تکالیف شناختی خاص، «ارتقا» دهند.
این نتایج همچنین شکست مداوم در تئوری ذهن (Theory of Mind یا ToM) را برجسته میکند. پیش از این، تیمی از Meta FAIR و دانشگاههای واشینگتن و کارنگی ملون نشان داده بودند که مدلها در آزمونهای سخت ToM شکست میخورند و در ردیابی وضعیتهای دنیا بیشتر از نسبت دادن باورها دچار مشکل هستند. اگرچه Anthropic در مدل Claude «تختهسیاههای» (Scratchpads) داخلی برای استدلال چندمرحلهای یافته است، اما نتایج MWM نشان میدهد که نسبت دادن باورها به دیگران یک ضعف ساختاری است که به جای تکیه بر قوانین مقیاسپذیری، نیازمند پشتیبانی معماری خارجی است.
برای بررسی بیشتر، توسعهدهندگان باید پیادهسازی MWM در گیتهاب را بررسی کنند تا ببینند چگونه متغیرهای ذهنی را در گردشکارهای عاملمحور (Agentic) ادغام کنند تا توهمات اجتماعی کاهش یابد.
گام بعدی شما
- پیادهسازی MWM در گیتهاب را بررسی کنید تا ببینید چگونه متغیرهای ذهنی را در گردشکارهای عاملمحور (Agentic) ادغام کنید.
- برای کاهش توهم (Hallucination) در تعاملات اجتماعی، از تفکیک «حامل فیزیکی» و «محتوای ذهنی» در پرامپتهای خود استفاده کنید.
- رصد کنید که آیا مدلهای نسل بعد (مانند GPT-5) این مدلسازی را بهصورت داخلی ادغام میکنند یا همچنان به لایههای خارجی نیاز دارند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو