اگر امروز برای استقرار مدلهای زبانی در مقیاس سازمانی بودجهبندی میکنید، باید بدانید که تفاوت بین یک سیستم بهینه و یک سیستم هزینهبر، دیگر در تعداد توکنها نیست، بلکه در مدیریت ظرفیت است. کاهش ۱.۳۹ درصدی هزینههای سالانه در مدل GPT-5.6 Luna، تنها یک عدد کوچک نیست؛ بلکه نشانهای از تغییر پارادایم از «پرداخت بهازای مصرف» به «اجاره زیرساخت» است. این تغییر در استراتژی زیرساختی، تمرکز را از شمارش ساده توکنها به مدیریت ظرفیت برای هوش مصنوعی در سطح تولید (Production-grade) منتقل میکند. این روند بهینهسازی هزینهها در حالی رخ میدهد که کاهش چشمگیر هزینههای استنتاج در مدلهای سری Luna پیش از این توجه بسیاری از سازمانها را به بهرهبرداری گستردهتر از این مدلها جلب کرده بود.
هوش مصنوعی سازمانی از فاز آزمایشگاهی که در آن فراخوانیهای ساده API کفایت میکرد، عبور کرده است. در مقیاس بالا، نوسانات ظرفیتهای مشترک منجر به تأخیرهای پیشبینیناپذیر و اثر «همسایه پرسرصدا» (Noisy Neighbor) میشود. این اتفاق در زمانی رخ میدهد که صنعت با هزینههای واقعی مقیاسپذیری دستوپنجه نرم میکند. برای مثال، با تکیه بر پوشش قبلی ما درباره اینکه GPT-4o چگونه بر نمرهدهی آکادمیک تأثیر گذاشت، اکنون تمرکز از اینکه این مدلها «چه کاری میتوانند انجام دهند» به این تغییر یافته است که «چگونه میتوان آنها را بهطور پایدار در مقیاس بالا مستقر کرد».
مکانیسمهای توان عملیاتی رزرو شده (PTU)
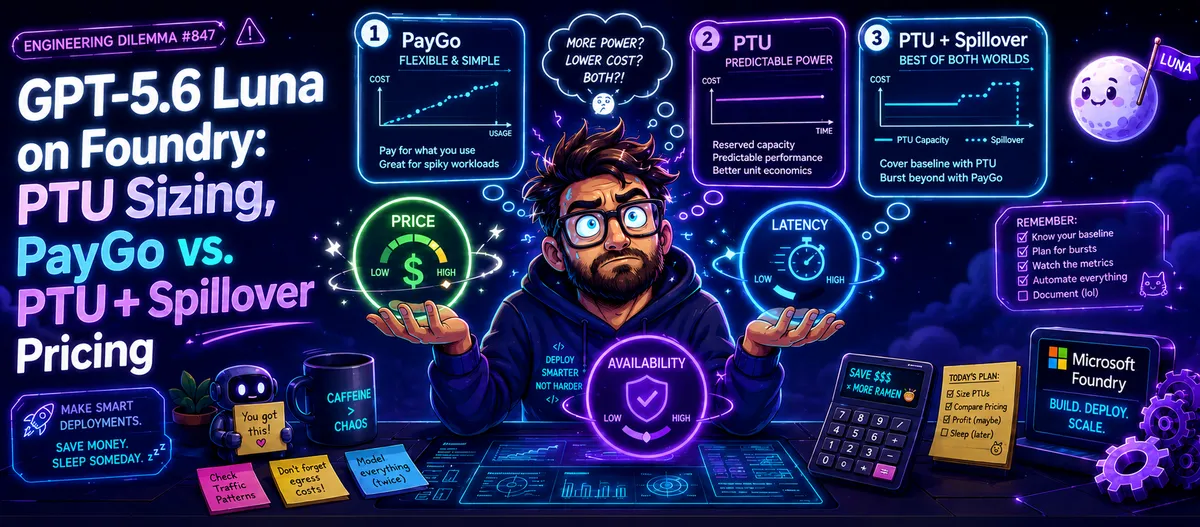
مایکروسافت فاندری (Microsoft Foundry) — شبیه به اجاره کردن یک خط اختصاصی در اتوبان بهجای استفاده از مسیرهای عمومی و شلوغ — قابلیتی به نام توان عملیاتی رزرو شده (Provisioned Throughput یا PTU) را ارائه میدهد. طبق راهنمای فنی منتشر شده در ۳۰ اوت ۲۰۲۶، PTU یک ظرفیت پردازشی اختصاصی است که برخلاف مدلهای استاندارد یا PayGo، دارای یک توافقنامه سطح خدمات (SLA) برای تأخیر مدل است و بین مستاجران (Tenants) مختلف مشترک نمیشود. این سیستم برای ترافیکهای پیشبینیپذیر و مستمر با نیاز به تأخیر ثابت و توان عملیاتی بالا طراحی شده است.
سهمیه PTU بر اساس اشتراک، منطقه و نوع استقرار اعطا میشود. بسیار مهم است که بدانید این سهمیه بین این مرزها قابل انتقال نیست؛ برای مثال، سهمیه در منطقه East US به West Europe منتقل نمیشود و سهمیه Global Provisioned به Data Zone Provisioned منتقل نمیگردد.
سهمیه PTU مستقل از مدل است، به این معنی که یک استخر واحد از ظرفیت را میتوان بین مدلهای مختلف پشتیبانیشده تقسیم کرد. با این حال، توان عملیاتی واقعی به ازای هر PTU بسته به نسخه مدل متفاوت است. برای مثال، مدل GPT-5.6 Luna در هر PTU حدود ۳۰,۰۰۰ توکن ورودی در دقیقه (Input TPM) ارائه میدهد، در حالی که این عدد برای مدل GPT-5.6 Terra حدود ۳,۰۰۰ و برای GPT-5.6 Sol حدود ۱,۲۰۰ است.
ورودیهای اندازهگیری و تخمین
برای تعیین تعداد دقیق PTU مورد نیاز، چندین متغیر خاص باید تعریف شوند. مدل و نسخه مدل محرکهای اصلی هستند، زیرا آنها Input TPM به ازای هر PTU و نسبت خروجی به ورودی را تعیین میکنند.
نوع استقرار نیز حیاتی است. کاربران باید بین Global Provisioned، Data Zone Provisioned یا Regional Provisioned یکی را انتخاب کنند. سایر ورودیهای ضروری عبارتند از: اوج تعداد فراخوانی در دقیقه (Peak RPM)، میانگین تعداد توکنهای ورودی در هر درخواست (Average prompt size) و میانگین تعداد توکنهای خروجی در هر درخواست (Average response size).
در نهایت، نرخ کش (Cache rate) — یعنی درصد توکنهای ورودی که از حافظه موقت پرامپت سرو میشوند — باید تخمین زده شود. از آنجایی که توکنهای کششده هیچ ظرفیتی از PTU مصرف نمیکنند، این متغیر تأثیر بسزایی بر اندازهگیری نهایی دارد.
محاسبه نیاز به PTU
اندازهگیری یک استقرار نیازمند چهار ورودی اصلی است: اوج RPM، میانگین اندازه پرامپت، میانگین اندازه پاسخ و نرخ کش. محاسبه از یک فرآیند نرمالسازی خاص پیروی میکند:
- TPM ورودی: حاصلضرب اوج RPM در میانگین توکنهای ورودی در هر درخواست.
- TPM ورودی مؤثر: TPM ورودی که بر اساس نرخ کش تعدیل شده است. فرمول آن به این صورت است:
Input TPM × (1 - Cache rate). توکنهای کششده ظرفیت PTU را مصرف نمیکنند. - TPM نرمالشده: مجموع TPM ورودی مؤثر و حاصلضرب نسبت خروجی به ورودی در TPM خروجی.
- تعداد PTU تخمینی: تقسیم TPM نرمالشده بر ثابت Input TPM مدل.
برای مدل GPT-5.6 Luna، نسبت خروجی به ورودی برابر با ۶ است. در یک سناریوی نمونه با ۱,۰۰۰ RPM، ۱,۲۰۰ توکن ورودی و ۲۰۰ توکن خروجی، نیاز به ۸۰ واحد PTU بدون استفاده از کش وجود دارد.
با نرخ برخورد (Hit rate) ۵۰ درصدی در کش پرامپت، این نیاز به ۶۰ واحد PTU کاهش مییابد که یعنی ۲۵ درصد کاهش در ظرفیت مورد نیاز. این کاهش به این دلیل ممکن است که کشینگ پرامپت برای استقرارهای Provisioned Throughput در دسترس است. با این حال، برای یک Cache Hit، پرامپت باید از حداقل ۱,۰۲۴ توکن بیشتر باشد و اولین ۱,۰۲۴ توکن در تمام درخواستها یکسان باشند.
محدودیتهای استقرار و گرد کردن
استقرارهای PTU دارای دانهبندی نامحدود نیستند. برای مدل GPT-5.6 Luna در استقرار Global Provisioned، حداقل نیاز ۱۵ واحد PTU است. علاوه بر این، ظرفیت باید در گامهای ۵ واحدی افزایش یابد.
اگر نتیجه یک محاسبه با این محدودیتها همخوانی نداشته باشد، گرد کردن الزامی است. برای مثال، اگر تخمینی برابر با ۶۲.۴ واحد PTU شود، باید به اولین گام پشتیبانیشده بعدی، یعنی ۶۵ واحد، گرد شود. اگر تخمین کمتر از حداقل ۱۵ واحد باشد، باید به ۱۵ واحد گرد شود.
اقتصاد PayGo در مقابل PTU + سرریز (Spillover)
تا تاریخ ۲۷ اوت ۲۰۲۶، قیمت مدل Global Standard برای GPT-5.6 Luna برابر با ۰.۲۰ دلار به ازای هر ۱ میلیون توکن ورودی معمولی و ۱.۲۰ دلار به ازای هر ۱ میلیون توکن خروجی است. نرخهای اضافی شامل ۰.۰۲ دلار به ازای هر ۱ میلیون توکن ورودی کششده و ۰.۲۵ دلار به ازای هر ۱ میلیون نوشتن در کش (Cache writes) است.
برای حجم کاری که در یک بازه ۲۴ ساعته بین ۰ تا ۲,۵۰۰ RPM نوسان دارد (با ۵۰٪ نرخ خواندن کش، ۱۰٪ نرخ نوشتن کش و ۴۰٪ ورودی معمولی)، یک رویکرد خالص PayGo تقریباً ۶۳۵.۰۴ دلار در روز هزینه دارد. این مبلغ در مجموع ۱۹,۰۵۱.۲۰ دلار برای یک ماه ۳۰ روزه و ۲۳۱,۷۸۹.۶۰ دلار برای یک سال ۳۶۵ روزه میشود.
برای بهینهسازی این وضعیت، کاربران میتوانند «سرریز» (Spillover) را پیادهسازی کنند. این یک پیکربندی اختیاری است که در آن مایکروسافت فاندری بهطور خودکار درخواستهایی را که از ظرفیت PTU فراتر میروند — بهویژه درخواستهایی که خطاهای HTTP 429, 500 یا 503 دریافت میکنند — به یک استقرار استاندارد PayGo هدایت میکند. بدون این پیکربندی، اپلیکیشن باید منطق جایگزین (Fallback) خود را پیاده کند.
مقایسه استراتژیهای پایه
دو استراتژی پایه با استفاده از نرخهای PTU منطقه Sweden Central در مقابل مدل PayGo-only آزمایش شدند. این نرخها شامل PTUهای ساعتی با قیمت ۱.۰۰ دلار/PTU/ساعت، رزروهای ماهانه با قیمت ۲۶۰.۰۰ دلار/PTU/ماه و رزروهای یکساله با قیمت ۲,۶۵۲.۰۰ دلار/PTU/سال است.
پایه ۲۵۰-RPM (۱۵ واحد PTU):
- ظرفیت: این پایه ظرفیت ۴۵۰,۰۰۰ TPM نرمالشده را فراهم میکند.
- رزرو ماهانه: گرانتر از PayGo است و هزینه آن ۱۹,۵۴۹.۲۰ دلار در ماه است (افزایش ۴۹۸ دلاری).
- رزرو یکساله: در مقایسه با مدل خالص PayGo، سالانه ۱,۶۱۱ دلار صرفهجویی میکند.
پایه ۵۰۰-RPM (۳۰ واحد PTU):
- ظرفیت: این پایه ظرفیت ۹۰۰,۰۰۰ TPM نرمالشده را فراهم میکند.
- رزرو ماهانه: هزینه آن ۲۰,۰۴۷.۲۰ دلار در ماه است (افزایش ۹۹۶ دلاری نسبت به PayGo).
- رزرو یکساله: کمترین هزینه سالانه را در بین هر سه گزینه دارد و سالانه ۳,۲۲۲ دلار نسبت به PayGo-only صرفهجویی میکند.
تحلیل دقیق ترافیک
در سناریوی پایه ۵۰۰-RPM، سیستم در دورههای کمتقاضا بهطور بهینه عمل میکند. بین ساعت ۰۰:۰۰ تا ۰۸:۰۰، ظرفیت ۳۰ واحدی PTU (۹۰۰,۰۰۰ TPM نرمالشده) بهطور کامل تقاضای ورودی را پوشش میدهد و منجر به صفر شدن سرریز میشود.
با این حال، در ساعات اوج (۱۲:۰۰ تا ۱۶:۰۰)، ترافیک ورودی به ۲,۵۰۰ RPM میرسد که تقاضایی معادل ۴,۵۰۰,۰۰۰ TPM نرمالشده ایجاد میکند. این امر منجر به تقاضای سرریز احتمالی به میزان ۳,۶۰۰,۰۰۰ TPM نرمالشده میشود. هزینه این سرریز تنها برای آن بازه ۴ ساعته ۱۸۱.۴۴ دلار است.
در یک ماه ۳۰ روزه با رزرو ماهانه، پایه ۵۰۰-RPM منجر به ۷,۸۰۰ دلار برای رزرو PTU و ۱۲,۲۴۷.۲۰ دلار برای سرریز PayGo میشود که در مجموع ۲۰,۰۴۷.۲۰ دلار است. هنگامی که این مدل به رزرو یکساله تغییر یابد، کل هزینه سالانه به ۲۲۸,۵۶۷.۶۰ دلار کاهش مییابد که شامل ۷۹,۵۶۰ دلار برای رزرو و ۱۴۹,۰۰۷.۶۰ دلار برای سرریز است.
درسهای حیاتی در صورتحساب
استقرار PTUها شامل ریسکهایی است که با صورتحسابهای مبتنی بر توکن متفاوت است. شما بر اساس PTUهای استقرار یافته هزینه پرداخت میکنید، نه توکنهای پردازش شده. یک استقرار بدون استفاده (Idle) همان هزینه استقرار اشباع شده را دارد.
استقرارها را نمیتوان متوقف (Pause) کرد؛ هزینهها تنها زمانی متوقف میشوند که استقرار حذف شود. صورتحساب ساعتی برای ساعات ناقص محاسبه میشود و برای حجمهای کاری موقت مانند بنچمارک، ارزیابی، اعتبارسنجی ظرفیت، پایلوتهای کوتاه یا تمرینات مهاجرت مناسبترین گزینه است.
علاوه بر این، رزرو کردن یک «تخفیف صورتحساب» است، نه «تضمین ظرفیت». کاربران باید ابتدا استقرار را ایجاد کنند تا تأیید شود ظرفیت وجود دارد و سپس رزرو را خریداری کنند. اگر استقرار بعداً کاهش یابد یا حذف شود، رزرو همچنان هزینه مقدار اولیه را دریافت میکند و باعث ایجاد پوششهای بدون استفاده میشود.
کاهش مقیاس یک استقرار، ظرفیت را به استخر منطقهای بازمیگرداند. هیچ تضمینی برای بازپسگیری آن ظرفیت وجود ندارد، بنابراین چرخه استقرارهای تولیدی (Production) استراتژی ضعیفی برای کنترل هزینه است. رزرو روی یک استقرار پایدار معمولاً ارزانتر و ایمنتر است.
تحلیل: تغییر به سمت برنامهریزی ظرفیت
این ساختار قیمتگذاری نشاندهنده تغییر در اقتصاد هوش مصنوعی از «صورتحساب خدماتی» (Utility Billing) به «اجاره زیرساخت» (Infrastructure Leasing) است. برای توسعهدهنده، این بدان معناست که هدف اصلی دیگر فقط بهینهسازی پرامپت نیست، بلکه شکلدهی به ترافیک (Traffic Shaping) است. این رویکرد در محیطهای عملیاتی بسیار مؤثر است؛ برای مثال، ادغام مدلهای سری GPT-5.6 در محیط Kiro نشان داد که چگونه بهینهسازی استقرار میتواند هزینههای عملیاتی کدنویسی را تا ۸۲ درصد کاهش دهد.
با پوشش دادن خط پایه پایدار و مستمر با PTUها و هدایت جهشهای ترافیکی به PayGo، شرکتها میتوانند به یک کف هزینه پیشبینیپذیر دست یابند و در عین حال توانایی مدیریت پیکهای ترافیکی را حفظ کنند. با این حال، ارزش واقعی PTUها فقط آن صرفهجویی ۱.۳۹ درصدی سالانه نیست؛ بلکه حذف نوسانات تأخیر (Latency Jitter) و تضمین یک SLA اختصاصی است که برای اپلیکیشنهای تولیدی مشتریمحور حیاتی است.
برای به حداکثر رساندن کارایی، مهندسان باید پروفایلهای RPM ۲۴ ساعته خود را نظارت کنند تا نقطه دقیقی را بیابند که در آن هزینه یک بلوک PTU اضافی، کمتر از هزینههای مورد انتظار PayGo برای همان حجم ترافیک باشد. هر بلوک PTU اضافی باید بیشتر از هزینه رزرو آن، در هزینههای PayGo صرفهجویی کند.
گام بعدی شما
- پروفایل RPM ۲۴ ساعته ترافیک خود را تحلیل کنید تا نقطه بهینه بین رزرو PTU و پرداخت PayGo بیابید.
- برای کاهش نیاز به PTU، استراتژیهای کشینگ پرامپت را برای درخواستهای بالای ۱,۰۲۴ توکن پیاده کنید.
- در محیطهای تست، از صورتحساب ساعتی برای اعتبارسنجی ظرفیت قبل از خرید رزروهای یکساله استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو