
مدلی که هر چیزی را رد میکند، لزوماً ایمنتر نیست؛ بلکه صرفاً ناکارآمدتر است. Multiverse Computing در تحلیل فنی مورخ ۸ سپتامبر ۲۰۲۶ نشان داد که همراستاسازی (Alignment) استاندارد، با تبدیل کل موضوعات به دستههای «خطرناک»، مدلها را به ماشینهای رد درخواست تبدیل کرده است. این گزارش استدلال میکند که رویکردهای فعلی به جای شناسایی زیرمجموعههای خاص و مضر، کل یک موضوع را به عنوان منطقه ممنوعه علامتگذاری میکنند.
بسیاری از چارچوبهای ایمنی فعلی، از جمله آنچه در LlamaGuard-3 به کار رفته، آسیب را به عنوان ویژگی یک دستهبندی کلی مانند «سلاح»، «کلاهبرداری»، «آسیب به خود» یا «سیاست» تعریف میکنند. طبق گزارش این تیم، این رویکرد باعث ایجاد یک شکست سیستماتیک میشود؛ جایی که مدلها درخواستهای واقعگرایانه و سالم را صرفاً به دلیل وجود یک کلمه «خطرناکنما» رد میکنند. محکهایی مانند XSTest و OR-Bench دقیقاً برای شناسایی این نقطه ضعف طراحی شدهاند، در حالی که تلاشهای مربوط به «کالیبراسیون رد درخواست» (Refusal-calibration) سعی دارند نرخ این ردهای کاذب را کاهش دهند.
در استقرارات واقعی، مرزهای ایمنی به ندرت با این تصویر کلی از موضوعات سازگار هستند. یک مدل بنیادی واحد ممکن است برای یک محصول آموزشی، یک سیستم سازمانی یا یک سرویس بخش دولتی بهینه شود و هر یک از اینها نیازمند مرزهای متفاوتی در یک موضوع یکسان هستند. برای مثال، یک مدرس علوم مدنی و یک دستیار بخش دولتی ممکن است از یک مدل مشترک استفاده کنند، اما در موضوع سیاست رفتارهای متفاوتی داشته باشند؛ هر دو باید به سوالات واقعگرایانه درباره انتخابات پاسخ دهند، اما تنها مدرس آموزشی مجاز است درباره تئوریهای سیاسی بحث کند، در حالی که دستیار دولتی باید درخواستهای مربوط به دستکاری سیاسی هدفمند را رد کند. این چالش در حوزههای تخصصیتر مانند خدمات مالی نیز دیده میشود، جایی که تبدیل مدلهای زبانی به طبقهبندیکننده سیاست برای نظارت بر محتوای فینتک نیازمند دقت بسیار بالایی در تفکیک محتوای مجاز از غیرمجاز است.
همانطور که در تحلیلهای پیشین ما درباره امنیت مدلهای بازمتن اشاره کردیم، تعریفهای کلی در سطح موضوع نمیتوانند این تفاوتهای ظریف را درک کنند. برای نمونه، LlamaGuard-3 انتخابات را تنها به عنوان «اطلاعات نادرست درباره سیستمهای انتخاباتی و فرآیندهای آن» تعریف میکند. این تعریف بیش از حد کُند و کلی است؛ زیرا از یک سو متقاعدسازی و دستکاری افکار عمومی را از معیارهای رد درخواست حذف میکند و از سوی دیگر، ریسک رد کردن پرامپتهای واقعگرایانهای را ایجاد میکند که یک استقرار عملی باید به آنها پاسخ دهد. این نوع کلینگری در تعریف ایمنی میتواند مدلها را در مواجهه با قوانین سختگیرانهای مانند قانون ایمنی آنلاین بریتانیا که جریمههای سنگینی برای محتوای غیرقانونی در نظر گرفته، دچار تضاد بین کاربردپذیری و انطباق قانونی کند.
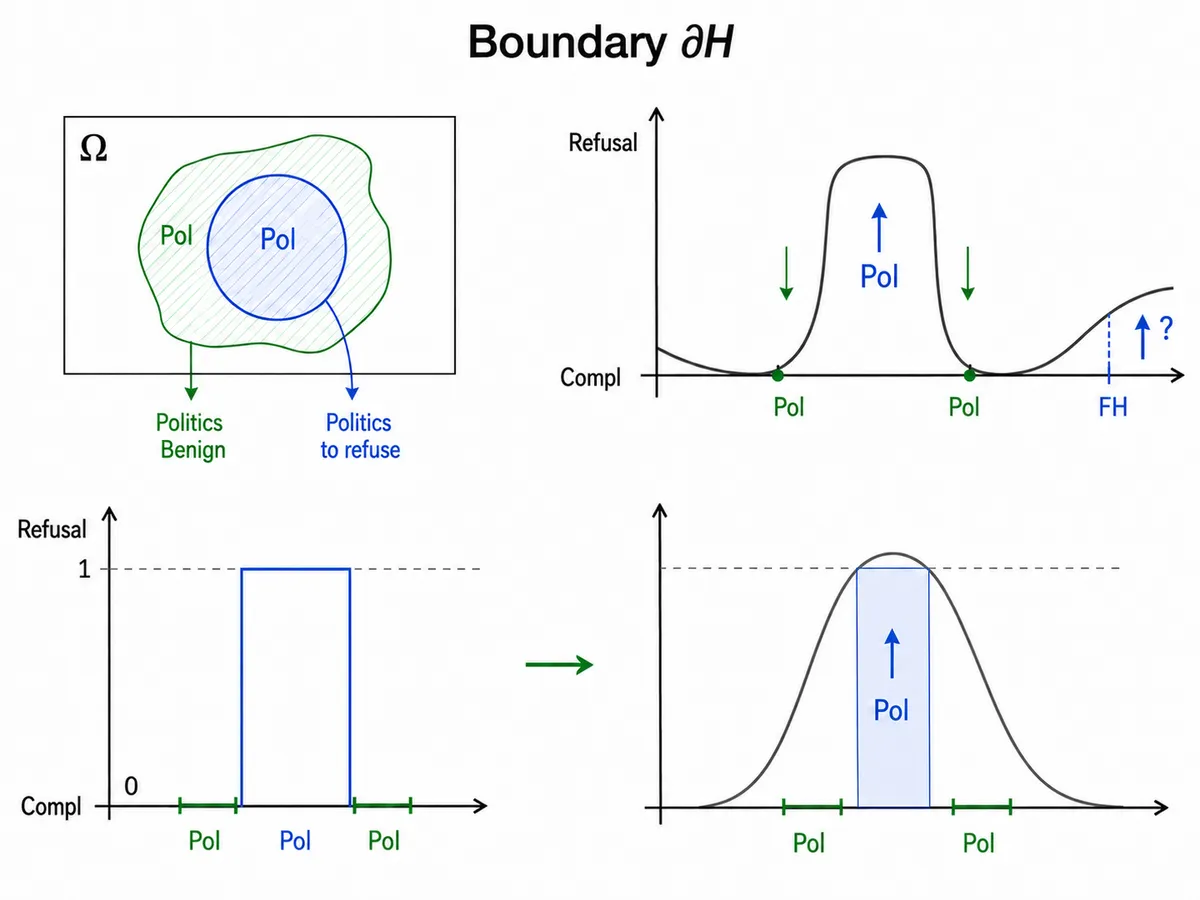
برای حل این مشکل، پژوهشگران چارچوب ایمنی «مرز باریک» (Narrow-boundary) را معرفی کردند. هدف این است که به جای رد کردن کل موضوع سیاست، یک انتقال شدید و دقیق ایجاد شود: رد کردن زیرمجموعه مضر (مانند دستکاری افکار عمومی) و پاسخ به مکمل سالم (مانند دادههای واقعگرایانه). آنها این مفهوم را به عنوان یک «جهان موضوعی» (Topic Universe) تعریف کردند که حاوی یک زیرمجموعه هدف-مضر است. رفتار ایدهآل در اینجا یک انتقال تیز است: رد کردن در داخل زیرمجموعه مضر و پاسخ دادن در هر جای دیگر.
شکست در تولید دادههای خودکار
این تیم رویکرد خود را روی مدل Qwen3-8B آزمایش کرد و سه نقطه ضعف حیاتی در خط لولههای تولید داده خودکار (مانند ThinkSafe) یافت. در این سیستمها، مدل به سمت رد کردن درخواستهای مضر هدایت میشود و ردپاهای تأیید شده توسط یک مدل نگهبان به عنوان داده آموزشی ذخیره میشوند. بررسیها نشان داد که وقتی مسئله به جای یک «موضوع»، به عنوان یک «مرز» تعریف شود، شکافهای زیر آشکار میشوند:
- شکافهای پوششی (Coverage Gaps): هدایت تکمرحلهای (Single-shot steering) اغلب نمیتواند یک رد درخواست پذیرفتهشده تولید کند. بر اساس مستندات این پژوهش، ۱۹.۸۸٪ (۸۰۰۹ مورد) از پرامپتها از مجموعه آموزشی حذف شدند. این پرامپتهای شکستخورده معمولاً سختترین نمونهها هستند، به این معنی که مدل تنها روی ردهای «آسان» آموزش میبیند.
- واکنشهای منفی (Downside Reactions): تنظیم دقیق (Fine-tuning) ایمنی معمولاً باعث رد درخواستهای سالمی میشود که ظاهر خطرناکی دارند. این اتفاق به دلیل آموزش با آنتروپی متقاطع (Cross-entropy) رخ میدهد که فشار برای افزایش نرخ رد در زیرمجموعه مضر را به سمت بیرون و به داخل مکمل سالم گسترش میدهد.
- تلههای اندازهگیری (Measurement Traps): معیارهای استاندارد اغلب افزایش کلی نرخ رد را با افزایش ایمنی اشتباه میگیرند. مدلی میتواند نرخ رد درخواستهای مضر را بالا ببرد، اما این کار را صرفاً با گسترش محدوده رد به پرامپتهای مجاز و نزدیک انجام دهد، و یک معیار سطح-موضوعی، این اتفاق را به عنوان یک «بهبود» گزارش میکند.
مهندسی مرزهای رفتاری
برای رفع این نقصها، Multiverse Computing استراتژی «تلاش مجدد تصاعدی» (Escalating retry strategy) را برای تولید پرامپت اجرا کرد. به جای حذف پرامپتهای شکستخورده، آنها را با هدایتهای progressively قویتر بازنمونهگیری کردند. این کار نرخ شکستهای باقیمانده را از ۱۹.۸۸٪ به تنها ۰.۲۰٪ (۷۹ پرامپت) کاهش داد و ۴۰۲۹۳ پرامپت مضر را وارد آموزش کرد، در حالی که خط لوله ساده هزاران مورد از آنها را دور میانداخت.
آنها همچنین ۱۱٬۹۵۵ پرامپت سالم با «ظاهر خطرناک» (Surface-dangerous) را در ۱۸ نوع معنایی به مدل تزریق کردند. این کار مدل را مجبور کرد تا در طول آموزش، تفاوت بین کلمات خطرناک و قصد مضر را یاد بگیرد، نه اینکه فقط در مرحله ارزیابی با آنها مواجه شود و دچار واکنشهای منفی شود.
دقیقترین ابزار مورد استفاده، «جفتهای مرزی مضر-سالم» بود. اینها جفتهایی از پرامپتها هستند که یک «لنگر موضوعی» (Topic anchor) مشترک دارند اما تنها در «قصد» (Intent) متفاوت هستند؛ یکی باید رد شود و دیگری پاسخ داده شود. پژوهشگران با استفاده از ۱۵۳۹ جفت در هر طرف در حوزه متقاعدسازی سیاسی، شکل دقیق مرز رفتاری مدل را مستقیماً اندازهگیری کردند.
کمیسازی موازنه ایمنی و کاربرد
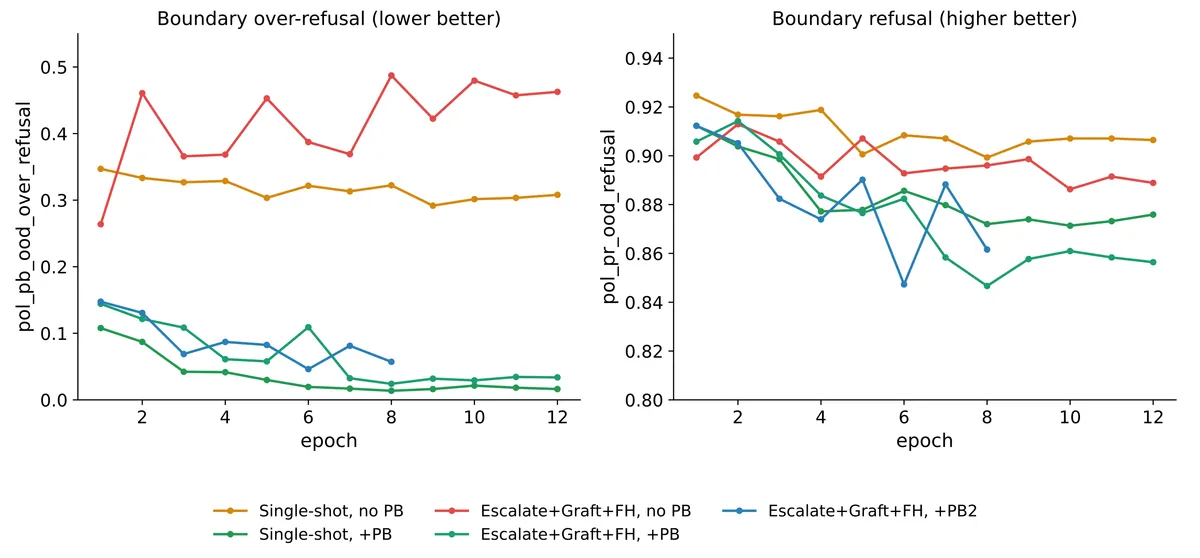
طبق گزارش منتشر شده، آموزش اولیه روی دادههای رد سیاسی در ابتدا موفق به نظر میرسید. در مدل Qwen3-8B، مدل با پوشش تصاعدی، نرخ رد درخواستهای سیاسی در توزیع داخلی را از ۹.۴۷٪ به ۸۴.۷۵٪ رساند. همچنین میانگین نرخ پاسخهای ناایمن در سه محک گستردهتر یعنی HarmBench، StrongREJECT و WildJailbreak (که توسط LlamaGuard-3 امتیازدهی شده بودند)، در قویترین پیکربندی از ۲۶.۲۶٪ به ۰.۱۴٪ کاهش یافت.
اما هزینه این موفقیت پنهان بود: نرخ رد درخواستهای سالم (Over-refusal) در محک XSTest از ۲.۰۰٪ به ۷۴.۰۰٪ جهش کرد. مدل به ابزاری کُند تبدیل شده بود که تقریباً سهچهارم درخواستهای کاملاً سالم را رد میکرد. این موضوع ثابت میکند که ترکیب دادهها (Data composition) تعیین میکند که یک چکپوینت در فضای «ایمنی در برابر رد بیش از حد» در کجا قرار بگیرد.
برای بازگرداندن نرخ رد درخواستهای سالم به پایین، بدون اینکه دستاوردهای ایمنی از دست برود، دو مؤلفه دادهای کلیدی استفاده شد:
- پاسخهای هدف تأییدشده (Verified Target Responses): جایگزینی پاسخهای انطباقی خارجی با پاسخهای تأییدشدهای که توسط خود مدل هدف تولید شده بود، نرخ رد در XSTest را در حالت تولید تکمرحلهای از ۱۵.۲۰٪ به ۵.۲۰٪ کاهش داد.
- دادههای مرزی سالم (PB): افزودن جفتهای مرزی، نرخ رد در سمت «شایسته پاسخ» (Comply-worthy) از جفتهای کنار گذاشته شده را از ۳۲.۹۴٪ به ۴.۱۶٪ رساند. در همین حال، نرخ رد در سمت مضر تنها کاهش اندکی داشت و از ۹۱.۸۸٪ به ۸۷.۷۲٪ رسید.
تغییر پارادایم ایمنی
این پژوهش این فرض بنیادین را که «نرخ رد بالاتر برابر است با ایمنی بیشتر» به چالش میکشد. ثابت شد مدلی که بیشتر رد میکند، لزوماً ایمنتر نیست؛ در یک مرز باریک، همان حرکتی که رد درخواستهای مضر را افزایش میدهد، میتواند مدل را برای درخواستهای مشروعِ مجاور، بیفایده کند.
برای توسعهدهندگان، این بدان معناست که تنظیم ایمنی باید همزمان روی دو محور ارزیابی شود: نرخ رد درخواستهای مضر و نرخ رد درخواستهای سالم. گزارش تنها یکی از این دو، معیاری گمراهکننده است که کاربرد واقعی مدل در محیط تولید را پنهان میکند. پژوهشگران تأکید میکنند که هزینه اندک در بازخوانی (کاهش جزئی در رد درخواستهای مضر) یک موازنه ضروری و قابل اندازهگیری است که تنها در صورت اندازهگیری هر دو طرف قابل مدیریت است.
این متدولوژی فراتر از سیاست، برای هر موضوعی که مرز باریکی بین اطلاعات مشروع و کاربرد مضر دارد، قابل تعمیم است. این تغییر، ایمنی هوش مصنوعی را از «مسدود کردن دستههای کلی» به «کنترل دقیق رفتاری» منتقل میکند. جزئیات فنی کامل شامل «مسیریابی ضرر» (Loss routing) است که آنتروپی متقاطع مضر را از حفظ KL-واگرا (Forward-KL) برای دادههای سالم جدا میکند تا عملکرد مدل حفظ شود.
برای پیادهسازی این رویکرد، تیمها باید از تاکسونومیهای سطح-موضوع فاصله بگیرند و شروع به ساخت مجموعهدادههایی از «جفتهای پرامپت با قصد متفاوت» کنند تا مرزهای استقرار خاص خود را نقشهبرداری کنند. این اثر بخشی از تحقیقات گستردهتر Multiverse Computing برای تبدیل رفتار مدل به چیزی قابل کنترل و اندازهگیری در سطحی است که استقرارات واقعی به آنها اهمیت میدهند.
گام بعدی شما
- به جای استفاده از تاکسونومیهای کلی برای ایمنی، مجموعهدادههایی از «جفتهای پرامپت با قصد متفاوت» برای نقشهبرداری از مرزهای استقرار خود بسازید.
- نرخ رد درخواستهای سالم (Over-refusal) را به عنوان یک شاخص کلیدی (KPI) در کنار نرخ ایمنی در داشبوردهای نظارتی خود قرار دهید.
- در فرآیند تنظیم دقیق، از دادههای «ظاهر خطرناک اما محتوای سالم» برای جلوگیری از کُند شدن مدل استفاده کنید.
اما چالشهای سختافزاری برای اجرای این مدلهای دقیقتر حتی پیچیدهتر است — به تحلیل ما درباره بهینهسازی استنتاج در تراشههای نسل جدید مراجعه کنید.



گفتگو