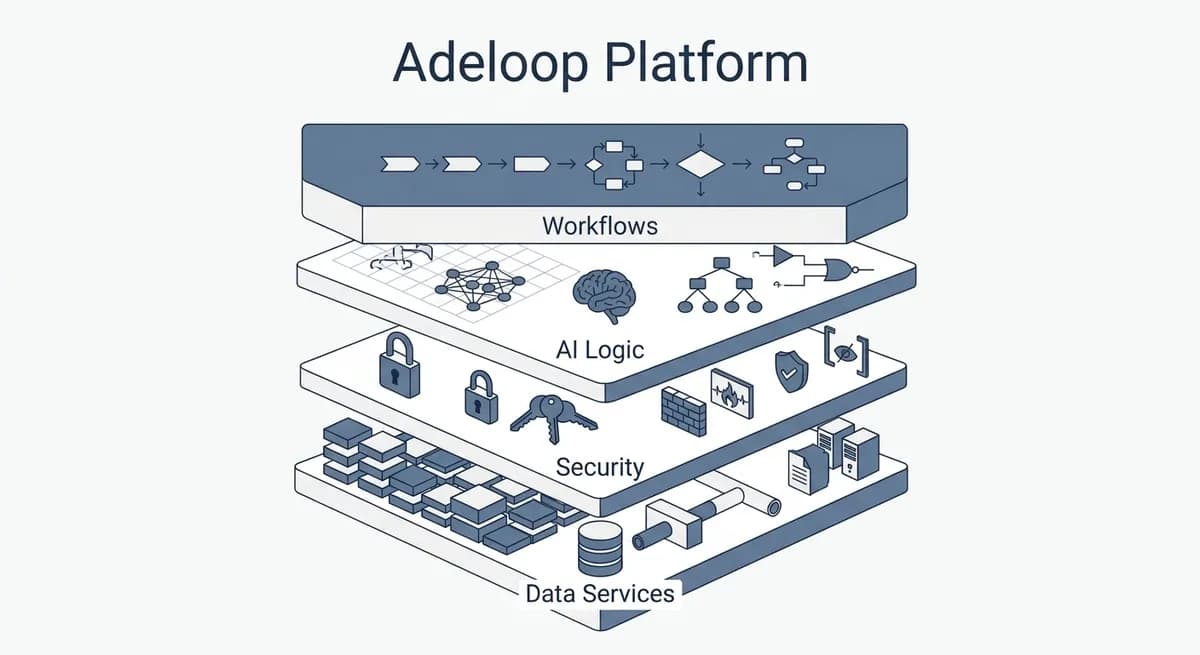
اگر امروز از دو ابزار تحلیل متفاوت برای یک دیتاست استفاده میکنید، احتمالاً دو جواب متفاوت میگیرید — لایه معنایی گمشده، دلیل است. AdeloopData این شکاف را با یک لایه معنایی مشترک برطرف کرد که نوتبوکها و چتباتها را روی تعریفهای یکسان متریکها مینشاند.
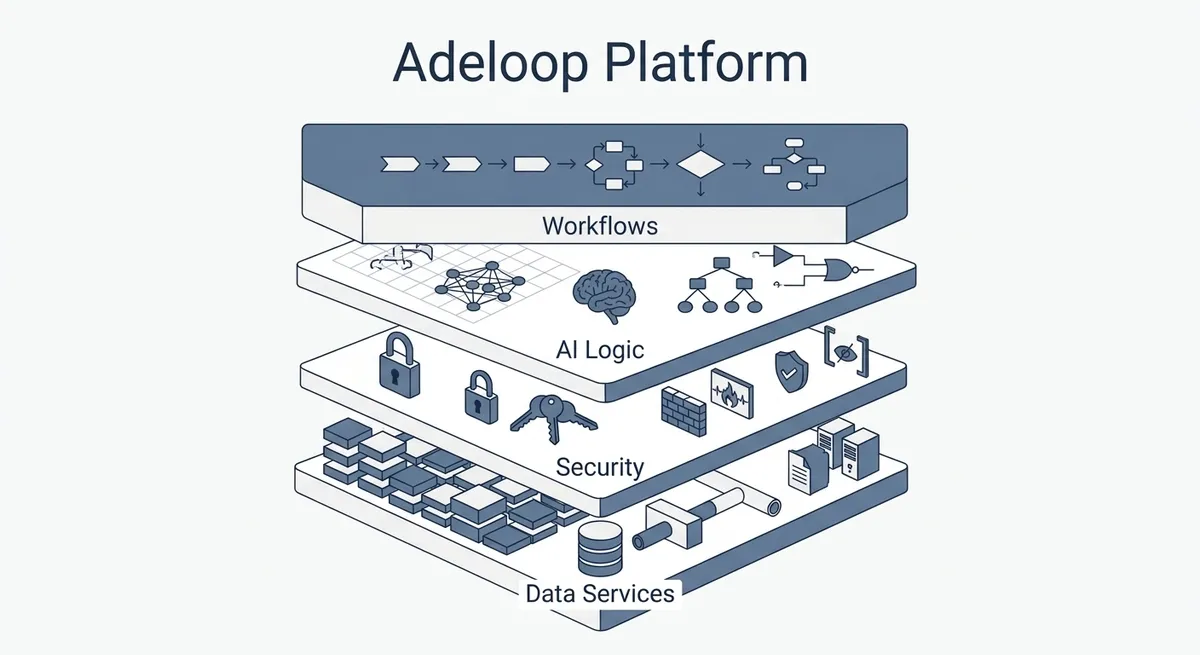
همانطور که در تحلیل قبلی ما دربارهی لایههای معنایی و جلوگیری از توهم داده اشاره کردیم، اتصال مستقیم مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه خوانده و حالا با همان لحن کتابها جواب میدهد — به دیتابیس برای تحلیلهای قابلاعتماد کافی نیست. به گزارش سازنده AdeloopData، ابزارهای تحلیل هوش مصنوعی امروز گام مدلسازی را پرش میکنند و امیدوارند پرامپتها منطق درآمد، اتصال جداول و قواعد تجمیع را مدیریت کنند؛ رویکردی که در مواجهه با سفارشهای لغو شده، سیاستهای مرجوعی یا انتخاب فیلد تاریخ جواب میدهد.
AdeloopData جداول خام یا دیتاستهای آپلودشده را میپذیرد و کاربران را به تعریف موجودیتها (Entities)، روابط (Relationships)، متریکها (Metrics)، بعدها (Dimensions) و قوانین کسبوکار (Business Rules) راهنمایی میکند. یک دامنه تجارت الکترونیک ممکن است مشتریها، سفارشها، محصولات و پرداختها را به عنوان موجودیت اعلام کند، سپس مشخص کند که مشتریها سفارش میدهند و سفارشها شامل محصول هستند. درآمد به متریکی با فرمول صریح تبدیل میشود که لغو سفارشها و مرجوعیها را مدیریت میکند. سیستم این تعاریف را بهصورت خودکار تولید نمیکند؛ آنها نیازمند اعتبارسنجی انسانی هستند.
مؤلفههای دامنه معنایی به تفصیل
- موجودیتها اشیاء اصلی کسبوکار را نشان میدهند: مشتری، سفارش، محصول، پرداخت
- روابط نحوه اتصال موجودیتها را تعریف میکنند: مشتری سفارش میدهد، سفارش شامل محصول است، سفارش به پرداخت متصل است
- متریکها اندازههای کمی را ثبت میکنند: درآمد، تعداد سفارش، میانگین ارزش سفارش
- بعدها ویژگیهای برشدهی فراهم میکنند: دستهبندی محصول، کشور، تاریخ
- تعاریف کسبوکار قواعد محاسبه را کدگذاری میکنند: نحوه مدیریت سفارشهای لغو شده، مرجوعیها، انتخاب فیلد تاریخ برای دورههای گزارشدهی
چرا داده خام کافی نیست
یک دیتابیس شامل جداول، ستونها، شناسهها و روابط است. یک کاربر کسبوکار به زبان درآمد، مشتری، عملکرد و روند فکر میکند. بریدن این دو جهان نیازمند بیش از تولید SQL از یک پرامپت است. مدل باید بفهمد کدام جداول حاوی اطلاعات مرتبطاند، سفارشها چگونه به محصولات و پرداختها متصلاند، درآمد در این دیتاست چه معنایی دارد، سفارشهای لغو شده یا مرجوعیها چگونه باید مدیریت شوند، کدام فیلد تاریخ دوره گزارشدهی را تعریف میکند، و نتایج چگونه باید تجمیع و بصریسازی شوند. یک مدل میتواند SQL تولید کند بدون اینکه به این سوالات بهدرستی پاسخ دهد.
دو رابط، یک بستر مشترک
پلتفرم دو مسیر تحلیل ارائه میدهد. محیط نوتبوک به تحلیلگران اجازه میدهد داده بارگذاری کنند، کیفیت را بازبینی کنند، درآمد ماهانه را با متریکهای تعریفشده محاسبه کنند، دستهها را در ابعاد مختلف مقایسه کنند و بصریسازیها را سلولی بسازند. رابط گفتاری (Conversational) درخواستهای زبان طبیعی مثل «عملکرد فروش در شش ماه اخیر را تحلیل کن» را میپذیرد و نمودار خطی، میلهای، جداول و متریکهای خلاصه برمیگرداند. هر دو رابط به تعاریف معنایی یکسان ارجاع میدهند، بنابراین تغییر یک متریک همه جا منعکس میشود.
مراحل گردشکار نوتبوک
- بارگذاری دیتاست از منابع متصل یا آپلودها
- بازبینی مقادیر گمشده و انواع داده
- محاسبه درآمد ماهانه با استفاده از متریکهای تعریفشده
- مقایسه دستههای محصول در ابعاد مختلف
- ایجاد بصریسازیها (نمودار خطی، میلهای، جداول)
- بازبینی تکرارپذیر تحلیل از طریق اجرای سلولی
- ساخت بر پایه مراحل قبلی برای بازتولیدپذیری
قابلیتهای تحلیل گفتاری
- قبول درخواستهای زبان طبیعی مثل «قویترین دستههای محصول را شناسایی و روند ماهانه را بصریسازی کن»
- تفسیر درخواست با استفاده از بستر معنایی موجود
- بازیابی یا محاسبه نتایج مرتبط
- رندر خودکار بصریسازیهای مناسب:
- نمودار خطی برای روندها در طول زمان
- نمودار میلهای برای مقایسه دستهها
- جداول برای نتایج جزئی
- متریکهای خلاصه برای شاخصهای کلیدی
- دسترسیپذیر کردن کاوش داده بدون حذف قابلیت بررسی نتایج زیرین
چرا لایه تجربهها را متصل میکند
بدون تعاریف مشترک، نوتبوکها و گردشکارهای چت اغلب محاسبه یکسان را بهشیوههای متفاوت پیادهسازی میکنند. یک لایه معنایی نمایش مشترکی از متریکها، موجودیتها، روابط و قواعد کسبوکار فراهم میکند. معماری از منابع داده به دامنه معنایی، سپس به رابط تحلیلی (نوتبوک یا گفتاری)، سپس به اجرای پرسوجو، سپس به نمودارها و بینشها جریان دارد. لایه موتور اجرا نیست؛ معنا و ساختار را تأمین میکند.
جریان معماری
منابع داده و آپلودها → دامنه معنایی → رابط تحلیلی (نوتبوک یا گفتاری) → پرسوجو یا محاسبه → نتایج → نمودارها و بینشها
RAG، مدلسازی معنایی و LLM نقشهای متفاوتی دارند
تولید بازیابیافزا (RAG) — مثل دانشآموزی که قبل از جواب دادن اول کتاب درسی را باز میکند و از آن نقل میکند — مستندات مربوط به نحوه تعریف درآمد خالص توسط شرکت را بازیابی میکند. لایه معنایی تعریفی ساختاریافته از متریک ارائه میدهد که گردشکارهای تحلیلی میتوانند اجرا کنند. LLM درخواست را تفسیر میکند و تحلیل را برنامهریزی میکند. موتور پرسوجو محاسبه واقعی را بر روی داده انجام میدهد. ترکیب این اجزا بر انتظار از یک پرامپت که کشف، منطق، تولید، محاسبه و بصریسازی را همزمان انجام دهد، برتری دارد.
مسئولیتهای مؤلفهها
- RAG: بستر مرتبط را از اسناد و اطلاعات ایندکسشده بازیابی میکند (مثلا مستندات شرکت درباره تعریف درآمد خالص)
- لایه معنایی: مفاهیم و روابط کسبوکار را در فرم ساختاریافته نمایش میدهد (مثلا تعریف متریک net_revenue)
- LLM: درخواست کاربر را تفسیر میکند، کمک به برنامهریزی تحلیل میکند، پرسوجو تولید میکند
- موتور پرسوجو: محاسبات واقعی را در برابر داده اجرا میکند
از سؤال تا بصریسازی
یک درخواست مثل «کدام دستههای محصول بزرگترین افت فروش را در این فصل تجربه کردهاند» یک گردشکار را راهاندازی میکند که متریک فروش را تعیین میکند، بازه تاریخ را شناسایی میکند، بعد دستهبندی را انتخاب میکند، مقادیر قابل مقایسه را در دورهها محاسبه میکند، نتایج را بر اساس بزرگی افت رتبهبندی میکند، و جدولی به همراه نمودار برمیگرداند. سوالات پیگیری — چرا این دسته افت کرد، با فصل قبل مقایسه کن، بر اساس کشور نشان بده، به نمودار خطی تغییر بده — روی همان بستر تحلیلی موجود ساخته میشوند، نه از صفر آغاز میشوند.
مراحل گردشکار برای یک پرسوجوی نمونه
۱. تعیین متریک فروش مرتبط از تعاریف معنایی
۲. شناسایی بازه تاریخ مناسب برای «این فصل»
۳. انتخاب بعد دستهبندی صحیح (دستهبندی محصول)
۴. محاسبه مقادیر قابل مقایسه در طول دورهها
۵. رتبهبندی نتایج بر اساس بزرگی افت
۶. برگرداندن جدول تغییرات
۷. رندر نمودار برای درک آسانتر تفاوتها
مدیریت سوالات پیگیری
- «چرا این دسته افت کرد؟» → تحلیل دریلداون (Drill-down)
- «چگونه با فصل قبل مقایسه میشود؟» → مقایسه دورهبهدوره
- «همین تحلیل را بر اساس کشور نشان بده» → برش بعد اضافی
- «آیا میتوانی این را به عنوان نمودار خطی نمایش دهی؟» → تغییر نوع بصریسازی
- هر پیگیری روی بستر تحلیلی موجود ساخته میشود، نه به عنوان وظیفه کاملاً غیرمرتبط
چالشهای مهندسی باقی مانده
دقت معنایی حیاتی است؛ تعاریف اشتباه نتایج اشتباه میدهند. SQL تولیدشده باید قبل از اجرا اعتبارسنجی شود. منابع متصل نیاز به مجوزهای مناسب دارند که لایه هوش مصنوعی نمیتواند دور بزند. انتخاب بصریسازی باید با ساختار نتیجه و هدف سؤال همسو باشد. بازتولیدپذیری نیازمند است کاربر بتواند ریشه نتایج را ردیابی کند. بستر تحلیلی مشترک تقاضا میکند نوتبوکها و چت از تعاریف یکسانی استفاده کنند، نه پیادهسازیهای جداگانه از یک منطق کسبوکار.
شکاف چالشها به تفصیل
- دقت معنایی: تعاریف متریک یا روابط نادرست به نتایج نادرست میانجامند؛ تعاریف و روابط نیاز به اعتبارسنجی دارند، مخصوصاً وقتی قواعد کسبوکار مبهماند
- تولید پرسوجو: SQL یا عملیات تولیدشده باید قبل از اجرا اعتبارسنجی شوند
- امنیت داده: منابع متصل نیاز به مجوزهای مناسب دارند؛ لایه هوش مصنوعی نباید آنها را دور بزند
- انتخاب بصریسازی: نمودار باید با ساختار نتیجه و سؤال پرسیدهشده همسو باشد
- بازتولیدپذیری: کاربران باید بتوانند ریشه نتایج را بفهمند و محاسبات مهم را بازتولید کنند
- بستر تحلیلی مشترک: نوتبوکها و تحلیل گفتاری باید از تعاریف یکسان استفاده کنند، نه از نسخههای جداگانه یک منطق کسبوکار
جهت پلتفرم
AdeloopData هدف دارد ingestion داده، مدلسازی معنایی، تحلیل تعاملی و بصریسازیهای تولیدشده توسط هوش مصنوعی را در یک محیط گرد هم آورد. کاربران یک منبع را متصل میکنند، یک دامنه معنایی سازماندهی میکنند و سبک کاوش خود را انتخاب میکنند. سازنده یک بستر معنایی مشترک را به عنوان راهِ امیدوارکننده برای اتصال گردشکارهای تحلیلی سنتی با هوش مصنوعی گفتاری میبیند. پروژه بازخورد از سایر توسعهدهندگان را درباره مدیریت تعاریف معنایی، text-to-SQL و منطق یکسان در نوتبوکها، داشبوردها و رابطهای چت دعوت میکند.
اهداف اعلامشده سازنده
- ingestion داده، مدلسازی معنایی، تحلیل تعاملی و بصریسازیهای AI را در یک محیط ادغام کند
- به کاربران اجازه دهد منبعی را متصل کنند یا دیتاست آپلود کنند، آن را به یک دامنه معنایی معنادار سازماندهی کنند و نحوه کاوش را انتخاب کنند
- هم کار نوتبوک گامبهگام و هم تحلیل گفتاری را پشتیبانی کند
- داده را قابلدسترسیتر کند بدون اینکه ساختار زیرین و منطق کسبوکار را به عنوان یک پیشفکر فرعی بگذارند
سوالات باز برای جامعه
- شما چگونه تعاریف معنایی، text-to-SQL و منطق کسبوکار یکسان را در نوتبوکها، داشبوردها و رابطهای گفتاری مدیریت میکنید؟
- از یک لایه معنایی موجود استفاده میکنید، خودتان میسازید، یا رویکرد دیگری دارید؟
گام بعدی شما
- اگر کوپایلوت تحلیلی داخلی میسازید، اول یک لایه معنایی مشترک برپا کنید؛ بعد رابط نوتبوک یا چت را روی آن بسازید.
- متریکهای کلیدی (مثل net_revenue) را در یک مکان واحد تعریف کنید و مطمئن شوید هر دو محیط تحلیلی از همان تعریف تغذیه میشوند.
- اعتبارسنجی SQL تولیدشده و مجوزهای داده را از روز اول در معماری گنجانید.
اما چالشهای مهندسی دقت معنایی، اعتبارسنجی پرسوجو و استقرار چندمستأجری هنوز در انتظار راهحلهای واقعی هستند — به تحلیل ما دربارهی معماریهای عاملمحور مراجعه کنید.

گفتگو