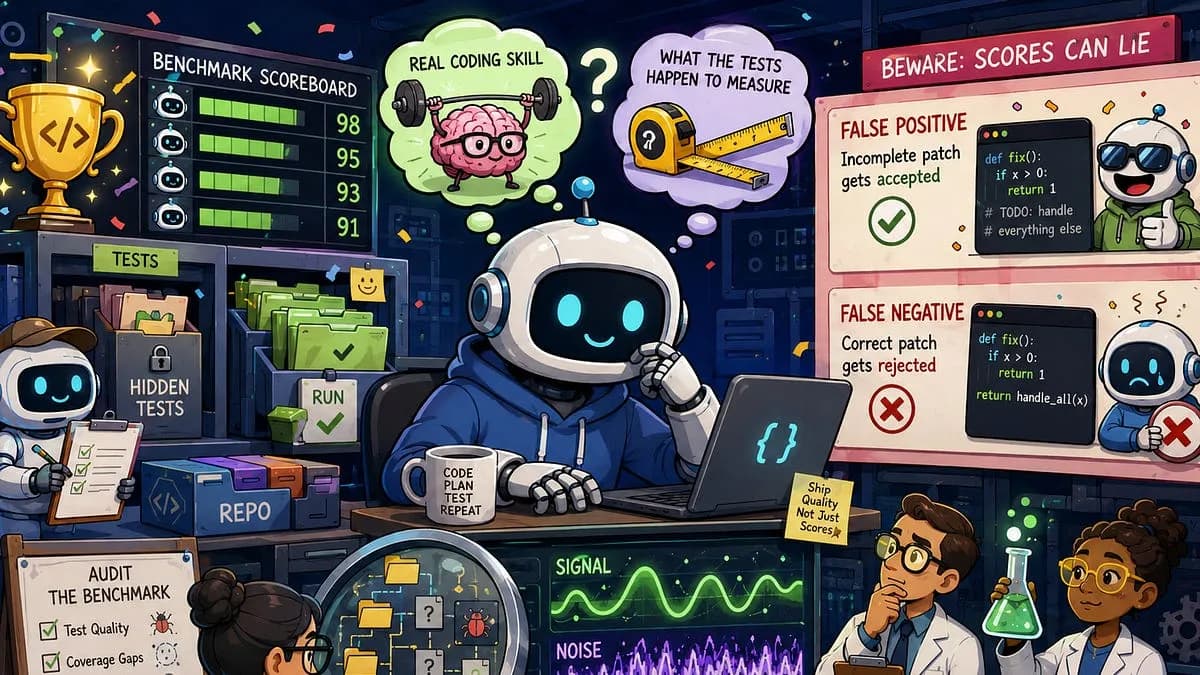
یک امتیاز بالا در بنچمارکها لزوماً به معنای هوشمندی مدل نیست؛ گاهی این اعداد فقط توهمِ موفقیت هستند. طبق گزارشی که OpenAI در ۸ جولای ۲۰۲۶ با عنوان «جداسازی سیگنال از نویز در ارزیابیهای کدنویسی» منتشر کرد، حدود ۳۰٪ از تسکهای عمومی در محک SWE-Bench Pro معیوب هستند.
این بازرسی در حالی رخ میدهد که صنعت برای یافتن روشهای قابلاعتماد جهت سنجش عاملهای (Agents) کدنویس با افق زمانی بلند در تکاپو است. این چالش با یافتههای اخیر معهد امنیت AI بریتانیا همسو است که هشدار داد بودجههای توکن در برخی محکها ممکن است توانایی واقعی عاملها را پنهان کند. همانطور که در تحلیلهای قبلی ما دربارهی تنشهای داخلی OpenAI و تغییر جهتهای استراتژیک این آزمایشگاه دیدیم، اکنون تمرکز این شرکت بر سلامت معیارهایی است که ادعاهای مدلهای پیشرو را توجیه میکنند.
به نقل از این گزارش، عملکرد مدلها در بخش عمومیِ ۷۳۱ تسکیِ این محک، در عرض تنها هشت ماه از ۲۳.۳٪ به ۸۰.۳٪ رسیده است. با این حال، بررسیهای OpenAI نشان داد که این پیشرفت تا حدی توهمی بوده که توسط تستهای معیوب ایجاد شده است.
یافتههای بازرسی
- بازرسی با کمک عاملها: ۲۷.۴٪ از تسکها (۲۰۰ مورد) معیوب تشخیص داده شدند.
- بازرسی توسط متخصصان انسانی: مهندسان نرمافزار با تجربه، ۳۴.۱٪ از تسکها (۲۴۹ مورد) را معیوب دانستند.
- مشکلات کلیدی: این محک گاهی پاسخهای درست را رد میکند، پاسخهای ناقص را میپذیرد یا رفتارهایی را میطلبد که در پرامپتها تعریف نشدهاند.

این یافتهها فرضیات جاری در این حوزه را تغییر میدهد؛ چراکه نشان میدهد عاملهای کدنویسی شاید در نقش «بازرسِ بنچمارکها» مفیدتر از نقش «شرکتکننده در تست» باشند. وقتی یک محک پاسخ غلط را درست میپذیرد، امتیاز نهایی نه توانایی مدل، بلکه شکستِ خودِ تست را اندازه میگیرد.
بر اساس مستندات OpenAI، توسعهدهندگان اکنون باید بهجای تکیه مطلق بر رتبهبندیهای لیدربورد، اولویت را بر بررسیهای داخلی «آلودگی دادهها» (Contamination Checks) بگذارند تا مطمئن شوند نام فایلها یا عبارات موجود در دادههای آموزش با پرامپتهای ارزیابی همپوشانی ندارند.
گام بعدی شما
- اگر از SWE-Bench Pro برای ارزیابی مدلهای خود استفاده میکنید، نتایج را با بازرسی انسانی بازبینی کنید.
- برای سنجش واقعی، از تستهای محلی و دادههای دستاول (Out-of-distribution) استفاده کنید.
- بر روی توسعه ابزارهای خودکار برای شناسایی نقص در بنچمارکها متمرکز شوید.
این تنها بخشی از چالشهای ارزیابی است؛ بررسی اثر نشت دادهها بر دقت مدلهای استدلالی را در گزارش بعدی دنبال کنید.



گفتگو