اگر برای پیادهسازی قابلیتهای بومی در اپلیکیشن خود بودجه محدودی دارید، خبر خوب این است که دیگر نیازی به گرانترین مدلهای بازار ندارید. یک مطالعه جدید ثابت میکند که مدلهای اقتصادی میتوانند در وظایف منطقهای، شانه به شانه با غولهای این صنعت حرکت کنند.
طبق گزارشی که در ۱۱ اکتبر ۲۰۲۶ منتشر شد، محک جدیدی به نام Pakistan Local Context LLM Suite نشان میدهد که برای دانش بومی پایه، قیمت مدل اهمیت بسیار کمتری نسبت به کارایی آن دارد. اکثر محکهای جهانی، جزئیات زندگی روزمره در پاکستان را نادیده میگیرند؛ مواردی مثل سیستم عددنویسی لک/کرور (lakh/crore)، منطقه زمانی استاندارد پاکستان (PKT) یا ابهامات خاص خط اردو.
این شکاف باعث میشود مدلها با اعتمادبهنفس کامل پاسخ دهند، اما در سادهترین تبدیلهای محلی شکست بخورند؛ مثلاً وقتی نمیتوانند محاسبه کنند که دو کرور چند لک است. همانطور که در تحلیل قبلی ما دربارهی لایههای هماهنگی برای افزایش موفقیت عاملها اشاره کردیم، این محک اکنون تمرکز را از استدلال کلی به «مبنیسازی» (Grounding) — یعنی شبیه کردن مدل به کسی که واقعاً در یک محیط فرهنگی زندگی کرده و با قواعد آن آشناست — تغییر میدهد. این تست بررسی میکند که آیا یک مدل واقعاً میتواند در یک اقتصاد و جامعه محلی خاص عمل کند یا صرفاً در پاسخ به اطلاعات عمومی انگلیسیمحور موفق است. این چالشها در سایر کشورهای منطقه نیز دیده میشود؛ برای مثال، نیاز مبرم هند به متخصصان هوش مصنوعی نشاندهنده تلاش این منطقه برای کاهش وابستگی به مدلهای غربی و بومیسازی فناوری است.
سازوکار این محک
این مجموعه از پرسشهای کوتاه با پاسخهای قطعی در چهار دستهبندی اصلی استفاده میکند. نویسنده برای تضمین تکرارپذیری، از کتابخانه kaggle-benchmarks استفاده کرده و پاسخها را بهجای استفاده از یک هوش مصنوعی دیگر بهعنوان داور، از طریق تطبیق عبارتهای منظم (regex) امتیازدهی کرده است.
به نقل از مستندات این پروژه، مدلها صراحتاً موظف شدند تنها پاسخ نهایی را بدون هیچ توضیحی ارائه دهند. برای جلوگیری از جریمه شدن پاسخهای درست بهدلیل فرمتبندی، یک تابع نرمالسازی تمام کاماهای داخل اعداد (مثلاً ۱۲,۵۰,۰۰۰) را پیش از بررسی حذف میکند. این محک بر روی یک DataFrame اجرا میشود که در آن برای هر پرسش، یک وظیفه (Task) تعریف شده است.
دستهبندی جزئیات آزمون
- سیستم لک/کرور: این بخش تبدیل بین لک، کرور، عرب و خراب را میسنجد. مثالها شامل تبدیل ۳.۵ کرور به ارقام ساده (۳۵,۰۰۰,۰۰۰)، شناسایی اینکه یک «عرب» دارای ۹ صفر است و دانستن اینکه یک «خراب» برابر با ۱۰۰ عرب است. همچنین سناریوهای دنیای واقعی را شامل میشود، مانند محاسبه حقوق سالانه به لک روپیه برای کسی که حقوق ماهیانه ۸۵,۰۰۰ روپیه دریافت میکند (۱۰.۲ لک).
- زمان PKT: تمرکز بر تبدیل UTC به اسلامآباد (UTC+5) است. این بخش آفستهای پایه را میسنجد، مثلاً اینکه ساعت ۹:۰۰ صبح در اسلامآباد معادل ساعت ۰۴:۰۰ UTC است. همچنین جابهجاییهای پیچیده تاریخ را بررسی میکند؛ برای مثال، اگر ساعت ۲۳:۳۰ UTC در ۱۴ اوت باشد، مدل باید بتواند به درستی تشخیص دهد که تاریخ در اسلامآباد ۱۵ اوت است.
- جغرافیا و مدنی: این بخش مراکز استانها و نمادهای ملی را پوشش میدهد. پرسشها شامل شناسایی پشاور بهعنوان مرکز خیبر پختونخوا، گیلگیت برای گیلگیت-بلتستان و کوئت برای بلوچستان است. همچنین دانش مدل درباره رودخانه سند (سد تربلا)، قانون اساسی ۱۹۷۳، بورس اوراق بهادار پاکستان در کراچی و کوه K2 (که با نامهای گادوین-آستن یا چوگوری نیز شناخته میشود) در مرز چین سنجیده میشود.
- خط اردو: توانایی نوشتن کلماتی مثل «کتاب» (book)، «پانی» (water) و «اسکول» (school) در خط اردو را ارزیابی میکند. همچنین اعداد با خط اردو، مانند عدد ۷ (۷)، و معنای دوگانه کلمه «کل» (که هم به معنای دیروز و هم فردا است) را مورد آزمایش قرار میدهد.
یافتههای کلیدی در عملکرد مدلها
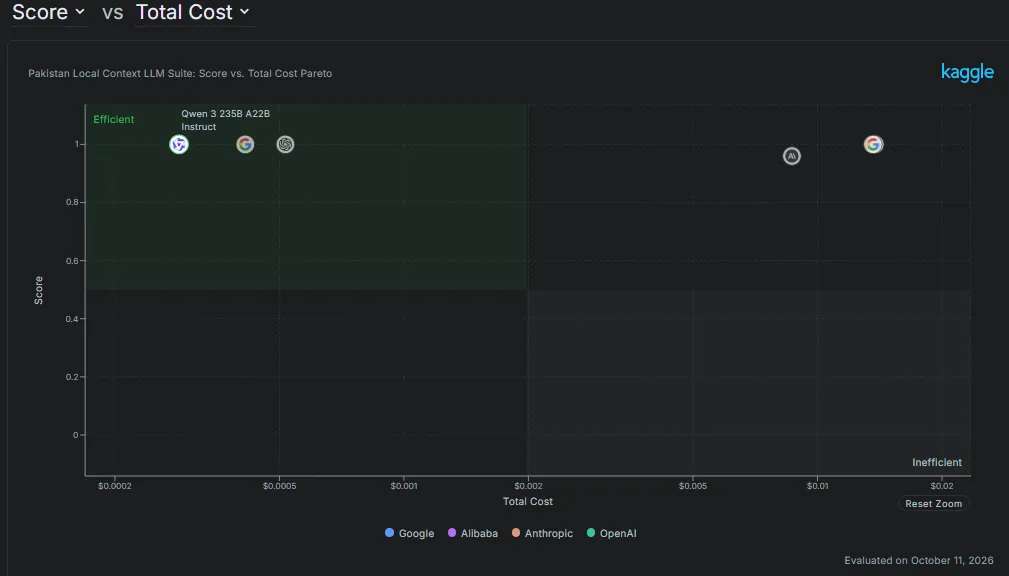
در این آزمون مدلهای متعددی از جمله Qwen 3 235B A22B Instruct و مدلهای Google (Gemini 2.5 Flash و Pro) و OpenAI بررسی شدند. نتایج نشان داد که این محک تقریباً «اشباع» شده است؛ یعنی اکثر مدلهای مدرن و قدرتمند نمرات بسیار بالایی کسب کردهاند و به سقف امتیازات نزدیک شدهاند.
بر اساس گزارش dev.to، تکاندهندهترین یافته، گسست میان هزینه و دقت بود. در حالی که امتیازات در تمام مدلها مشابه بود، هزینه هر اجرا تفاوت فاحشی داشت. هزینهها از حدود ۰.۰۰۰۳ دلار برای ارزانترین مدلها تا چندین هزارم دلار برای گرانترینها متغیر بود. مدل ارزانتری مثل Qwen 3 در «منطقه بهینه» قرار گرفت و دقتی مشابه جایگزینهای بسیار گرانتر ارائه داد.
محدودیتهای تست
کسب نمره بالا در این ۲۵ پرسش به معنای درک کامل پاکستان توسط مدل نیست. این مجموعه از متنهای تکمرحلهای و تمیز استفاده میکند که با دنیای واقعی متفاوت است. همچنین «اردوی رومی» (Roman Urdu) — روشی که اکثر مردم در گوشیهای خود تایپ میکنند — یا پیچیدگی اسناد حقوقی و مالیاتی طولانی در این تست لحاظ نشده است. این موضوع یادآور چالشهای مشابه در استخراج دادههای محلی است، جایی که دستاوردهای جدید در پر کردن شکاف OCR نشان داد که دقت در متون پیچیده بومی همچنان نیازمند ابزارهای تخصصی است.
علاوه بر این، نویسنده اشاره میکند که امتیازدهی با regex بسیار سختگیرانه است. در حالی که این سیستم کاماها را مدیریت میکند، اما اگر یک پاسخ درست با عبارتی غیرمنتظره نوشته شده باشد، ممکن است غلط تشخیص داده شود. بهدلیل کوچک بودن مجموعه سوالات، نباید تفاوتهای جزئی بین مدلها را بیش از حد تفسیر کرد.
تحلیل: چرخش به سمت بهرهوری
برای توسعهدهندگانی که بودجه API محدودی دارند، این یک سیگنال حیاتی است. ثابت شد که برای وظایف بومی تکمرحلهای، «بهترین» مدل لزوماً گرانترین نیست، بلکه بهینهترین است. دوران پرداخت مبالغ هنگفت برای دسترسی به دانش منطقهای پایه به پایان رسیده است.
این تغییر نشان میدهد که بستر متنی (Context Window) — شبیه میز کاری که مدل برای پردازش اطلاعات در اختیار دارد — برای دادههای بومی پایه در مدلهای تراز اول حل شده است. مرز رقابت بعدی دیگر بازیابی حقایق ساده نیست، بلکه مدیریت بخشهای «آشفته» بومیسازی است: جملاتی با زبان ترکیبی و گویشهای محلی.
برای پیشروی در این مسیر، نویسنده قصد دارد موارد دشوارتر و چندمرحلهای شامل محاسبات مالیاتی و بندهای حقوقی را پیادهسازی کند. اندازهگیری ثبات مدلها از طریق اجراهای مکرر نیز کلیدی خواهد بود تا مشخص شود آیا این مدلها واقعاً قابل اعتماد هستند یا صرفاً در پاسخ به پرامپتهای کوتاه خوششانس بودهاند. با این حال، تکیه بر نتایج مدلها بدون تحلیل انسانی ریسکهای خاص خود را دارد و تقویت تفکر انتقادی تنها راه مقابله با وابستگی مطلق به این ابزارهاست. هدف نهایی، حرکت به سمت اندازهگیری «هزینه به ازای هر پاسخ درست» است، زیرا در حال حاضر بیشترین تفاوت بین مدلها در همین نقطه نهفته است.
گام بعدی شما
- اگر از مدلهای گرانقیمت برای استخراج دادههای بومی استفاده میکنید، مدلهای کوچکتر و بهینهتر مثل سری Qwen را تست کنید.
- برای ارزیابی دقیقتر، تستهای خود را به «اردوی رومی» و متون غیررسمی گسترش دهید.
- هزینه هر پاسخ درست (Cost per Correct Answer) را بهجای دقت کلی، بهعنوان معیار انتخاب مدل قرار دهید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو