تصور کنید مدل هوش مصنوعی بهجای حدس زدن پیکسلهای بعدی یک ویدیو، بتواند قوانین بنیادین فیزیک و زیستشناسی را درونی کند و از آنها برای پیشبینی آینده استفاده کند. این دقیقاً همان چیزی است که مدل JEPA-Anything به دست آورده است تا نیاز به مدلهای تخصصی برای هر حوزه علمی را از بین ببرد.
طبق اعلام PhAI Labs و همکارانش از دانشگاههای استنفورد، آکسفورد و پرینستون در ۶ اکتبر ۲۰۲۶، این مدل جهانی میتواند تکامل سیستمها را در هفت حوزه مختلف، از دینامیک سیالات تا انکولوژی، پیشبینی کند. این پژوهش نشان میدهد که یک اصل یادگیری مشترک میتواند جایگزین نیاز به مدلهای خاص هر دامنه در سیستمهای پیچیده فیزیکی و بیولوژیکی شود. مدلهای جهانی پیشین معمولاً با مشکل «میانگینگیری» مواجه بودند؛ وضعیتی که در آن الگوهای ساده، جزئیات پیچیده را در طول آموزش میبلعند. برای حل این مشکل، پژوهشگران از معماری JEPA-Anything استفاده کردند که بر پایه معماری پیشبینی بردار معنایی مشترک (Joint-Embedding Predictive Architecture یا JEPA) اثر یان لکون بنا شده است. برخلاف مدلهای مولد (Generative Models) که سعی در بازسازی دقیق پیکسلها دارند، این معماری خلاصههای انتزاعی از حالتهای آینده را پیشبینی میکند و نویزهای بیاهمیت را فیلتر میکند.
سازوکار JEPA-Anything
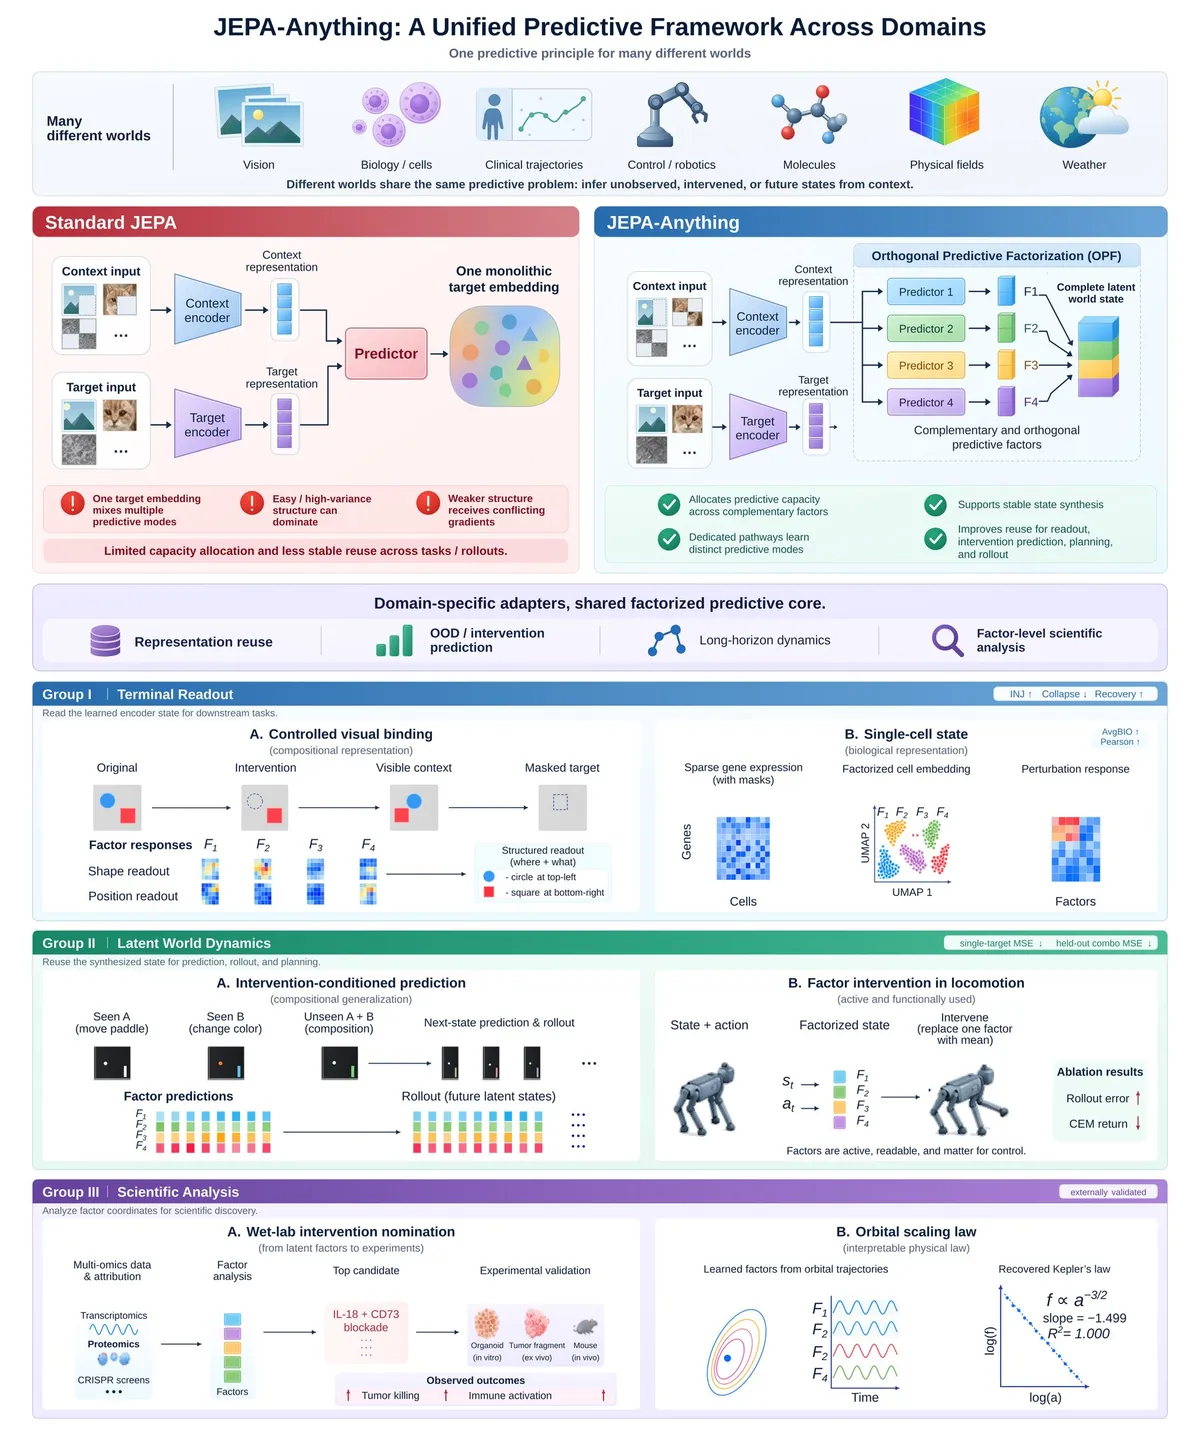
تیم پژوهشی برای افزایش دقت، مکانیزمی به نام تجزیه پیشبینی متعامد (Orthogonal Predictive Factorization یا OPF) را پیادهسازی کردند. بر اساس مستندات این پژوهش، این سازوکار حالت پیشبینیشده را به چهار عامل متعامد تقسیم میکند که هر کدام توسط یک ماژول پیشبین مجزا مدیریت میشوند. این ماژولها مجبورند جنبههای متفاوتی از دادهها را استخراج کنند و سپس مدل، این قطعات را برای رسیدن به حالت کامل جهان بازسازی میکند. به گزارش وبسایت the-decoder.com، پژوهشگران هیچ معنای پیشفرضی به این بخشها ندادهاند و نقش هر ماژول بهصورت ارگانیک در طول آموزش شکل گرفته است.
در این رویکرد، تیم بهجای تعیین نقشهای از پیش تعریف شده، تنها نحوه آمادهسازی دادهها را برای هر حوزه تغییر میدهد. این امر به مدل اجازه میدهد بدون سوگیری انسانی، حیاتیترین محرکهای تکامل یک سیستم را شناسایی کند. با این حال، نویسندگان هشدار میدهند که جداسازی این بخشهای آموختهشده لزوماً به معنای شناسایی روابط علت و معلولی واقعی نیست.
محکهای عملکردی
این مدل در برابر یک خط پایه JEPA تحت شرایط یکسان آزمایش شد و نتایج زیر را به دست آورد:
- دینامیک سیالات: در محک معادله برگرز، خطای پیشبینی نزدیک به ۵۰٪ کاهش یافت. این برتری در ۵۰ گام پیشبینی حفظ شد، هرچند در نهایت به حدود ۳٪ رسید.
- سیستمهای پویا: در محیط سادهشده بازی Pong با مداخلات هدفمند، خطا ۳۵٪ کاهش یافت.
- مداخلات دیدهنشده: برای ترکیبهایی که مدل در طول آموزش هرگز با آنها مواجه نشده بود، خطا ۱۳٪ کمتر شد.
- ثابتهای فیزیکی: مدل با آموزش روی مدارها بدون داشتن مقادیر فیزیکی، مقدار ۱.۴۹۹۱- را برای فرکانس مداری نسبت به اندازه مدار استخراج کرد که تقریباً با قانون سوم کپلر (۱.۵-) مطابقت دارد.
- فیزیک عمومی: JEPA-Anything در ۱۰ تکلیف مختلف در حوزههای فیزیک، رباتیک و پیشبینی وضعیت آبوهوا بهطور مداوم از مدل پایه پیشی گرفت.
- شبیهسازیهای مولکولی: این روش در شبیهسازی آب، کوارتز، استامینوفن و بنزن بهترین امتیاز را کسب کرد و برتری خود را حتی پس از ۱۰۰ گام حفظ نمود.
همانطور که در تحلیلهای پیشین ما دربارهی تکامل مدلهای جهانی و رویکردهای یان لکون اشاره کردیم، هدف نهایی عبور از بازسازی داده به سمت درک ساختاری جهان است.
کاربردهای زیستشناختی و رباتیک
پراگماتیکترین کاربرد این مدل در پژوهشهای سرطان کبد مشاهده شد. JEPA-Anything با تحلیل دادههای زیستشناختی شامل فعالیت ژنها، سطح پروتئینها و غربالگریهای CRISPR، یک درمان ترکیبی را پیشنهاد داد: ترکیب مولکول سیگنالدهنده IL-18 (که سلولهای ایمنی را فعال میکند) با مسدود کردن آنزیم CD73 (که تومورها برای سرکوب پاسخ ایمنی از آن استفاده میکنند).
در آزمایشهای آزمایشگاهی روی ارگانوئیدها، با استفاده از بافت تومور سه بیمار در هر گروه و همچنین روی موشها، این ترکیب بیش از هر یک از درمانها بهتنهایی، سلولهای سرطانی را کشت و سلولهای T و NK (سلولهای کشنده طبیعی) را فعال کرد. اگرچه این مطالعه هنوز به عنوان یک درمان رسمی تایید نشده، اما ثابت میکند مدل میتواند کاندیداهای درمانی viable را شناسایی کند. این دستاورد در راستای تلاشهای گستردهتر برای بهرهگیری از هوش مصنوعی حاکمیتی در مدیریت دادههای سلامت ملی است که هدف آن شخصیسازی درمانها در مقیاس کلان است.
در سایر آزمایشهای بیولوژیکی، مدل توانست انواع سلولها را در دادههای تک-سلولی (single-cell) با قابلیت اطمینان بیشتری تخصیص دهد و پیشبینیهای مربوط به بیش از ۱۰۰۰ رویداد بیماری احتمالی در دادههای بالینی را بهطور جزئی بهبود بخشد. برای دستیابی به چنین دقتی در دادههای پزشکی، استفاده از لایههای اعتبارسنجی حیاتی است؛ مشابه آنچه در سیستمهای پردازش دادههای توانبخشی برای حذف نویزها مشاهده شده است.
در حوزه رباتیک، نتایج متغیرتر بود. مدل در دو محیط شبیهسازیشده پیادهروی بهتر از مدل پایه عمل کرد، اما در محیط سوم، مدل استاندارد JEPA پیروز شد. همچنین در دینامیکهای مبتنی بر پیکسل، برتری مدل بهسختی قابل اندازهگیری بود؛ این نشان میدهد نقطه قوت اصلی این معماری در جریانهای فیزیکی و مسیرهای زیستشناختی است، نه بازسازیهای بصری.
زمینه و تکامل مدلهای جهانی
این چرخش معماری، تکیه شدید بر مدلهای مولد عظیم برای اکتشافات علمی را به چالش میکشد. با تمرکز بر دینامیکهای نهان (Latent Dynamics) بهجای بازسازی دادههای خام، JEPA-Anything نشان میدهد که مدلهای جهانی میتوانند مستقل از حوزه (Domain-agnostic) باشند. این موضوع ما را به هدف نهایی، یعنی عاملهایی که میتوانند بهطور مستقل آزمایشهای فیزیکی را پیشنهاد و رتبهبندی کنند، نزدیکتر میکند.
این مسیر از سال ۲۰۲۲ با کارهای یان لکون آغاز شد. در ژوئن ۲۰۲۵، متا مدل V-JEPA 2 را منتشر کرد؛ یک مدل ویدئویی با ۱.۲ میلیارد پارامتر که بازوهای رباتیک را در محیطهای ناآشنا کنترل میکرد. در نوامبر همان سال، لکون و راندال بالستریرو مدل LeJEPA را برای تثبیت آموزش معرفی کردند. لکون اکنون این مسیر را از طریق AMI Labs دنبال میکند که در مارس ۲۰۲۶ بیش از یک میلیارد دلار سرمایه جذب کرد.
در حالی که ابزارهایی مانند Co-Scientist و C2S-Scale 27B گوگل دیپمایند پیش از این فرضیات دارویی را تولید کردهاند — مانند داروی silmitasertib که در اکتبر ۲۰۲۵ پیشنهاد شد — رویکرد PhAI Labs بر معماری پیشبینی زیربنایی تمرکز دارد. Co-Scientist در حال حاضر میتواند آزمایشها را برنامهریزی کرده و تجهیزات آزمایشگاهی را به کار اندازد، هرچند هنوز برای بارگذاری نمونهها در دستگاهها به انسان نیاز است.
هدف بلندمدت این تیم، ایجاد یک سیستم حلقه-بسته (Closed-loop) است که در آن هوش مصنوعی آزمایش را پیشنهاد دهد، نتیجه را دریافت کند و مدل جهانی خود را در لحظه بهروزرسانی کند.
پژوهشگران کد و مدلهای خود را بهصورت عمومی منتشر کردهاند تا جامعه علمی بررسی کند که آیا این الگوهای پیشبین در حوزههای تخصصی دیگر تکرار میشوند یا خیر.
گام بعدی شما
- بررسی مستندات OPF برای درک نحوه تجزیه متغیرهای سیستم در دادههای خودتان.
- تست مدل روی مجموعهدادههای دینامیک سیالات برای مقایسه نرخ خطا با مدلهای بازگشتی.
- دنبال کردن پیشرفتهای AMI Labs در زمینه مدلهای استدلالی فیزیکی.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell و بهینهسازی استنتاج مدلهای جهانی مراجعه کنید.



گفتگو