اگر تصور میکنید مدلهای هوش مصنوعی دقیقاً تا تاریخ اعلامشده توسط شرکت سازنده را میشناسند، احتمالاً در اشتباهید. تفاوت میان «دانش واقعی» و «ادعای رسمی» در مدلهای پیشرو، شکافی عمیقتر از آن است که تصور میکردیم.
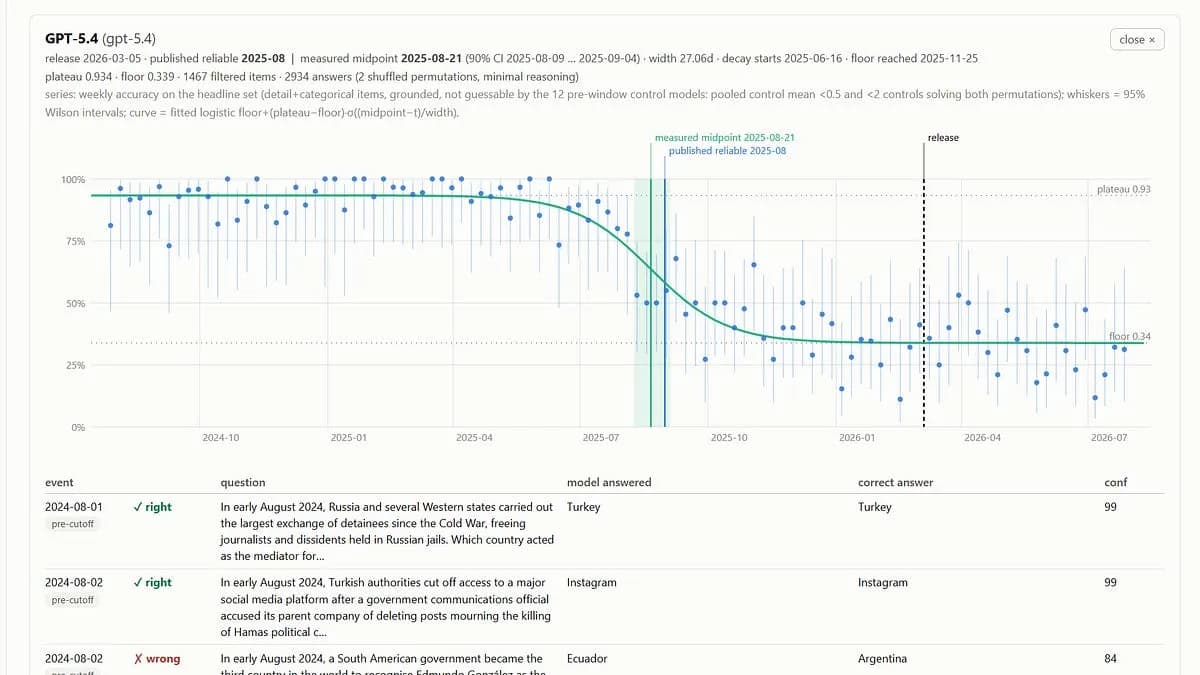
بر اساس گزارش منتشر شده در ۱۰ اوت ۲۰۲۶ در وبسایت blog.sshh.io، روشی به نام «کاوشهای دانش ناپذیر» (Incompressible Knowledge Probes) توانسته است نقاط بازرسی (Checkpoint) پنهان در آموزش GPT-5 و Claude را شناسایی کند. این متدولوژی با آزمایش مدلها روی حقایق بسیار جزئی و روزمره ویکیپدیا، دقیقاً زمانی را تخمین میزند که پیشآموزش (Pre-training) — یعنی مرحلهای که مدل مثل دانشآموزی است که میلیاردها صفحه وب را برای یادگیری کلیات میخواند — به پایان رسیده است.
این کاوشها با امتیازدهی به مدلها در مورد حقایق بسیار خاص، تلاش میکنند تعداد پارامترهای مدلهایی مانند GPT-5 و Opus را تخمین بزنند. علاوه بر این، تکنیکی به نام «استنتاج ترکیب دادهها» (Data Mixture Inference) به محققان اجازه میدهد تا با اندازهگیری نحوه تجزیه توکنها توسط مدل، حقایقی را درباره ترکیب مجموعهدادهها (Dataset Mixtures) فاش کنند. با امتیازدهی به مدلها در مورد سوالات مربوط به تاریخ یا شناسایی خود، میتوان خط زمانی آموزش را تخمین زد، هرچند به دلیل نبود دادههای مرجع (Ground Truth) عمومی، این اعداد همچنان در حد تخمینهای بسیار دقیق هستند.
این کشف در حالی رخ میدهد که آزمایشگاههای هوش مصنوعی به یک خط لوله سه مرحلهای برای آموزش روی آوردهاند. برای درک بهتر، صنعت اکنون بر روی این سه گام متمرکز شده است:
۱. پیشآموزش: استخراج حجم عظیمی از دادههای عمومی اینترنت برای ساخت یک مدل عظیم تکمیلکننده متن (Auto-complete).
۲. گسترش قابلیتها: استفاده از دادههای تخصصی با کیفیت «کتاب درسی» برای بهبود مدلهای پایه و گسترش قابلیتهایی مانند درک متون بسیار طولانی.
۳. تنظیم شخصیت: تبدیل مدل پایه به یک «دستیار» (Assistant)، صیقل دادن شخصیت، توانایی استدلال و قابلیت فراخوانی ابزارها (Tool-calling).
همانطور که در تحلیل قبلی ما دربارهی نحوه استفاده Anthropic از لایههای حفاظتی پیچیده برای خودکارسازی مهاجرت پایگاه دادهها اشاره کردیم، لایههای حفاظتی تنها بخشی از ماجرا هستند؛ اما اینجا بحث بر سر دادههای خامی است که زیربنای مدل را میسازند. تولید یک نقطه بازرسی پیشآموزش — مانند یک فایل عظیم با نام claude-super-secret-2026-11-01-base.cpkt — یکی از گرانترین و دادهبرترین مراحل در کل این فرآیند است.
سازوکار جریان آموزش
در یک آزمایشگاه استاندارد، تیم «پیشآموزش» یک اجرای چند ماهه را مدیریت میکند تا یک نقطه بازرسی پایه تولید کند. این نقاط بازرسی معمولاً به معنای عرضه نسخههای اصلی هستند، مانند پرش بزرگ از GPT-4 به GPT-5.
به طور همزمان، تیمهای «قابلیت» و «پسآموزش» (Post-training) آزمایشهایی را برای بهبود آخرین مدل پایه اجرا میکنند. این پیشرفتها در قالب بهروزرسانیهای نسخههای فرعی (Minor versions) ظاهر میشوند. این تیمها همچنین یک مدل پسآموزشدیده را به مدلهای کوچکتر «تقطیر» (Distill) میکنند تا خانوادههای مدل ایجاد کنند؛ مانند Fable، Opus، Sonnet و Haiku، یا Sol، Terra و Luna. این فرآیند در واقع همان رویکرد تقطیر دادههای مصنوعی است که مدلهای بزرگ را به مدرسانی برای آموزش مدلهای کوچکتر تبدیل میکند. حتی ممکن است آزمایشگاهها مدلهای پسآموزشدیده را از نقاط بازرسی «نیمهپخته» منتشر کنند، اگر درصدی از نقطه بازرسی نسخه N+1 عملکرد بهتری نسبت به نسخه کاملاً پخته N داشته باشد.
مدل را مانند یک کپسول زمان دیجیتال تصور کنید. اگر از مدل درباره اتفاقی در ۱۵ ژانویه ۲۰۲۶ بپرسید و پاسخ ندهد، اما همه چیز تا ۱۴ ژانویه را بداند، شما لبهٔ «تاریخ قطع دانش» (Knowledge Cutoff) را یافتهاید. محققان برای تخمین این تاریخها، مجموعهدادهای از حقایق روزانه ویکیپدیا (مثلاً وقایع ایالات متحده در سال ۲۰۲۵) ساختند و به مدلها یک آزمون چندگزینهای ۸-گزینهای دادند. با تحلیل خط زمانی نرخ خطا، نقطهای که مدل سیگنال دادههای آموزشی خود را از دست میدهد، کاملاً شفاف میشود.
تناقضهای زمانی در مدلهای پیشرو
- GPT-5.6 شرکت OpenAI به نظر میرسد از نقطهای بازرسی میآید که در اواخر فوریه ۲۰۲۶ به پایان رسیده است. این موضوع آن را از تبار GPT-5.5 متمایز میکند و نشان میدهد که به جای یک بهروزرسانی ساده در پسآموزش، یک اجرای کامل پیشآموزش جدید صورت گرفته است. برای GPT-5.4، تاریخ قطع دانش تخمینزده شده با تاریخ اعلام شده توسط OpenAI همخوانی دارد، هرچند منحنی خطا نرم است زیرا مدلها میتوانند وقایع نزدیک به آینده را حدس بزنند یا به دلیل کمبود نمونه در دادههای اخیر دچار خطا شوند.
- مدلهای Opus 4.7 و مدلهای بعدی Anthropic همگی تاریخ قطع مشابهی در اواخر دسامبر ۲۰۲۵ دارند. این امر نشان میدهد که همگی از یک اجرای پیشآموزش عظیم مشترک مشتق شدهاند. محقق فرض میکند که تاریخ تکمیل پیشآموزش همبستگی بالایی با بازه زمانی مجموعهداده مورد استفاده دارد.
- Opus 5 یک پارادوکس است. با اینکه تاریخ قطع قابل اعتماد رسمی آن مه ۲۰۲۶ اعلام شده، اما کاوشها نشان میدهد که این مدل هیچ دانشی بیش از مدلهای ژانویه ۲۰۲۶ ندارد. تستهای حذف (Ablation tests) تایید کردند که این موضوع نتیجهٔ نوع سوالات نیست؛ بلکه این قطع دانش حتی در مورد یادآوری نسخههای بستههای کدنویسی (Coding package versions) نیز وجود دارد.
- مدل Luna در برخی نمودارها شبیه به «پیشگویی آینده» عمل میکند، اما این در واقع یک خطای آماری ناشی از نرخ خطای بالا است که به دلیل «تلاش استدلالی» (Reasoning effort) پایین رخ داده است.

رمزگشایی از هویت مدلها
محققان همچنین از «کاوشهای هویتی» استفاده کردند تا ببینند مدلها فکر میکنند چه کسی هستند. وقتی مدلها بدون پرامپت سیستمی (System Prompt) تحت فشار قرار میگیرند — با استفاده از ۵ نوع عبارتبندی در ۱۰ نمونه و تحریک به حدس زدن — اغلب دادههایی را که با آنها تغذیه شدهاند افشا میکنند.

نوارهای عمودی در دادهها نشان میدهد که آزمایشگاهها در حال آموزش مدلها روی خروجیهای مدلهای گذشته هستند. مدلهای OpenAI مکرراً خود را GPT-4، GPT-4o، GPT-4.1، GPT-5 یا صرفاً «ChatGPT» معرفی میکنند. مدلهای Anthropic به Sonnet 3.5 و اخیراً Sonnet 4.5 اشاره میکنند. این موضوع قویاً نشان میدهد که جلسات چت کاربران در ChatGPT.com و Claude.ai مستقیماً به چرخه آموزش بازمیگردند، زیرا این هویتها در جلسات چت مصرفکننده تعبیه شدهاند و نه در مجموعهدادههای مصنوعی داخلی.

یکی از یافتههای جالب و بحثبرانگیز این است که Sonnet 5 به طور منظم خود را GPT-4 معرفی میکند. در حالی که بعید است این یک تقطیر عمدی باشد، اما نشان میدهد که لاگهای قدیمی ChatGPT باعث آلودگی ترکیب آموزشی Claude شدهاند یا این هویت از تبار Sonnet 3.5 به ارث رسیده است. در این راستا، تحقیقات جدیدتر نشان میدهد که تقطیر مدلها لزوماً باعث انتقال سوگیریهای ایدئولوژیک یا سانسورهای مدل معلم نمیشود، اما آلودگی دادهای در سطح هویت مدل همچنان یک چالش است.

در یک آزمایش تکمیلی، مدلهای Claude توانستند با دقت ۶۸٪ ویژگیهای خاص مدلهای OpenAI را بازتولید کنند (زمانی که از آنها خواسته شد «مانند مدل X» پاسخ دهند). در مقابل، مدلهای OpenAI تنها ۸٪ در تقلید از Claude موفق بودند.

توهم پسآموزش
محققان همچنین از مدلها پرسیدند که تاریخ امروز چندم است. در حالی که مدلهای OpenAI از برخی از این دادهها حذف شدهاند (زیرا API تاریخ واقعی را به درخواستها تزریق میکند)، سایر مدلها همبستگی بین تاریخهای گزارششده و دانش واقعی را نشان میدهند.
برخی مدلها «فکر میکنند» در گذشته زندگی میکنند، در حالی که برخی دیگر از طریق پسآموزش بهروز شدهاند. برای مثال، خانواده GPT-4.1 (از Nano به Mini و سپس GPT-4.1) و خانواده Anthropic (از Opus 4.7 به Sonnet 5 و سپس Fable/Opus 5) نوارهای عمودی را در نمودار نشان میدهند. این بدان معناست که بدنه دانش پیشآموزش (X) ثابت مانده اما رفتار پسآموزشدیده (Y) افزایش یافته است. این نشان میدهد که آزمایشگاهها از مجموعهدادههای «دارای سوگیری تازگی» (Recency-biased) در مرحله نهایی تنظیم استفاده میکنند تا مدلها بهروزتر به نظر برسند، بدون اینکه هزینه محاسباتی یک پیشآموزش کامل را بپردازند. مدلهای کوچکتر ممکن است تاریخهای قدیمیتری را گزارش کنند زیرا از مدلهای معلم (Teacher models) قدیمی تقطیر شدهاند.
این تغییر در حوزه هوش مصنوعی نشان میدهد که «تاریخ قطع دانش» دیگر یک تاریخ واحد نیست، بلکه یک طیف لایهبندی شده است: ما دانش پایه (پیشآموزش) و یک لایه ظاهری رفتاری (پسآموزش) داریم. برای کاربر نهایی، این یعنی مدل ممکن است به دلیل پرامپت سیستمی بتواند تاریخ امروز را به شما بگوید، اما در واقع نتواند درباره اتفاقاتی که بعد از نقطه بازرسی پایه رخ داده است استدلال کند.
این وضعیت یک شکاف شفافیت ایجاد میکند. وقتی یک آزمایشگاه ادعا میکند مدلی «تا سال ۲۰۲۶ بهروز شده است»، ممکن است به یک لایه نازک از دادههای پسآموزش اشاره کند، نه یک گسترش بنیادی در دانش جهانی مدل.
برای اینکه بفهمید مدل فعلی شما درباره سن خود دروغ میگوید یا خیر، سعی کنید آن را با وقایع بسیار خاص و جزئی ۶ ماه اخیر که در خلاصههای عمومی ظاهر نمیشوند، به چالش بکشید.
گام بعدی شما
- برای تست صداقت مدل خود، درباره وقایع بسیار جزئی و تخصصی ۶ ماه اخیر بپرسید که در خلاصههای خبری عمومی نیستند.
- در تحلیلهای خود، تفاوت بین «دانش استدلالی» (پایه) و «اطلاعات بهروز» (لایه ظاهری) را در نظر بگیرید.
- اگر توسعهدهنده هستید، به جای تکیه بر تاریخ قطع اعلام شده، از RAG برای تضمین بهروز بودن دادهها استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو