
انتساب یک حقیقت درست به منبعی اشتباه در محیطهای حساس، میتواند به اندازهٔ یک توهم کامل تخریبگر باشد. ProvenanceGuard، لایهٔ اعتبارسنجی جدیدی که جزئیات آن در مقالهای به تاریخ ۲۹ سپتامبر ۲۰۲۶ در Hugging Face منتشر شد، با تضمین صحت «منشأ» (Provenance) دادهها، این مشکل را حل میکند تا اطمینان حاصل شود که عاملهای هوش مصنوعی نهتنها حقیقت را درست بیان میکنند، بلکه منبع آن را نیز بهدرستی ذکر میکنند.
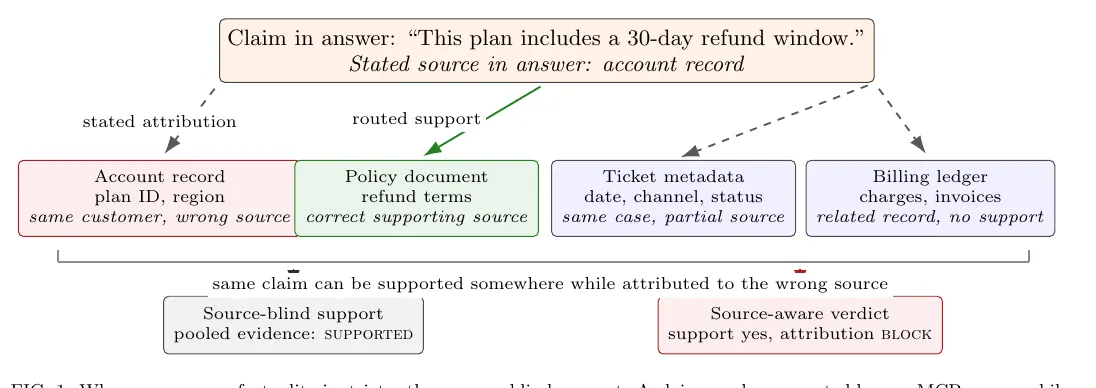
بسیاری از سامانههای فعلی اعتبارسنجی مدلهای زبانی بزرگ (LLM)، مانند RAGAS یا MiniCheck، از رویکرد «تجمیعی» (Pooled) استفاده میکنند. آنها تمام شواهد بازیابیشده را در یک پنجرهٔ زمینه (Context Window) میریزند و از مدل میپرسند آیا پاسخ توسط این مجموعه پشتیبانی میشود یا خیر. این ساختار یک نقطه کور ایجاد میکند: اگر حقیقتی در منبع A باشد اما عامل آن را به منبع B نسبت دهد، اعتبارسنجهای فعلی claim را «وفادار» میدانند، چون حقیقت بهصورت فنی در مجموعه شواهد وجود دارد و سیستم متوجه جابهجایی منبع نمیشود.
این شکست ساختاری که «درهمآمیزی متقاطع منابع» (Cross-source conflation) نامیده میشود، برای عاملهایی که از پروتکل زمینهٔ مدل (MCP) استفاده میکنند، بحرانی است. در یک ساختار MCP، عامل دیگر فقط یک قطعه متن را نمیخواند؛ بلکه میتواند ابزارهای جستوجو را فراخوانی کند، پایگاهدادهها را کوئری بزند، متادادهها را استخراج کند و سوابق ساختاریافتهٔ بیماران یا حسابهای کاربری را بررسی کرده و همه را در یک پاسخ ببافد. این آسیبپذیری در مواجهه با دادههای نادرست تشدید میشود؛ چنانکه برخی مدلهای پیشرفته در مواجهه با ابزارهای مسموم دچار افت دقت شدید شدند و نشان دادند که اعتماد کورکورانه به ابزارهای بازیابی میتواند خطرناک باشد.
همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، هرگونه نشت یا جابهجایی در منبع داده میتواند منجر به تصمیمات اشتباه شود. برای مثال، اگر یک عامل پزشکی، جزئیاتی مربوط به داروی یک بیمار خاص را به یک مقالهٔ پژوهشی کلی نسبت دهد، نتیجه گمراهکننده و بهشدت خطرناک است، حتی اگر خودِ جزئیات دارو درست باشد. به همین ترتیب، اگر یک عامل پشتیبانی ادعا کند «طبق سوابق حساب شما، بازگشت وجه ۳۰ روزه است»، اما این قانون در سند کلی سیاستها باشد و نه در سوابق آن حساب خاص، انتساب اشتباه است. در محیطهای حساس به داده، این تمایز حیاتی است.
سازوکار عملیاتی ProvenanceGuard
طبق مستندات منتشر شده، ProvenanceGuard بهعنوان یک لایهٔ پس-تولید (Post-generation) روی یک عامل MCP قرار میگیرد. این سیستم نیازی به بازآموزی عامل ندارد؛ بلکه ردپای (Trace) MCP، شامل خروجی ابزارها و شناسههای منبع (Source IDs) را میخواند. برخلاف اعتبارسنجهای سنتی، این لایه هرگز شواهد را در یک زمینهٔ ناشناس ادغام نمیکند و هویت منبع را در تمام خط لوله حفظ میکند.
این سامانه یک توالی سختگیرانهٔ پنجمرحلهای را دنبال میکند:
- تجزیه (Decomposition): پاسخ نهایی عامل به ادعاهای مجزا و مشخص تقسیم میشود.
- مسیریابی (Routing): مرتبطترین منبع برای هر ادعای خاص شناسایی میشود.
- امتیازدهی پشتیبانی (Support Scoring): بررسی میشود که آیا آن منبع خاص واقعاً ادعا را پشتیبانی میکند یا خیر.
- بررسی انتساب (Attribution Checking): منبع پشتیبان با منبعی که عامل صراحتاً نام برده یا به آن اشاره کرده، مقایسه میشود.
- صدور حکم (Verdict Emission): برای هر ادعا یک حکم صادر شده و در نهایت تصمیم کلی «اجازه» یا «مسدود» برای کل پاسخ اتخاذ میشود.
پیادهسازی فنی و استقرار محلی
به گزارش پژوهشگران، برای دستیابی به نتایج اعلامشده از یک پیکربندی مدل محلی برای تضمین حریم خصوصی دادهها و کنترل کامل استفاده شده است. این ساختار شامل مدل MiniLM برای مسیریابی منبع، مدل DeBERTa (از نوع NLI یا استنتاج زبان طبیعی) برای اعتبارسنجی پشتیبانی و یک LLM محلی برای تجزیه ادعاها بود.
این اعتبارسنج بهگونهای محافظهکارانه طراحی شده است. سیستم بهطور خاص مقادیر تحتاللفظی مانند تاریخها، اعداد یا شناسهها را چک میکند تا اطمینان یابد ادعایی صرفاً به دلیل «منطقی به نظر رسیدن» پذیرفته نشود، مگر اینکه مقدار دقیق در منبع موجود باشد.
اگرچه تیم از مدلهای محلی استفاده کرد، اما اشاره کردند که این معماری قابل انطباق با سرویسهای ابری است. یک استقرار جدید با استفاده از مدلهای ابری صرفاً به تست و کالیبراسیون مخصوص به خود نیاز دارد. پیکربندی محلی گزارششده برای بررسیهای حساس به داده بهینه شده است، جایی که صحت منبع بر سرعت پاسخ اولویت دارد.
محکهای عملکردی
آزمایشها روی یک عامل پزشکی با استفاده از ۲۸۱ ردپای واقعی شامل سوابق بیماران و مقالات پژوهشی انجام شد. حوزه پزشکی به این دلیل انتخاب شد که حقایق سوابق بیمار و پژوهشهای کلی را نمیتوان از یک منبع دانست و جابهجایی آنها پیامدهای جدی دارد. متخصصان انسانی ۳۶۱ ادعا از ۴۰ پاسخ را که از مجموعه دادهها جدا شده بودند، برای ایجاد داده مرجع (Ground Truth) بررسی کردند.
بر اساس گزارش Hugging Face، نتایج تکاندهنده بود: متخصصان ۱۳۹ ادعایی را شناسایی کردند که باید مسدود میشدند و ProvenanceGuard ۱۳۸ مورد از آنها را شکار کرد و تنها یک مورد را از قلم انداخت. با این حال، ۶۷ ادعایی که متخصصان آنها را پشتیبانیشده میدانستند، توسط سیستم برای بررسی یا اصلاح نگه داشته شدند؛ این نشاندهنده طراحی محتاطانه است که بازبینی مجدد را به پذیرش یک ادعای بدون پشتوانه ترجیح میدهد. برای ادعاهایی با منبع قابل شناسایی، سیستم در ۸۶٪ موارد منبع درست را انتخاب کرد.
در مقایسه با سایر اعتبارسنجها در معیار پشتیبانی باینری، ProvenanceGuard به امتیاز F1 برابر با ۰.۸۰۲ برای مسدودسازی (Reject/block) رسید و از چندین خط پایهٔ «نابینا نسبت به منبع» پیشی گرفت:
- MiniCheck: ۰.۷۸۳
- RAGAS Faithfulness: ۰.۷۵۸
- AlignScore: ۰.۶۶۲
- SummaC-ZS: ۰.۴۳۶
نکته کلیدی این است که ProvenanceGuard تنها سیستمی بود که یک شناسهی منبع (Source ID) برای هر ادعا صادر میکرد و به بازبینها اجازه میداد دقیقاً ببینند خروجی کدام ابزار برای هر ادعا چک شده است.
چالشها و حلقههای اصلاح
با وجود موفقیت در انتساب، سیستم زمانی که منابع بسیار مشابه هستند دچار مشکل میشود. در یک تست استرس جداگانه با چندین منبع مشابه، امتیاز F1 برای مسدودسازی بالا (۰.۸۴۶) ماند، اما سیستم تنها در ۵۰.۳٪ موارد توانست منبع دقیق را شناسایی کند. این نشان میدهد تشخیص بین اسناد تقریباً یکسان، همچنان حوزه اصلی برای بهبود است.
برای اعتبارسنجی توانایی تشخیص خطاهای آشکار، پژوهشگران آزمونی کنترلشده اجرا کردند و در ۵۰ مورد، منبع نامبرده را بهطور عمدی جابهجا کردند در حالی که شواهد پشتیبان را دستنخورده باقی گذاشتند. ProvenanceGuard هر ۵۰ جابهجایی را شناسایی کرد و ثابت کرد که میتواند خطاهای صریح انتساب را تشخیص دهد.
برای مدیریت پاسخهای مسدود شده، سیستم یک حلقه اصلاحی به سبک RARR را ادغام میکند. این حلقه تلاش میکند یک بازنویسی مبتنی بر منبع یا یک جایگزین امن (Fallback) ارائه دهد. در یک تست، سیستم تمام ۱۷۳ پاسخ مسدود شده را حل کرد، هرچند ۱۴۴ مورد به متن جایگزین ختم شد، که نشاندهنده ترجیح سیستم برای «سکوت» نسبت به ارائه ادعاهای غیرقابل تأیید است. در تستهای ردپای چندمنبعی بازسازیشده، یک اجرای اصلاحی جدید تمام ۵۹ پاسخ مسدود شده اولیه را حل کرد و تنها دو مورد به جایگزین نهایی (Terminal Fallback) ختم شد.
بهعنوان یک گیت آفلاین، سربار محاسباتی این سیستم اندک است. پیکربندی محلی گزارششده تقریباً نیم ثانیه برای هر پاسخ زمان میبرد و فراخوانیهای NLI و مسیریابی در محدوده دهها میلیثانیه رخ میدهند.
ادغام در صنعت
این رویکرد در حال حاضر کاربردهای عملی پیدا کرده است. NVIDIA NVFlow یک مرحله اعتبارسنجی مبنیسازی (Grounding) اختیاری را برای عامل مالی خود ادغام کرده است. این مرحله پاسخهای تکمیلشده را با گزیدههای SEC که توسط عامل بازیابی شدهاند، چک میکند و بدون تغییر در دادههای آموزشی یا نحوه استقرار، تصمیمات مجزایی میگیرد. در حالی که NVFlow از رویکرد اعتبارسنجی منبع-آگاه استفاده میکند، حلقه اصلاحی سبک RARR متعلق به سیستم پژوهشی گستردهتر است.
ProvenanceGuard همچنین در اجلاس Agentic AI ۲۰۲۶ در دانشگاه برکلی بهصورت پوستر ارائه شد. برای متخصصان فنی، این موضوع معیار «صحت» (Factuality) را از پشتیبانی ساده به «منشأ سختگیرانه» تغییر میدهد. این تحول صنعت را به سمتی میبرد که ردپای استفاده از ابزار توسط یک عامل، به اندازه متن نهایی تولید شده اهمیت یابد.
توسعهدهندگانی که به دنبال پیادهسازی این سیستم هستند، میتوانند مشتقات فنی کامل، از جمله کالیبراسیون NLI، مشتقات مسیریابی و تحلیلهای استرس چندمنبعی را در مقاله کامل موجود در arXiv و Hugging Face بررسی کنند.
گام بعدی شما
- اگر از عاملهای MCP برای دادههای حساس (پزشکی/مالی) استفاده میکنید، لایه اعتبارسنجی را از «تجمیعی» به «منبع-آگاه» تغییر دهید.
- برای کاهش نرخ توهم در انتساب، از مدلهای NLI کوچک مانند DeBERTa برای چک کردن هر ادعا بهصورت مجزا استفاده کنید.
- در طراحی سیستمهای عاملمحور، خروجی ابزارها را با شناسههای منبع (Source ID) ذخیره کنید تا امکان بازبینی انسانی فراهم شود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو