تصور کنید مدیر فروش و مدیر مالی یک شرکت، هر دو یک سؤال مشابه را از هوش مصنوعی میپرسند، اما در جلسه هیئتمدیره دو عدد کاملاً متفاوت ارائه میدهند. این کابوسِ «تعدد حقیقت» در سازمانها، دلیل اصلی پیدایش QueryStory است؛ استارتاپی با ارزش ۶۰ میلیون دلار که هدفش متوقف کردن مدیران از تکیه بر پاسخهای «شکننده» هوش مصنوعی است؛ پاسخهایی که فاقد ردپای مستند (Paper Trail) هستند. این پلتفرم که توسط شاپور نقیبزاده (Shapor Naghibzadeh)، مهندس سابق سیستمهای گوگل بنیانگذاری شده، نحوه پرسوجوی سازمانهای بزرگ از پایگاهدادههای اختصاصی را تغییر میدهد تا دانش تأییدشده را بر حدسهای زاینده اولویت دهد.
بسیاری از شرکتها در حال حاضر دادههای خود را به یک رابط چت متصل میکنند. به باور نقیبزاده، این رویکرد باعث ایجاد «پراکندگی محتوا» میشود؛ جایی که کارکنان مختلف، نسخههای متفاوتی از حقیقت را دریافت میکنند. برای مثال، اگر یک مدیر فروش و یک مدیر مالی یک سؤال بپرسند اما هوش مصنوعی فیلترهای متفاوتی را به صورت توهمآمیز اعمال کند، نتایج متناقضی در اسلایدهای ارائه ظاهر میشود. QueryStory قصد دارد این هرجومرج را با یک روایت مستدل جایگزین کند که مستقیماً به دادههای منبع گره خورده است.
ریشههای QueryStory در اتاق جنگ گوگل
رویکرد نقیبزاده به دادهها از یک تجربه حساس و پرمخاطره در سال ۲۰۰۹ شکل گرفت. طبق اعلام وی، زمانی که به عنوان مهندس سیستمهای گوگل فعالیت میکرد، برای رسیدگی به «عملیات آئورورا» (Operation Aurora) به یک اتاق جنگ (War Room) فراخوانده شد. این عملیات، مجموعهای از حملات سایبری گسترده بود که توسط چین و با هدف قرار دادن غول جستجوی گوگل سازماندهی شده بود. ردیابی این حملات در میان شبکههای پراکنده و متناقض به او آموخت که «دانش تأییدشده» چه ارزش حیاتی دارد، هرچند متوجه شد که این فرآیند ردیابی بسیار هزینهبر و زمانبر است.
او شش سال بعدی را در تقاطع امنیت سایبری و دادهها گذراند و ابزارهایی ساخت تا تحلیلگران امنیتی بتوانند پرسوجوهای پیچیدهای را روی دادهها اجرا کنند. در سال ۲۰۱۶، او شرکت Chronicle را در آزمایشگاه X گوگل بنیانگذاری کرد تا این قابلیتها را در اختیار سایر شرکتها قرار دهد. این مسیر شغلی در نهایت به خلق QueryStory منجر شد؛ ابزاری که نقیبزاده آن را راهی برای «داستانسرایی با دادهها» توصیف میکند، زیرا روایتی را میسازد که بر پایه حقیقت استوار است. این تخصص در زیرساختهای گوگل در حالی شکل گرفت که این شرکت در سالهای اخیر تغییرات ساختاری گستردهای را برای جداسازی عملیات محصول از پژوهشهای AGI تجربه کرده است تا سرعت نوآوری خود را افزایش دهد.
این شرکت در اواخر سال ۲۰۲۵، مبلغ ۶ میلیون دلار سرمایه در مرحله Seed از Brightmind Ventures و New York Life Ventures جذب کرد. تیم مؤسس دارای تجربه عمیقی در زیرساختهاست: نقیبزاده پیش از این Chronicle را بنیانگذاری کرده بود، استنلی یانگ (Stanley Yang) به عنوان مدیر فنی (CTO)، مهندس ارشد سابق در EvolutionIQ و همکار پیشین نقیبزاده در گوگل است و دیوید گلسیک (David Glusic) به عنوان مدیر محصول (CPO) از شرکت Accenture به این تیم پیوسته است.
مکانیزم ایجاد اعتماد
QueryStory برای پر کردن «شکاف اعتماد» در سازمانها و تمایز خود از عاملهای هوش مصنوعی عمومی، از چندین قابلیت شفافساز استفاده میکند:
- نمایش خودکار SQL: برخلاف ابزارهایی مانند Claude Cowork که در آنها کاربر باید بهطور دستی درخواست مشاهده کد را بدهد، QueryStory بهطور خودکار پرسوجوهای SQL (زبان استاندارد ارتباط با پایگاهداده) را که برای استخراج دادهها استفاده شده، نمایش میدهد. این ویژگی باعث میشود مدیران دیگر نیازی نداشته باشند برای بررسی دستی هر پرسوجو، آنها را به تحلیلگران داده ارجاع دهند.
- شاخصهای اطمینان: پلتفرم شامل یک معیار (Metric) خاص است که نشان میدهد چرا عاملهای هوش مصنوعی معتقدند یک تحلیل خاص دقیق است. این لایه از شفافیت معمولاً در ابزارهای آزمایشگاههای پیشرو (Frontier Labs) وجود ندارد.
- بازبینی انسانی در چرخه: کاربران میتوانند تحلیلهای خاص هوش مصنوعی را برای بازبینی توسط همکاران انسانی علامتگذاری کنند و این تأییدات بهصورت دائمی در پلتفرم ثبت میشوند.
- محصولیسازی قضاوت: هدف این پلتفرم جایگزینی نیاز به «ارتشهایی از مهندسان مستقر در محیط مشتری» است؛ این کار از طریق تبدیل «قضاوت» مورد نیاز برای تأیید دادهها به یک قابلیت محصولی (Productized Judgment) صورت میگیرد.
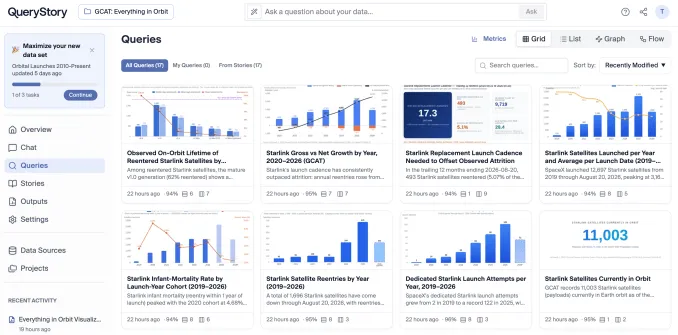
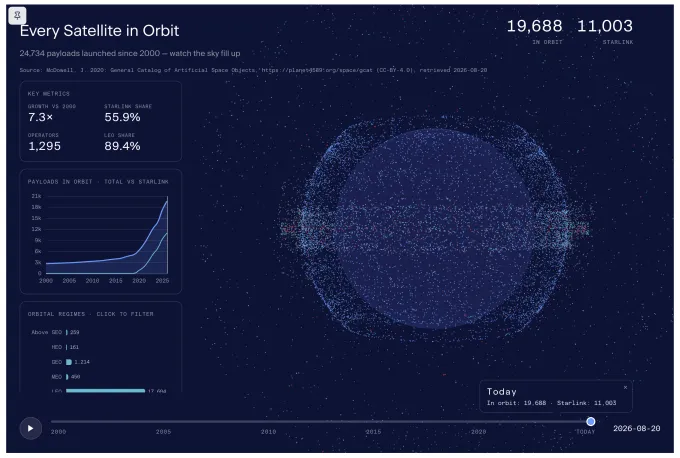
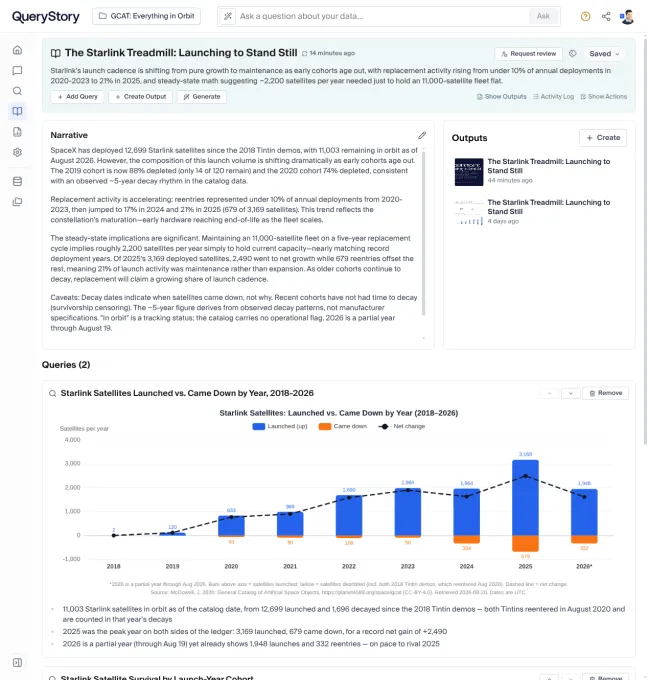
در یک تست عملی که روی دادههای فعالیتهای فضایی برای ردیابی شرکتهایی مانند SpaceX انجام شد، این پلتفرم توانست داشبوردهای پیچیده و بصریسازیهای پیشرفتهای را تنها در عرض چند ساعت تولید کند؛ وظیفهای که پیش از این، تکمیل آن توسط یک توسعهدهنده چندین هفته زمان میبرد.
مقیاسپذیری و کاربردهای سازمانی
این پلتفرم برای سازمانهای بزرگی طراحی شده که پایگاهدادههای اختصاصی و حجیمی را مدیریت میکنند و کاربرانی مانند مدیران عملیات و تیمهای فروش را هدف قرار داده است. تیم دل بلو (Tim Del Bello)، شریک New York Life Ventures و یکی از سرمایهگذاران شرکت، در حال حاضر از این پلتفرم برای جایگزینی کارهای دستی چندین نفر استفاده میکند. او از این ابزار برای تولید گزارشهای بررسی کسبوکار فصلی (Quarterly Business Review) بهره میبرد و هدفش تبدیل این گزارشها به یک داشبورد لحظهای (Real-time) است.
دل بلو اشاره میکند که این محصول برای تصمیمگیرندگانی در صنایع با نظارت شدید (Regulated Industries) ساخته شده است؛ کسانی که به «داده مرجع» (Ground Truth) از منابع دادهای پیچیده و پراکنده نیاز دارند، اما تیمهای اختصاصی علوم داده یا هوش تجاری (BI) در اختیار ندارند.
استقلال از مدل و اقتصاد توکن
اگرچه این پلتفرم در حال حاضر از مدلهای آزمایشگاههای پیشرو استفاده میکند، اما بهگونهای ساخته شده که مستقل از مدل (Model-agnostic) باشد. نقیبزاده استدلال میکند که مشتریان ترجیح میدهند از ارائهدهندهای استفاده کنند که انگیزهای برای به حداکثر رساندن مصرف توکن (Token) یا هزینههای محاسباتی نداشته باشد. او تأکید میکند که QueryStory بر اساس «مدل مصرفیِ محاسبات، ذخیرهسازی یا توکنها» بنا نشده است.
با تمرکز بر ارزش افزوده برای کسبوکار بهجای حجم هوش فروخته شده، QueryStory خود را به عنوان یک لایه سبک از اعتماد روی مدلهای زبانی بزرگ (LLM) موجود تعریف میکند. تیلر سیپرلی (Tayler Sipperly)، شریک Brightmind Partners، هشدار میدهد که هوش مصنوعی هنگام ساخت سیستمهای بادوام برای کسبوکارهای مقیاسبزرگ، «شکنندهتر از آن است که مردم تصور کنند». نقیبزاده معتقد است یک ابزار هدفمند میتواند با حفظ بافتار (Context)، بسیار کارآمدتر از یک عامل عمومی باشد.
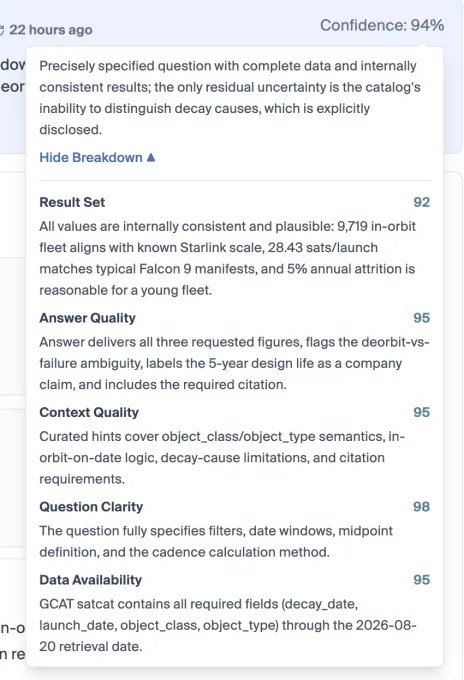
این تغییر رویکرد نشاندهنده یک روند گستردهتر است: ارزش هوش مصنوعی سازمانی از خودِ مدلها به سمت «لایه تأیید» (Verification Layer) در حال حرکت است. برای کاربر نهایی، این یعنی تفاوت بین یک «پاسخ پیشنهادی» و یک «فکت تجاری قابل اجرا». هدف این است که به یک مدیر مالی شفافیت کامل در مورد هزینهها داده شود، بدون اینکه نیاز باشد یک تیم علوم داده هر پرامپت را بازرسی کند.
باید منتظر ماند و دید ابزارهای دیگرِ BI چگونه «نمرات اطمینان» مشابه را ادغام میکنند، زیرا سازمانها از مراحل آزمایشی AI به سمت سیستمهای تولیدی بادوام و در مقیاس بزرگ حرکت میکنند.
گام بعدی شما
- اگر از ابزارهای BI مبتنی بر AI استفاده میکنید، از مدل بخواهید کد SQL تولید شده را نمایش دهد تا صحت فیلترها را بررسی کنید.
- در گزارشهای سازمانی، بخشی برای «تأیید انسانی» (Human-in-the-loop) ایجاد کنید تا ریسک توهمات مدل کاهش یابد.
- بررسی کنید آیا ابزارهای فعلی شما «شاخص اطمینان» ارائه میدهند یا صرفاً پاسخی با لحن مطمئن تولید میکنند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو