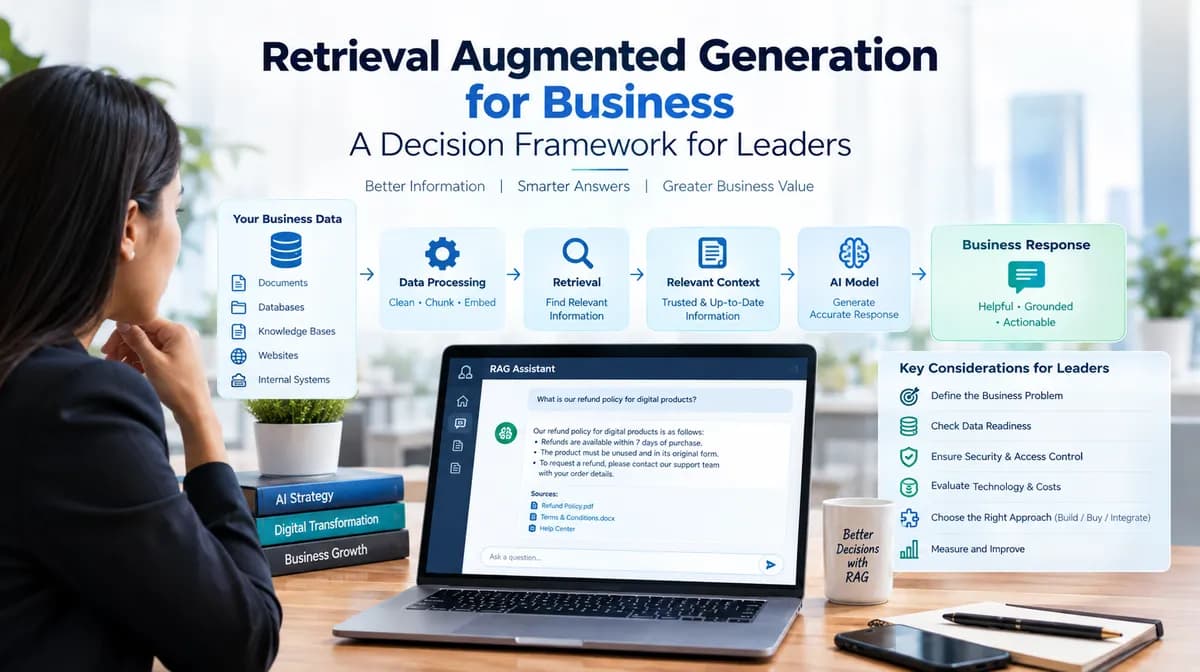
اگر بودجه هوش مصنوعی سازمان شما صرف ساخت چتباتهایی شده که هنوز پاسخهای متناقض میدهند، احتمالاً در تلهٔ «امکان فنی» افتادهاید. در ۴ اکتبر ۲۰۲۶، چارچوبی برای تصمیمگیری منتشر شد تا مدیران را از پرسش «آیا میتوانیم آن را بسازیم؟» به پرسش حیاتیتر «آیا باید آن را بسازیم؟» سوق دهد.
بسیاری از شرکتها اکنون با مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — دستوپنجه نرم میکنند که هنگام مواجهه با دادههای خصوصی یا متغیر سازمان، دچار توهم (Hallucination) — یعنی وقتی مدل با اطمینان چیزی میگوید که اصلاً وجود ندارد، شبیه دوستی که خاطرهای را اشتباه تعریف میکند — میشوند. در حالی که ما پیشتر در تحلیلهای خود به نحوه انتخاب بین مهارتهای عامل (Agent Skills) و سرورهای MCP برای اتصال دادهها پرداختیم، اکنون باید بدانیم که RAG به عنوان لایهی بنیادی برای متصل کردن هوش مصنوعی به منابع تاییدشدهی کسبوکار عمل میکند.
تصور کنید شرکتی با هزاران دفترچه راهنمای فنی است. بهجای اینکه کارکنان ساعتها در فایلهای PDF جستوجو کنند، سیستم RAG دقیقترین پاراگراف مورد نیاز را پیدا کرده و به عنوان زمینه به مدل میدهد. این سازوکار، هوش مصنوعی را از یک نویسندهی عمومی به یک متخصص داخلی تبدیل میکند.
تولید بازیابیافزا چیست؟
به نقل از مستندات این چارچوب، RAG در واقع ترکیبی از بازیابی اطلاعات و هوش مصنوعی زاینده است. هوش مصنوعی سنتی فقط به دانشی تکیه میکند که هنگام آموزش در مدل ذخیره شده است. اما RAG ابتدا اطلاعات مرتبط را از منابع تاییدشده استخراج کرده و سپس آن را در اختیار مدل قرار میدهد تا پاسخ تولید کند.
تفاوت این دو حیاتی است: در حالت سنتی به مدل گفته میشود «با دانش خودت جواب بده»، اما در RAG دستور این است: «ابتدا اطلاعات مرتبط را از منابع تاییدشده پیدا کن و سپس بر اساس آنها پاسخ بده».
گردش کار و کاربردهای RAG
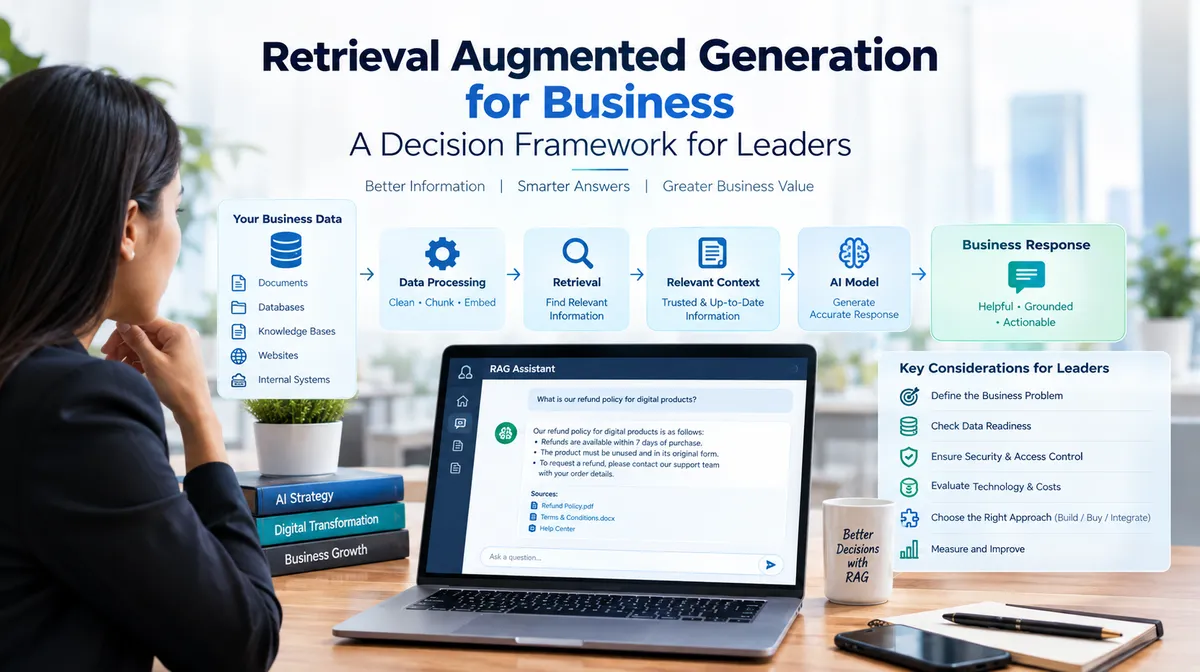
طبق گزارش dev.to، یک خط لولهی استاندارد RAG مسیر دقیقی را طی میکند: دادههای کسبوکار $\rightarrow$ پردازش داده $\rightarrow$ جستوجو/بازیابی $\rightarrow$ زمینه مرتبط $\rightarrow$ مدل هوش مصنوعی $\rightarrow$ پاسخ تجاری.
این معماری اجازه میدهد مدل با اطلاعات خصوصی، تخصصی یا بهروز کار کند. منابع تاییدشده میتوانند شامل موارد زیر باشند:
- اسناد داخلی و پایگاههای دانش.
- اطلاعات محصول و مستندات فنی.
- سیاستها، دستورالعملها و محتوای پشتیبانی مشتریان.
- پایگاههای داده، وبسایتها و سایر منابع سازمانی.
این ساختار برای چندین سناریوی با ارزش بالا ضروری است:
- دانش داخلی: پذیرش کارکنان جدید (Onboarding)، تحقیقات مربوط به انطباق (Compliance) و مدیریت دانش در سطح سازمان. در همین راستا، ابزارهایی مانند Foundry IQ مایکروسافت لایهای مدیریتشده برای دانش ایجنتها فراهم میکنند تا دسترسی به دادههای سازمانی بهینهتر شود.
- پشتیبانی مشتری: عیبیابی محصولات و دسترسی به مستندات فنی.
- توانمندسازی فروش: دسترسی سریع به مشخصات دقیق محصول و سیاستهای فروش.
- بهرهوری عملیاتی: عیبیابیهای فنی و جستوجوی پیشرفته در اسناد.
آمادگی دادهها و استراتژیهای بازیابی
موفقیت این سیستم کاملاً به کیفیت اطلاعات بازیابیشده بستگی دارد. این چارچوب هشدار میدهد که دادههای بیکیفیت — مثل محتوای تکراری، قدیمی یا فاقد متاداده — بهطور اجتنابناپذیری به پاسخهای غیرقابلاعتماد منجر میشوند. بنابراین، آمادهسازی دادهها یک پیشنیاز اصلی پروژه است، نه یک گام فنی کوچک یا فرعی.
ارزیابی کیفیت دادهها
کسبوکارها پیش از اجرا باید چندین عامل خاص مربوط به دادهها را بررسی کنند:
- ساختار و کیفیت: بررسی ساختار اسناد و شناسایی اطلاعات مفقود یا ناقص.
- صحت: شناسایی و حذف اطلاعات تکراری و محتوای منقضیشده.
- حاکمیت: مدیریت متادادهها، تعیین مالکیت دادهها و تعریف مجوزهای دسترسی.
انتخاب استراتژی بازیابی
بازیابی تعیین میکند چه اطلاعاتی به مدل برسد. برای بهینهسازی، باید استراتژی جستوجوی درستی انتخاب شود. بهجای تکیه بر جستوجوی سادهی کلمات کلیدی، این چارچوب روشهای زیر را پیشنهاد میکند:
- جستوجوی کلمات کلیدی: تطبیق عبارات و کلمات خاص.
- جستوجوی معنایی و برداری: درک قصد و معنای پشت پرسش با استفاده از بردار معنایی (Embedding) — مثل کارت معرفی عددی برای هر واژه که میگوید این کلمه «همسایهی» چه کلمات دیگری است.
- جستوجوی ترکیبی (Hybrid): ادغام جستوجوی معنایی و کلیدواژهای برای ارائه دقیقترین نتایج برای پرسوجوهای سازمانی. این تحول در نحوه بازیابی اطلاعات، در واقع بخشی از روند گستردهتری است که در آن پاسخهای محاورهای هوش مصنوعی در حال جایگزینی لینکهای سنتی موتورهای جستوجو هستند.
- فیلترهای پیشرفته: استفاده از فیلترینگ متادادهها و بازرتبهبندی (Reranking) برای پالایش نهایی نتایج.
انتخاب رویکرد درست به معماری سیستم، نوع پرسوجوهای کاربران و نوع اطلاعات ذخیرهشده بستگی دارد.
امنیت و کنترل دسترسی
امنیت نباید یک اقدام ثانویه باشد. یکی از بزرگترین ریسکها در RAG سازمانی، «نشت مجوزها» (Permission Leakage) است؛ جایی که کاربر به اطلاعات حساسی دسترسی پیدا میکند صرفاً چون سیستم توانسته آن را بازیابی کند. این چارچوب تاکید میکند که مجوزهای دسترسی باید در مرحلهی بازیابی اعمال شوند، نه اینکه به تشخیص مدل سپرده شوند.
لایههای امنیتی ضروری عبارتند از:
- مدیریت دسترسی: کنترل دسترسی مبتنی بر نقش (RBAC) و بازیابی آگاه از مجوزها.
- حفاظت از داده: احراز هویت، رمزنگاری دادهها و دسترسی امن به APIها.
- نظارت: ثبت لاگهای بازرسی (Audit Logging) و جداسازی محیطهای مشتریان (Tenant Isolation) در صورت نیاز.
سنجش کیفیت و هزینه
برداشتهای ذهنی از «مفید بودن» یک چتبات برای تایید تجاری کافی نیست. RAG بهطور خودکار سیستم را دقیق نمیکند؛ نتیجه نهایی تحت تاثیر مدل، پرامپتها و فرآیند ارزیابی است.
این چارچوب معیارهای مشخصی را برای سنجش عملکرد RAG پیشنهاد میدهد:
۱. ارتباط بازیابی (Retrieval Relevance): آیا سیستم سند درست را پیدا کرد؟
۲. مبنیسازی (Groundedness): آیا پاسخ صرفاً بر اساس دادههای بازیابیشده است یا مدل از دانش خارجی استفاده کرده است؟
۳. کیفیت ارجاع (Citation Quality): آیا منابع بهدرستی و با دقت ذکر شدهاند؟
۴. نرخ حل مسئله (Resolution Rate): آیا تعامل منجر به حل واقعی مشکل کاربر شد؟
۵. معیارهای عملیاتی: زمان پاسخدهی، دقت پاسخ و هزینه به ازای هر تعامل.
کسبوکارها همچنین باید «موارد خاص» (Edge Cases) را تست کنند؛ مانند سوالات مبهم، اسناد متناقض یا پرسوجوهایی که خارج از محدوده دانش سیستم هستند. یک سیستم قابلاعتماد باید بداند چه زمانی اطلاعات کافی برای ارائه یک پاسخ قابلاعتماد را در اختیار ندارد.
هزینه کل مالکیت (TCO)
تحلیل هزینه باید فراتر از قیمت توکنهای مدل باشد. مدیران باید کل چرخه عمر سیستم را محاسبه کنند:
- راهاندازی اولیه: وارد کردن دادهها (Ingestion)، تولید بردارها و ذخیرهسازی در پایگاهداده برداری (Vector Database).
- زیرساخت: هزینه استفاده از مدل، میزبانی و پیادهسازی لایههای امنیتی.
- عملیات جاری: نظارت، نگهداری، ارزیابی مستمر و نظارت انسانی.
هزینهها معمولاً با افزایش تعداد اسناد، کاربران و ادغامها رشد میکنند. مدیران باید ارزش تجاری مورد انتظار را در برابر این هزینه کل مالکیت بسنجند.
ساختن، خریدن یا ادغام
سازمانها سه مسیر اصلی برای استقرار پیش رو دارند:
- ساخت (Build): ایجاد پلتفرم سفارشی RAG برای نیازهای بسیار خاص و کنترل حداکثری.
- خرید (Buy): استفاده از محصولات آماده هوش مصنوعی سازمانی یا مدیریت دانش برای رسیدن سریعترین زمان به ارزش.
- ادغام (Integrate): متصل کردن سیستمهای تجاری موجود به قابلیتهای AI از طریق APIها و اجزای تخصصی.
این انتخاب به بودجه، تخصص فنی داخلی، حساسیت دادهها و نیازهای مقیاسپذیری بستگی دارد.
چکلیست اعتبارسنجی ۶ گانه
پیش از تایید پروژه، این ۶ ستون را ارزیابی کنید:
- ارزش تجاری: آیا مشکل قابلسنجشی حل میشود؟ (مثلاً کاهش زمان صرف شده برای جستوجوی مستندات).
- آمادگی دادهها: آیا اطلاعات در دسترس، دقیق و قابل دسترسی هستند؟
- امنیت: آیا دادههای حساس با کنترلهای دسترسی مناسب قابل حفاظت هستند؟
- امکان فنی: آیا سازمان توانایی ادغام منابع داده و اجزای AI مورد نیاز را دارد؟
- اقتصاد: آیا سود حاصله، هزینه کل مالکیت را توجیه میکند؟
- حاکمیت: آیا برنامهای برای نظارت، ارزیابی، بهروزرسانی و بهبود سیستم در طول زمان وجود دارد؟
اشتباهات رایج
این رویکرد ساختاریافته از خطاهای رایج زیر جلوگیری میکند:
- شروع پروژه بدون مورد کاربرد (Use Case) تعریف شده یا تلقی کردن RAG به عنوان درمانی برای کیفیت پایین دادهها.
- نادیده گرفتن مجوزهای دسترسی یا استفاده از اسناد قدیمی و منقضی.
- سنجش صرفاً کیفیت پاسخ چتبات در حالی که کیفیت بازیابی نادیده گرفته شده است.
- پیچیده کردن بیش از حد نسخه اول (Overengineering) یا استقرار بدون یک فرآیند ارزیابی سختگیرانه.
بهجای استقرار فوری در سطح کل سازمان، اجرای یک پایلوت متمرکز روی یک گردشکار (Workflow) واحد توصیه میشود.
پرسشهای متداول
آیا RAG بهتر از Fine-tuning است؟ لزوماً خیر. RAG برای اطلاعات متغیر یا خصوصی بهترین است. Fine-tuning برای تطبیق رفتار مدل، استایل یا بهبود عملکرد در وظایف تخصصی مناسبتر است.
آیا RAG توهمات هوش مصنوعی را حذف میکند؟ خیر. RAG با ارائه اطلاعات منبع، پاسخهای بدون پشتوانه را کاهش میدهد، اما دقت همچنان به کیفیت بازیابی و کیفیت منابع وابسته است.
چه کسانی بیشترین بهره را میبرند؟ کسبوکارهایی که مجموعههای بزرگی از اطلاعات داخلی، فنی یا عملیاتی دارند و کارکنان آنها بهطور مکرر نیاز به جستوجوی پاسخهای خاص دارند.
برای یک مدیر کسبوکار مدرن، این تغییر به معنای برخورد با هوش مصنوعی نه به عنوان یک ابزار جادویی، بلکه به عنوان یک خط لوله داده (Data Pipeline) است. هدف دیگر داشتن یک چتبات «باهوش» نیست، بلکه کاهش زمانی است که کارکنان برای یافتن اطلاعات صرف میکنند. این تغییر در نحوه دسترسی به اطلاعات، میتواند باعث شود وبسایتهای محلی و سنتی در برابر عاملهای هوش مصنوعی نامرئی شوند اگر نتوانند دادههای خود را برای این سیستمهای بازیابی بهینه کنند.
گام بعدی شما
- اگر در حال استقرار RAG هستید، ابتدا یک ممیزی از مجوزهای دسترسی دادههایتان انجام دهید تا مطمئن شوید مدل بهطور تصادفی پروتکلهای امنیتی داخلی را دور نمیزند.
- بهجای استقرار سراسری، یک پایلوت متمرکز روی یک گردشکار (Workflow) خاص اجرا کنید و نرخ حل مسئله را بسنجید.
- کیفیت دادههای ورودی را با حذف تکراریها و بهروزرسانی متادادهها ارتقا دهید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو