تصور کنید هر بار که یک اشتباه ساده را در کدتان اصلاح میکنید، دستیار هوش مصنوعی شما در بازبینی بعدی دوباره همان ایراد بیربط را میگیرد. این تجربه آزاردهنده برای توسعهدهندگان، نتیجهای از «حافظه ماهی» (Goldfish Memory) در مدلهای فعلی است؛ وضعیتی که در آن مدلها در جلسات مختلف، همان پیشنهادات نادرست را تکرار میکنند. برای یک برنامهنویس، این به معنای رد کردن دستی و مکرر کامنتهای بیربط درباره استایل کد یا داکاسترینگهاست.
Review Desk — یک عامل (Agent) تخصصی برای بازبینی کد — با پیادهسازی حافظه Hindsight سعی دارد این مشکل را حل کند. این سیستم هر تصمیم انسانی (چه پذیرش یک کامنت و چه رد آن) را در یک بانک حافظه دائمی با استفاده از قابلیت retain در Hindsight ذخیره میکند تا مدل یاد بگیرد چه چیزهایی برای تیم شما «اشتباه» یا «بیارزش» است. همانطور که در تحلیلهای قبلی ما دربارهی مدیریت وضعیت در عاملهای هوش مصنوعی اشاره کردیم، توانایی حفظ یک «شخصیت» یا Persona بر اساس ترجیحات کاربر، مرز بین یک ابزار ساده و یک همکار واقعی است. در همین راستا، مقایسهی حافظه معنایی در برابر اجرای بدون وضعیت نشان میدهد که چگونه این رویکرد میتواند دقت بازبینی کد را ارتقا دهد.
زمینه و بستر آزمایش
برای تأیید اثر این حافظه، توسعهدهنده ۲۱ درخواست ادغام (Pull Request) پذیرفتهشده از پروژه pallets/flask را به ترتیب ادغام بازپخش کرد. این آزمایش دو بار تکرار شد: یک بار با حافظه غیرفعال و یک بار با حافظه فعال، در حالی که در هر دو حالت از یک بانک حافظه کاملاً تازه استفاده شد.
برای اینکه شمارش نتایج بر اساس یک قانون ثابت باشد و خطای انسانی حذف شود، یک اسکریپت در نقش بازبین انسانی قرار گرفت. این اسکریپت که نقش «شخصیت تیمی» را ایفا میکرد، تنها کامنتهایی را میپذیرفت که در دستههای امنیت، اعتبارسنجی، مدیریت خطا یا باگها قرار داشتند و هر مورد دیگری را رد میکرد. در این چارچوب، «رد تکراری» به هر کامنتی تعریف شد که در دستهای قرار داشت که اسکریپت پیشتر در همان اجرای جاری، آن دسته را رد کرده بود.
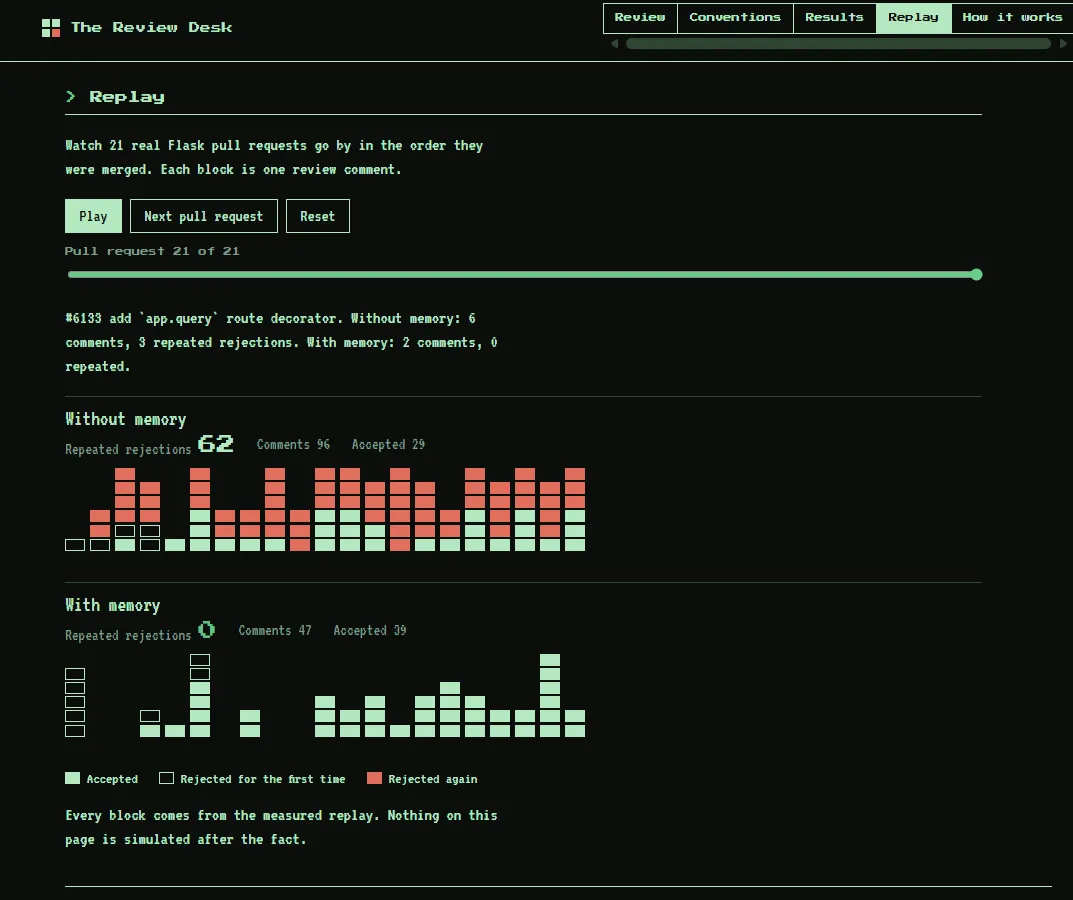
بر اساس بررسی دادهها، تفاوت رفتار عامل در دو حالت حافظه فعال و غیرفعال تکاندهنده است:
- بدون حافظه: ۹۶ کامنت تولید شد که ۶۲ مورد آنها «رد تکراری» بودند.
- با حافظه: تنها ۴۷ کامنت تولید شد و تعداد رد تکراری به صفر رسید.
- نرخ پذیرش: از ۳۰٪ به ۸۳٪ جهش کرد.
- تعداد پذیرفتهشدهها: از ۲۹ مورد به ۳۹ مورد افزایش یافت.
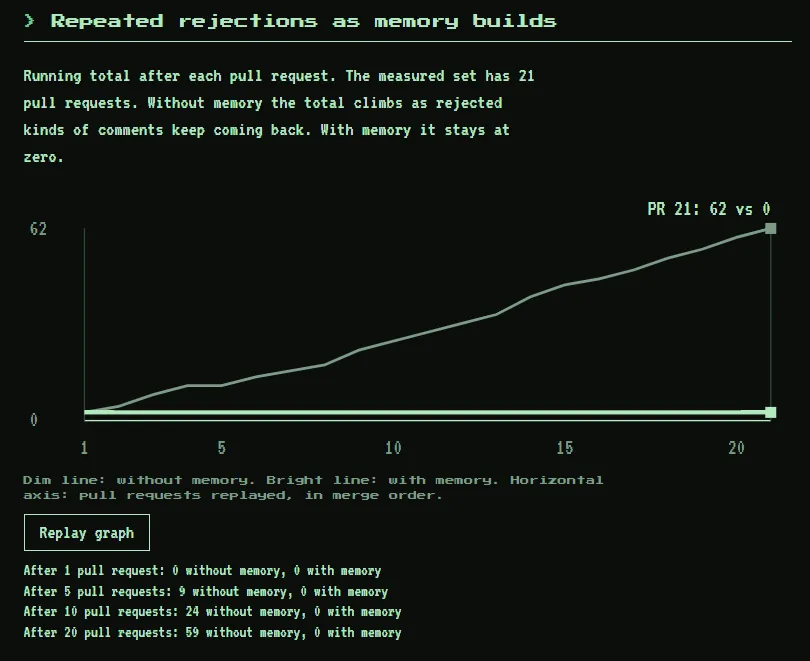
شکاف بین این دو حالت خیلی زود ظاهر شد و بهطور مداوم رشد کرد؛ پس از ۵ درخواست ادغام، امتیاز رد تکراری ۹ در برابر ۰ بود؛ پس از ۱۰ درخواست، این رقم به ۲۴ در برابر ۰ رسید و در نهایت پس از ۲۰ درخواست، به ۵۹ در برابر ۰ رسید.
جزئیات اعتبارسنجی و معیارها
برای اطمینان از اینکه این نتیجه اتفاقی یا یک مورد خاص نبوده، آزمایش دوم روی مجموعه متفاوتی شامل ۱۰ درخواست ادغام انجام شد. در این بررسی دوم نیز، با فعال بودن حافظه، تعداد رد تکراری دوباره به صفر رسید. در حالت بدون حافظه، ۵۱ کامنت تولید شد (که ۲۶ مورد رد تکراری بودند)، در حالی که در حالت با حافظه، تنها ۲۱ کامنت تولید شد (با صفر رد تکراری).
با این حال، توسعهدهنده هشدار میدهد که نرخ پذیرش ۸۳٪ میتواند یک «تله» یا گمراهکننده باشد. در اجرای ۱۰ درخواستی، تعداد کامنتهای پذیرفتهشده در واقع با فعال شدن حافظه کاهش یافت (از ۱۸ به ۱۴ مورد)، در حالی که در اجرای ۲۱ درخواستی، این تعداد افزایش یافته بود (از ۲۹ به ۳۹ مورد). از آنجایی که تعداد پذیرفتهشدهها در دو آزمایش در جهتهای مخالف حرکت کردند، توسعهدهنده ادعا نمیکند که حافظه لزوماً تعداد کامنتهای مفید را افزایش یا کاهش میدهد. دلیل اصلی بهبود نرخ پذیرش این است که حافظه، تعداد کل کامنتهای تولیدشده را تقریباً نصف کرده و در نتیجه مخرج کسر را کوچک کرده است.
پیادهسازی فنی
این آزمایش از اسکریپت replay_real.py استفاده کرد که صرفاً بر قابلیت Recall در Hindsight متکی است. اما اپلیکیشن واقعی پیچیدگی بیشتری دارد؛ این برنامه یک لاگ از تصمیمات را در یک فایل متنی ساده (data/decisions.json) ذخیره میکند که هیچگونه رمزنگاری در حالت استراحت (at rest) ندارد. سیستم از این لاگ، قوانین دستهبندیشدهای میسازد و آنها را در ابتدای پرامپت، پیش از یادداشتهای بازیابیشده (recalled notes)، قرار میدهد.
این افزودنی ضروری بود زیرا Hindsight گاهی اوقات ردها را به صورت واقعیتهای بسیار محدود ذخیره میکند؛ برای مثال: «رد کردن یک داکاسترینگ در تابع load». قوانین دستهبندی به عامل کمک میکنند تا این ردها را تعمیم دهد و بفهمد که بهطور کلی داکاسترینگها برای این تیم اولویت ندارند. برای شفافتر شدن این فرآیند، رابط کاربری جدید Hindsight تلاش میکند تا تصمیمات جعبهسیاه ایجنتها را به شواهدی قابلحسابرسی تبدیل کند. در نسخه زنده، به کاربران توصیه شده است که حدود ۱۰ ثانیه منتظر بمانند تا Hindsight فرآیند retain را پردازش کند و سپس بازبینی بعدی را شروع کنند.
محدودیتها و کارهای آینده
این نتایج با چندین محدودیت همراه است:
- اندازه نمونه: برای هر بازو تنها یک بار اجرا انجام شده است؛ با توجه به اینکه خروجی مدلها متغیر است، هیچ محدوده آماری ارائه نشده است.
- ثبات بازبین: بازبین یک اسکریپت بود. انسانهای واقعی در تصمیمگیریهای خود متناقض هستند و این موضوع هنوز آزمایش نشده است.
- تأیید محتوا: کامنتها خروجی مدل هستند و تأیید نشدهاند. برخی کامنتهای امنیتی درباره Host header بیش از حد جسورانه (stretch) بودند و هیچکدام از آنها به عنوان باگ واقعی Flask تأیید نشدند.
- محدودیتهای رابط کاربری: کامنتها در UI ظاهر میشوند اما به صورت خودکار به گیتهاب ارسال نمیشوند.
برای تقویت نتایج، توسعهدهنده پیشنهاد میکند چندین بار اجرا برای هر حالت انجام شود، از بازبینهای انسانی واقعی استفاده گردد و تعداد هر دسته از بازخوردها ردیابی شود تا مشخص شود کدام نوع بازخوردها سریعتر توسط مدل حذف میشوند.
این تجربه، معیار سنجش کاربردی بودن یک عامل را تغییر میدهد: بهجای اینکه بپرسیم «مدل چند مورد درست پیدا میکند»، باید بپرسیم «مدل چقدر سریع یاد میگیرد کارهای غلط را متوقف کند». برای یک توسعهدهنده عملی، این یعنی ارزش یک عامل هوش مصنوعی بهطور فزایندهای به مدیریت وضعیت (State Management) آن و تواناییاش در حفظ یک «شخصیت» متناسب با ترجیحات یک تیم خاص گره خورده است. در مواجهه با چالشهای حافظه، برخی توسعهدهندگان از ترفند «اجبار به بازگشت هش» استفاده میکنند تا از اعتماد مدل به دادههای قدیمی و منقضیشده جلوگیری کنند.
گام بعدی شما
- اگر از ابزارهای بازبینی کد استفاده میکنید، بررسی کنید آیا راهی برای ثبت «ترجیحات تیمی» (Team Preferences) در حافظه مدل وجود دارد یا خیر.
- کد این پروژه را در github.com/abhiram0411/review-desk بررسی کنید تا با نحوه پیادهسازی Recall در Hindsight آشنا شوید.
- دمو آنلاین این ابزار را در Render (review-desk-z659.onrender.com) تست کنید، اما به دلیل استفاده از هاست رایگان، صبور باشید زیرا ممکن است بارگذاری آن یک یا دو دقیقه زمان ببرد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو