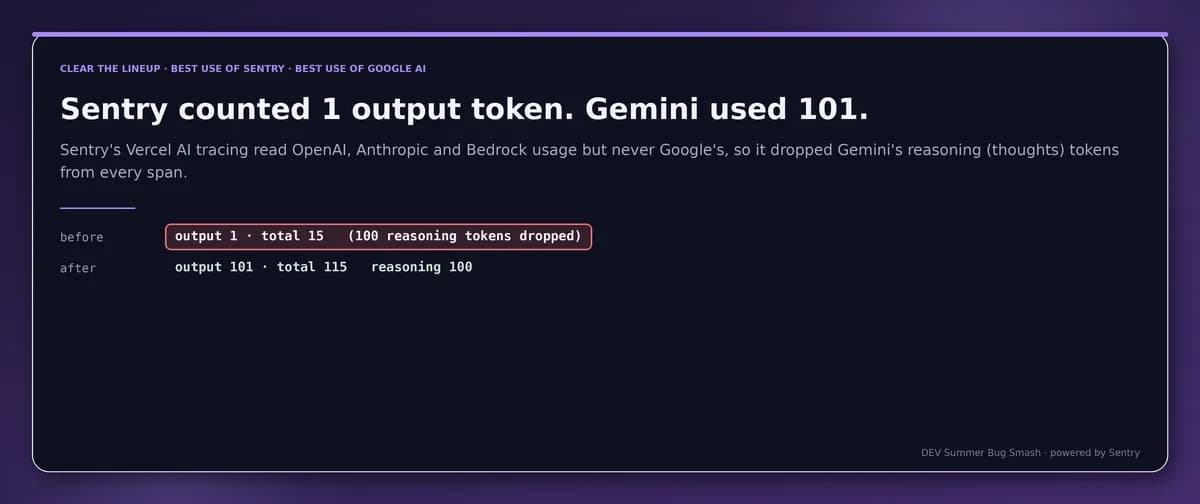
تصور کنید داشبورد نظارتی شما هزینههای هوش مصنوعی را نزدیک به صفر نشان دهد، اما در پایان ماه، صورتحساب ابری شما ۸ برابر بیشتر از پیشبینی باشد. این کابوس مالی برای بسیاری از توسعهدهندگانی رخ داده که از SDK جاوااسکریپت Sentry برای ردیابی مدلهای گوگل استفاده میکردند. این اختلاف فاحش به دلیل یک خطای حسابداری بحرانی در SDK سنتری رخ داده است که باعث شد توسعهدهندگان هزینههای Google Gemini را بسیار کمتر از مقدار واقعی تخمین بزنند.
این مشکل به دلیل حذف خاموش توکنهای استدلالی — همان «تفکرات» داخلی مدل پیش از ارائه پاسخ نهایی — از ردپاهای ابزار Vercel AI رخ داده است. همانطور که در تحلیل قبلی ما دربارهی مدل Gemini 3.7 Flash اشاره کردیم، مدیریت هزینههای «تفکر سیستم ۲» در مدلهای استدلالی (Reasoning Models) — شبیه به شطرنجبازی که قبل از هر حرکت چند گام جلوتر را میبیند — برای بقای اقتصادی پروژهها حیاتی است. این مدلهای استدلالی با بهرهگیری از رویکردهای نوین، توانستهاند در بنچمارکهای پیچیدهای مانند MATH به صحت ۹۶ درصدی برسند و استانداردهای جدیدی برای حل مسائل منطقی تعریف کنند. در نبود شمارش دقیق توکنها، داشبورد مانیتورینگ یک شرکت ممکن است هزینهای ناچیز را نشان دهد، در حالی که صورتحساب واقعی ابری به شدت افزایش مییابد.
زمینه: شکاف در ابزار اندازهگیری
SDK جاوااسکریپت سنتری بهطور خودکار ابزار Vercel AI را مانیتور (Auto-instrument) میکند. این بدان معناست که هر فراخوانی تابع generateText یا streamText بهطور خودکار بهعنوان یک بازه (span) از نوع gen_ai ثبت میشود که میزان مصرف توکن به آن پیوست است.
اما مشکل اینجاست که مدلهای Gemini توکنهای استدلالی را جدا از پاسخ مرئی گزارش میکنند. در حالی که outputTokens در AI SDK فقط پاسخ نهایی (Candidate Answer) را پوشش میدهد، تعداد توکنهای استدلالی در مسیر providerMetadata.google.usageMetadata.thoughtsTokenCount قرار دارد.
طبق گزارش فنی منتشر شده در ۱۴ اوت ۲۰۲۶، این باگ در تابع getProviderMetadataAttributes() نهفته بود. در حالی که سنتری متادیتای مربوط به OpenAI, Anthropic, Bedrock و DeepSeek را بهدرستی پردازش میکرد، بلوکهای مربوط به گوگل و Vertex را کاملاً نادیده میگرفت. این یعنی برای یک فراخوانی استدلالی، سنتری تنها پاسخ نهایی و پرامپت ورودی را ثبت میکرد و بخش اعظم محاسبات مدل را نادیده میگرفت.
تحلیل فنی خطا
در یک مورد تست واقعی، درخواستی به مدل gemini-3.6-flash نتایج متادیتای مصرفی زیر را برگرداند:
- توکنهای ورودی (Prompt Tokens): ۱۴
- توکنهای پاسخ (Candidate Tokens): ۱
- توکنهای استدلالی (Reasoning/Thoughts Tokens): ۱۰۰
- مجموع توکنها (Total Tokens): ۱۱۵
پیش از اعمال اصلاحیه، سنتری تنها ۱ توکن خروجی و ۱۵ توکن کل را ثبت میکرد. در واقع ۱۰۰ توکن استدلالی که معمولاً بخش اعظم هزینه در گردشهای کاری سنگین و استدلالی را تشکیل میدهند، بهطور کامل پنهان میشدند. این موضوع نشان میدهد که حتی با وجود ابزارهای کاهش توکن که در عمل تنها ۶ تا ۳۲ درصد هزینه را کم میکنند، خطاهای مانیتورینگ میتواند منجر به شوکهای مالی بسیار بزرگتری شود.

جزئیات پیادهسازی اصلاحیه
برای رفع این مشکل، یک شاخه منطقی (Branch) اختصاصی برای متادیتای گوگل و Vertex در فایل packages/server-utils/src/ai/vercel-ai/index.ts اضافه شد. جزئیات این تغییرات به شرح زیر است:
- تغییر منطق: اکنون SDK بهطور صریح مقادیر موجود در
providerMetadata.{google|vertex}.usageMetadataرا میخواند. - محرک شرطی: این شاخه تنها زمانی فعال میشود که
thoughtsTokenCount > 0باشد؛ این کار تضمین میکند که پاسخهای Gemini که فاقد استدلال هستند، بدون تغییر باقی بمانند. - نحوه محاسبه: اگر توکنهای استدلالی وجود داشته باشند، سنتری مقدار خروجی را برابر با مجموع
candidatesTokenCount + thoughtsTokenCountقرار داده و مقدار کل را ازtotalTokenCountواقعی استخراج میکند. - ردیابی دقیق: اکنون تفکیک توکنهای استدلالی بهطور مشخص تحت عنوان
gen_ai.usage.reasoning.output_tokensثبت میشود.
توسعهدهنده برای جلوگیری از شمارش مضاعف (Double-counting) در نسخههای آینده SDK، عمداً مقدار خروجی را از اعداد خام استخراج کرد، به جای اینکه آن را به مقدار موجود در SDK اضافه کند. این استراتژی تضمین میکند که حتی اگر Vercel AI SDK نحوه گزارش توکنهای خروجی را در آینده تغییر دهد، حسابداری سنتری همچنان درست باقی بماند. از آنجایی که هم مسیر OpenTelemetry span و هم مسیر tracing-channel از این تابع کمکی استفاده میکنند، هر دو اکنون دادههای اصلاحشده را ارسال میکنند.
این اصلاحیه، فرض بنیادی تیمهایی که از سنتری برای ردیابی رفتار هوش مصنوعی استفاده میکنند را تغییر میدهد. تلهمتری از یک معیار «خروجی مرئی» به معیار «کل محاسبات» (Total Compute) تغییر مییابد. برای کیف پول توسعهدهنده، این یعنی تفاوت بین ردی که رایگان به نظر میرسد و ردی که هزینه واقعی استدلال عمیق را منعکس میکند.
اعتبارسنجی و تست
تأیید این اصلاحیه شامل مجموعهای از ۳۷۷ تست در بسته @sentry/server-utils بود. نویسنده یک فایل تست جدید با چهار مورد مختلف اضافه کرد: سه پاسخ استدلالی (که در نسخه بدون اصلاحیه شکست میخوردند) و یک پاسخ غیر استدلالی (که با موفقیت پاس شد).
فراتر از مجموعه تستها، این اصلاحیه با استفاده از موارد زیر اعتبارسنجی شد:
- ابزارها: استفاده از
oxlint --type-awareبرای تحلیل استاتیک،oxfmt --checkبرای فرمتبندی وtscبرای بررسی تایپهای سورس. - بررسی تطبیق: نویسنده تأیید کرد که این منطق با فایل
convert-google-usage.tsدر سورس AI SDK مطابقت دارد، جایی که خروجی را برابر با مجموع پاسخها و تفکرات میداند. - ترافیک زنده: اجرای واقعی یک مدل استدلالی Gemini تأیید کرد که ویژگیهای span از
output_tokens: 1بهoutput_tokens: 101تغییر یافته است.
توسعهدهندگانی که از Vercel AI SDK با مدلهای استدلالی Gemini استفاده میکنند، باید فوراً SDK جاوااسکریپت Sentry خود را بهروزرسانی کنند تا از دقت ردیابی هزینههای خود مطمئن شوند. همچنین توصیه میشود بهروزرسانیهای آتی بلوکهای متادیتای سایر ارائهدهندگان را دنبال کنید تا ببینید آیا شکافهای مشابهی در توکنهای «پنهان» برای سایر مدلهای استدلالی وجود دارد یا خیر.
گام بعدی شما
- اگر از Vercel AI SDK و مدلهای استدلالی Gemini استفاده میکنید، فوراً SDK جاوااسکریپت Sentry را بهروزرسانی کنید.
- صورتحسابهای ابری ماه گذشته خود را با دادههای داشبورد Sentry تطبیق دهید تا میزان خطای تخمین را بسنجید.
- بررسی کنید آیا برای سایر مدلهای استدلالی (مانند o1) نیز شکافهای مشابهی در گزارش توکنها وجود دارد یا خیر.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو