کلاستر ۲۴ هستهای آپاچی اسپارک شما میتواند در عمل تنها ۱۴ هسته را به کار بگیرد — و ۱۰ هسته دیگر بیصدا بیکار بمانند. دلیلش یک پارامتر پیکربندی است که تعداد هستههای هر اجراکننده را تعیین میکند، نه ظرفیت فیزیکی سرورها.
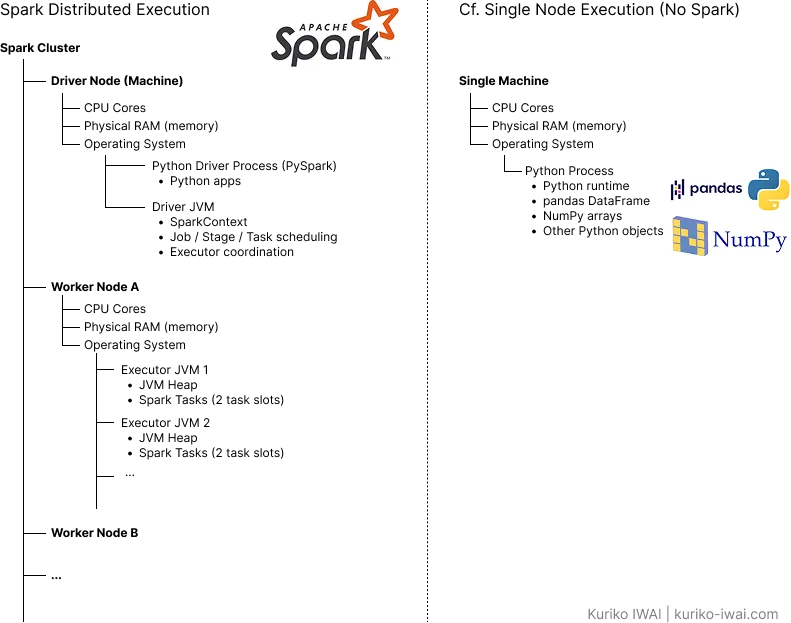
آپاچی اسپارک بخش عظیمی از خطلولههای دادهی تولید را میچرخاند، اما بسیاری از مهندسان آن را یک جعبهی سیاه میپندارند. موتور کار را به بخشها (پارتیشنها) تقسیم میکند و وظایف را در میان اجراکنندهها (Executors) توزیع میکند — هر اجراکننده مثل یک کارخانهی کوچک با خط تولید (هسته) و انبار (حافظه JVM) عمل میکند. نگاشت از کد به اجرا شهودی نیست. تعداد پارتیشنهای نامناسب، اندازهی نادرستِ اجراکنندهها و رفتار شافل (Shuffle) بهصورت پنهان هزینه و تأخیر را بالا میبرند. این گزارش بر اساس مقالهی فنی منتشرشده، کل زنجیره از برنامه منطقی تا راهاندازی وظیفه را با یک سناریوی واقعیِ تجمیع فروش تجزیه میکند.
مثال از ۱۰ هزار رکورد فروش در سه SKU با مقادیر و مرجوعیهای نامعتبر استفاده میشود. هدف: حذف مقادیر غیرمثبت و جمع واحدهای معتبر برای هر SKU. پس از فیلتر، ۹۸۰۰ رکورد باقی میماند. مجموعهای مورد انتظار: ۸۰۰۰ برای SKU A، ۱۰۵۰۰ برای SKU B و ۹۲۰۰ برای SKU C. این مجموعه داده کوچک در حافظه یک ماشین جا میشود، اما مکانیزمها در مقیاس پتابایت هم برقرارند.
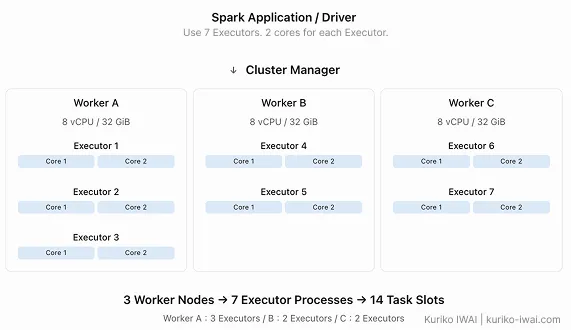
کلاستر از سه گره کارگر (Worker Node) تشکیل شده، هر کدام با ۸ vCPU و ۳۲ گیگابایت رم. مدیر کلاستر هفت اجراکننده تخصیص میدهد، هر کدام با ۲ هسته vCPU و ۳ گیگابایت هیپ JVM. این یعنی ۱۴ یاخ اسلات وظیفه در کل — دو در هر اجراکننده. اگرچه ۲۴ vCPU فیزیکی وجود دارد، فقط ۱۴ میتوانند همزمان وظیفه اجرا کنند. گره A سه اجراکننده میچرخاند (۶ هسته استفاده شده، ۷۵٪ بهرهوری)، در حالی که گرههای B و C هر کدام دو اجراکننده دارند (۴ هسته، ۵۰٪ بهرهوری). این عدم تعادل نتیجهی مستقیم تعداد اجراکنندهها و تنظیم هستهبرایهراجراکننده است.
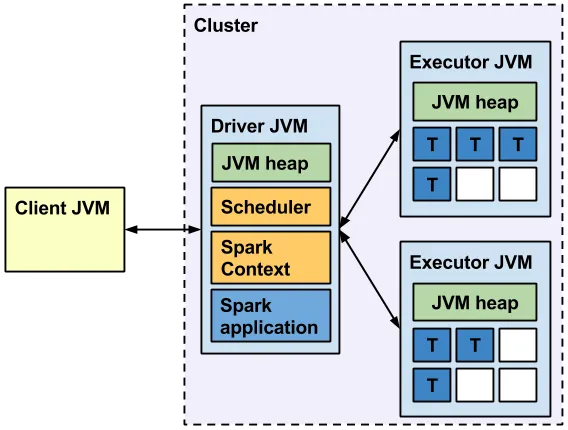
اسپارک روی ماشین مجازی جاوا (JVM) اجرا میشود. درایور JVM برنامه را هماهنگ میکند، گراف جهتدار بیدوره (DAG) میسازد و وظایف را زمانبندی میکند. هر اجراکننده JVM وظایف را اجرا کرده و حافظه را برای کش و بافرهای شافل مدیریت میکند. در پایاسپارک (PySpark)، یک فرآیند درایور پایتون از طریق Py4J با درایور JVM ارتباط برقرار میکند. فرآیندهای کارگر پایتون UDFها و کد پایتون را در هر JVM اجراکننده اجرا میکنند. این پل چندفرآینده سربار سریالسازی میافزاید، اما اکوسیستم علم داده پایتون را امکانپذیر میسازد.
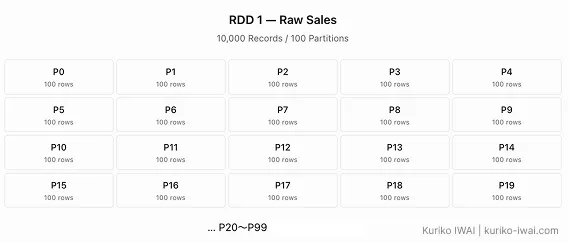
مجموعههای داده توزیعشده تابآور (RDD) انتزاع اصلی هستند. یک RDD مجموعهای غیرقابلتغییر، پارتیشنبندیشده با ردیابی نسب (Lineage) است. نسب به اسپارک اجازه میدهد پارتیشنهای از دست رفته را بازمحاسبه کند بهجای تکثیر هر نتیجه میانی. مثال ۱۰۰ پارتیشن اولیه برای ۱۰ هزار رکورد میسازد — حدود ۱۰۰ عنصر در پارتیشن. هر پارتیشن به یک وظیفه در یک مرحله (Stage) نگاشت میشود. تعداد پارتیشن مستقیماً موازیسازی را کنترل میکند؛ خیلی کم هستهها را بیکار میگذارد، خیلی زیاد سربار زمانبندی میافزاید.
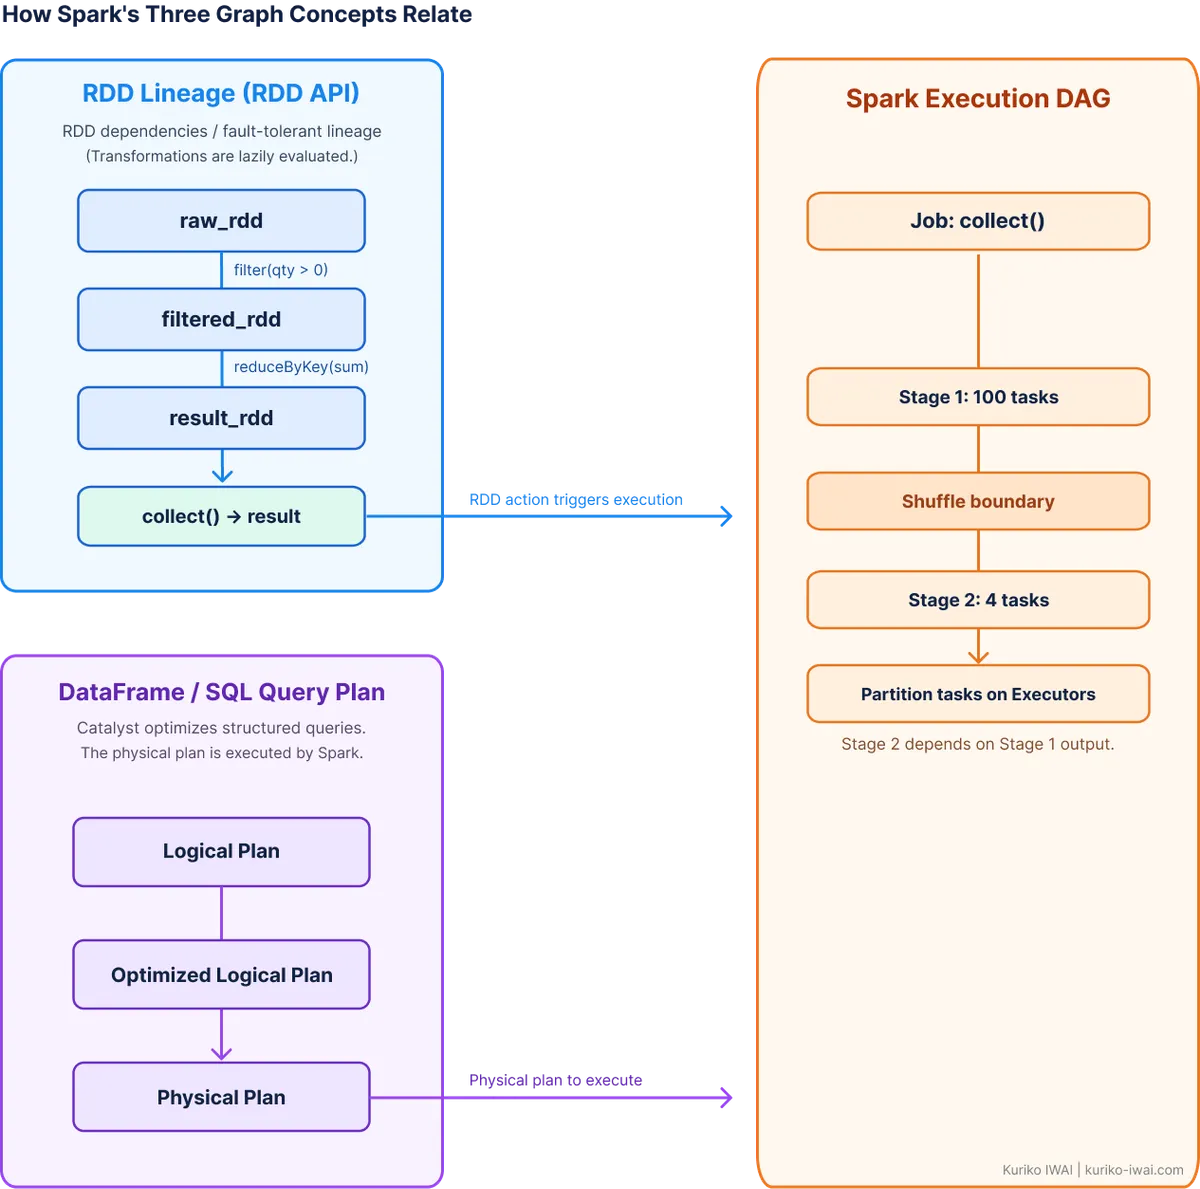
دیتافریمها (DataFrames) API ترجیحی برای ETL ساختاریافتهاند. آنها اسکیم، ستونها و عبارات شبیه SQL را به بهینهساز کاتالیست (Catalyst) عرضه میکنند. برنامه منطقی (اسکن، فیلتر، groupBy، تجمع) از تحلیل، بهینهسازی منطقی (فشردن پردیکت، هرس ستون) و برنامهریزی فیزیکی میگذرد. برنامه فیزیکی برای این تجمع شامل تجمع هش جزئی در هر پارتیشن، تبادل شافل بر اساس SKU و تجمع هش نهایی است. بهینهساز این عملگرها را بهصورت خودکار انتخاب میکند؛ کاربر کد اعلانی مینویسد.
APIهای RDD و دیتافریم یک مسئله را به شیوههای مختلف حل میکنند. کد RDD از تبدیلات صریح استفاده میکند: نگاشت به (sku، qty)، فیلتر qty > 0، reduceByKey برای جمع. کد دیتافریم از sales_df.filter(col('qty') > 0).groupBy('sku').agg(sum('qty')) استفاده میکند. هر دو با collect() اجرا را راهاندازی میکنند. تفاوت: RDD تاپلهای پایتون برمیگرداند؛ دیتافریم اشیاء Row ساختاریافته با فیلدهای نامگذاریشده برمیگرداند. دیتافریم معنای رابطهای را به کاتالیست عرضه میکند و امکان جابجایی جوین، راهنمای پخش (Broadcast Hint) و ادغام پارتیشن را میدهد که RDD نمیتواند.
مرزهای شافل مراحل را تعریف میکنند. فیلتر و تجمع جزئی در یک مرحله بهعنوان تبدیلات باریک (Narrow Transformations) اجرا میشوند. تبادل بر اساس SKU یک تبدیل پهن (Wide Transformation) است — شافل میطلبد و مرحلهی جدیدی آغاز میکند. وظایف در مرحله نهایی پارتیشنهای شافلشده را میخوانند و جمعهای نهایی را محاسبه میکنند. هر مرز مرحله یک نقطه همگامسازی است؛ دیرکندها (Stragglers) در یک مرحله مرحلهی بعد را به تأخیر میاندازند. کمینه کردن حجم شافل و تعادل اندازه پارتیشنها دو اهرم اصلی بهینهسازی هستند.
پیکربندی منبع عملکرد واقعی را میرانند. مقاله نشان میدهد ۷ اجراکننده × ۲ هسته = ۱۴ وظیفه همزمان. با ۱۰۰ پارتیشن، اسپارک ۱۰۰ وظیفه راهاندازی میکند اما فقط ۱۴ همزمان اجرا میشوند. ۸۶ وظیفه باقی در صف میمانند. اگر هر وظیفه ۲ ثانیه ببرد، مرحله حدود ۱۵ موج × ۲ ثانیه = ۳۰ ثانیه طول میکشد. دو برابر کردن اجراکنندهها به ۱۴ (اگر حافظه اجازه دهد) موجها را به ۸ و زمان را به ~۱۶ ثانیه کاهش میدهد. اما بیشتر اجراکننده سربار JVM و بار زمانبندی درایور را بالا میبرد.
تخصیص حافظه در هر JVM اجراکننده مهم است. هیپ ۳ گیگابایتی به حافظه اجرا (برای شافل، جوین، تجمع) و حافظه ذخیره (برای دیتافریمهای کششده) تقسیم میشود. تقسیم پیشفرض ۶۰/۴۰ برای بارهای کار زیادی کار میکند، اما تجمعهای سنگین از حافظه اجرا بیشتر بهرهمندند. حافظه off-heap (از طریق spark.memory.offHeap) میتواند فشار GC را برای شافلهای بزرگ کاهش دهد. مقاله نکته دارد که حافظه اجراکننده کل حافظه نیست — سربار برای Py4J، Netty و بافرهای سیستم خارج از هیپ نشسته است.
استراتژی پارتیشن باید با موازیسازی پاییندست همخوانی داشته باشد. ۱۰۰ پارتیشن اولیه برای کلاستر ۷ اجراکننده ممکن است بیش از حد باشد. ادغام (Coalesce) به ۱۴ یا ۲۸ پارتیشن قبل از شافل سربار راهاندازی وظیفه و فشار زمانبند را کاهش میدهد. اما خیلی کم پارتیشن وظایف بزرگ میسازد که ریسک OOM و دیرکند دارند. نقطه شیرین معمولاً ۲ تا ۴ وظیفه در هر هسته است، یعنی ۲۸ تا ۵۶ پارتیشن برای این کلاستر. اجرای پرسوجوی تطبیقی (AQE) در اسپارک ۳+ میتواند پارتیشنها را در زمان اجرا بهصورت پویا ادغام کند.
پایاسپارک مالیات سریالسازی میافزاید. داده بین JVM و فرآیندهای پایتون از طریق Arrow یا pickle جابجا میشود. تبدیل دستهای Arrow سریعتر است اما اسکیمای سازگار میطلبد. UDFهای پایتون در فرآیندهای جداگانه کارگر پایتون اجرا میشوند، هر کدام با حافظهی خود. UDFهای برداری (pandas UDF) دستهها را پردازش کرده و سربار ردیفبرردیف را حذف میکنند. برای تجمیع فروش، یک عبارت SQL خالص (sum('qty')) در JVM میماند و از پایتون کاملاً پرهیز میکند — ۱۰ تا ۱۰۰ برابر سریعتر از UDF پایتون.
درایور یک نقطه هماهنگی واحد است. نتایج collect() را جمعآوری میکند، DAG میسازد و زمانبندی وظیفه را هندل میکند. فراخوانیهای collect() بزرگ میتوانند درایور را OOM کنند. برای تولید، نتایج را به ذخیرهسازی توزیعشده (Parquet، Delta، Iceberg) بنویسید بهجای کشیدن به درایور. درایور همچنین جداول جستجوی کوچک را به اجراکنندهها پخش میکند؛ جوینهای پخش از شافل جلوگیری میکنند وقتی یک طرف در حافظه جا شود.
نظارت باید روی معیارهای سطح مرحله متمرکز شود: انحراف مدت وظیفه، بایتهای خوانده/نوشته شده شافل، زمان GC و ریزش به دیسک. UI اسپارک اینها را برای هر مرحله نشان میدهد. یک مرحله با ۱۴ وظیفه که یکی ۵ برابر طولانیتر است نشانه انحراف داده است — شاید یک SKU غلبه داشته باشد. نمکگذاری کلید (Salting) یا راهنمای جوین انحراف (Skew Join Hint) میتواند تعادل برقرار کند. ریزش شافل حافظه اجرا ناکافی را نشان میدهد؛ حافظه اجراکننده را افزایش دهید یا موازیسازی را کاهش دهید.
درک این مکانیزمها اسپارک را از یک موتور خوشهی مرموز به یک سیستم قابلتنظیم تبدیل میکند. همان کد بر اساس تعداد پارتیشن، اندازه اجراکننده، کسور حافظه و رفتار شافل بهشکلهای مختلف اجرا میشود. مهندسانی که مسیر از API دیتافریم تا برنامه فیزیکی و راهاندازی وظیفه را ردیابی میکنند، میتوانند اختنکها را قبل از ورود به تولید پیشبینی کنند.
گام بعدی شما
- قبل از اجرای کار بعدی، spark.executor.cores و spark.executor.instances را بررسی کنید تا از بیکار ماندن هستهها جلوگیری شود.
- تعداد پارتیشن را با spark.sql.adaptive.coalescePartitions.enabled در AQE بهینه کنید.
- برای تجمیعهای سنگین، از عبارات SQL خالص بهجای UDFهای پایتون استفاده کنید تا در JVM بمانید.
- معیارهای مرحله در UI اسپارک را رصد کنید: انحراف وظیفه، ریزش شافل و زمان GC سه سیگنال هشداردهندهاند.
اما داستان بهینهسازی حافظه در مقیاس بزرگ حتی جذابتر است — به تحلیل ما دربارهی استراتژیهای off-heap و مدیریت GC در تولید مراجعه کنید.

گفتگو