تصور کنید بهجای ساعتها کلنجار رفتن با سینتکس پایتون، فقط به سیستم بگویید «هدف را به انگلیسی تعریف کن و توصیف کن که خروجیِ صحیح چه شکلی است» و بقیه کار را به ماشین بسپارید. این رویکرد جدید، قلب تپنده ابزارهای جدیدی است که در ۲۴ ژوئن ۲۰۲۶ توسط Strands Labs، بازوی آزمایشی و تجربی AWS، منتشر شد. طبق اعلام این شرکت، این سیستم با بهرهگیری از یک عامل (Agent) مبتنی بر Amazon Bedrock، بار پیادهسازی کد را از دوش انسان برمیدارد تا اسکریپتهای کاربردی پایتون تولید کند.
این تغییر رویکرد، نحوه تعامل برنامهنویسان با مدلهای زبانی بزرگ (LLM) — شبیه کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — را در محیطهای عملیاتی تغییر میدهد. برای سالها، صنعت روی مهندسی پرامپت (Prompt Engineering) — هنر سؤال درست پرسیدن، مثل کسی که میداند چطور از یک مشاور باتجربه بهترین جواب را بگیرد — تکیه کرده بود تا مدلها را به سمت دقت سوق دهد؛ فرآیندی که اغلب با پیشبینیناپذیری همراه بود. این رویکرد یادآور پیشرفتهای اخیر در ابزارهای توسعه خودکار است، مشابه آنچه در بررسی جامع suite توسعه خودکار Code Enchanter دیدیم که تمرکز را از نوشتن توابع به معماری سیستمهای پیچیده منتقل کرد. اکنون Strands Labs مدلی بر اساس «توسعه آزمونمحور» (TDD) ارائه میدهد؛ در این مدل، توسعهدهنده ابتدا آزمون (Test) را مینویسد و سپس اجازه میدهد عامل هوشمند، کد مربوطه را مدیریت و تولید کند.
همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن دیدیم، اعتماد مطلق به خروجی مدلها ریسک بالایی دارد. به همین دلیل، هسته این سیستم بر پایه دکوراتور @ai_function طراحی شده است. در اینجا توسعهدهنده بهجای نوشتن بدنه تابع، یک docstring (توضیحات متنی) ارائه میدهد که منطق موردنظر را بهدقت مشخص میکند و بدنه تابع را کاملاً خالی میگذارد. برای پر کردن این «شکاف اعتماد»، فریمورک از «شرایط پساز-اجرا» (Post-conditions) استفاده میکند؛ یعنی ادعاهایی (Assertions) که ساختار داده و نوع خروجی را در زمان اجرا (Runtime) اعتبارسنجی میکنند.
به نقل از مستندات فنی این ابزار، در یک پیادهسازی معمولی، توسعهدهنده میتواند تابعی مانند check_invoice_dataframe را تعریف کند تا به عنوان یک شرط پساز-اجرا عمل کند. این تابع با استفاده از Assertionها تضمین میکند که ستونهای خاصی — مانند 'product_name' (نام محصول)، 'quantity' (تعداد)، 'price' (قیمت) و 'purchase_date' (تاریخ خرید) — حتماً در یک DataFrame از کتابخانه pandas وجود داشته باشند. این سیستم فراتر رفته و انواع دادهها را نیز اعتبارسنجی میکند تا مطمئن شود 'quantity' یک عدد صحیح (Integer)، 'price' یک عدد اعشاری (Float) و 'purchase_date' از نوع datetime64 باشد.
اگر کد تولیدشده توسط هوش مصنوعی در این بررسیها شکست بخورد، سیستم صرفاً یک خطا نمیدهد. بلکه با تحلیل بستر شکست (Failure Context)، فرآیند تولید کد را بهصورت خودکار تکرار میکند. در واقع، مدل زبانی موتور محرک است و اعتبارسنجیها، ترمز ایمنی؛ شما به درستیِ مدل اعتماد نمیکنید، بلکه به اعتبارسنجیهای خودتان اعتماد میکنید تا هر خطایی را شکار کنند. این یک سیستم حلقه-بسته (Closed-loop) ایجاد میکند که در آن LLM موتور است و Assertionها شبکه ایمنی هستند.

در لایه پیادهسازی فنی، توسعهکنندگان با الگوهای ساختاری زیر مواجهاند:
- دکوراتور: دکوراتور
@ai_functionپارامترهایی نظیرcode_execution_mode="local"وcode_executor_additional_importsرا میپذیرد تا محیط اجرای کد را تعریف کند. - الزامات وارد کردن (Import): این فریمورک از دستور
from ai_functions import ai_functionاستفاده کرده و برای دستکاری دادهها به شدت به کتابخانه pandas متکی است. - بستر اجرا (Execution Context): با تعریف
code_executor_additional_imports=["pandas.*", "sqlite3", "json"]توسعهدهنده به عامل دقیقاً میگوید که مجاز است از کدام کتابخانهها برای پیادهسازی استفاده کند. - حلقه اعتبارسنجی: آرگومان
post_conditions=[check_invoice_dataframe]فرآیند تولید را به تابع اعتبارسنجی گره میزند تا تضمین شود هوش مصنوعی تا زمانی که دادهها با مشخصات فنی مطابقت ندارند، پیش نمیرود.
یکی از کاربردیترین موارد استفاده، مدیریت فایلهای با فرمتهای ناشناخته یا متنوع است. یک AI Function میتواند بهگونهای طراحی شود که دادههای فاکتور را فارغ از اینکه منبع یک فایل JSON است یا یک دیتابیس SQLite، وارد کند. در رویکردهای سنتی، این کار نیازمند دهها خط کد برای تشخیص فرمت، نوشتن منطق تبدیل برای هر مورد، مدیریت حالتهای خاص (Edge Cases) و سازماندهی تلاشهای مجدد بود.
با AI Functions، عامل ابتدا فایل را بررسی میکند، فرمت را تشخیص میدهد و منطق تجزیه (Parsing) لازم را در لحظه تولید میکند. برای مثال، فراخوانی import_invoice('data/invoice.json') یا import_invoice('data/invoice.sqlite3') از یک منطق تابعی یکسان استفاده میکند، در حالی که یک تابع مجزا مانند fuzzy_merge_products(df) میتواند ادغام نسخههای مختلف نام محصولات را مدیریت کند.
علاوه بر استخراج ساده دادهها، این فریمورک گردشکارهای پیچیدهتری را نیز پشتیبانی میکند:
- جریانهای چندعاملی ناهمگام (Async Multi-Agent): توسعهدهندگان میتوانند چندین فراخوانی
@ai_functionرا با استفاده ازasyncio.gatherترکیب کنند تا وظایف بهصورت موازی اجرا شوند. برای مثال، یک تابعresearch_stockمیتواند بهطور همزمان عاملهایresearch_newsوresearch_priceرا فعال کرده و نتایج را در یک شیء واحدStockInfoتجمیع کند. این امر ترکیب عاملها را به صورت ناهمگام، موازی و با ایمنی نوع (Type-safe) ممکن میسازد. این رویکرد به جای استفاده از زبانهای توصیفی، بر قدرت پایتون متکی است؛ مشابه تغییری که در پروژه Apache Burr با حذف YAML برای شفافیت بیشتر در تصمیمات عاملها ایجاد شد. - ایمنی نوع داده: با بهرهگیری از pandas و پایتون ۳.۱۲ به بالا (توصیه شده ۳.۱۴+)، سیستم تضمین میکند که DataFrameها یکپارچگی سختگیرانه طرحواره (Schema Integrity) را حفظ کنند. این باعث میشود عاملهای هوش مصنوعی مانند توابع استاندارد و Type-safe پایتون رفتار کنند.
- اجرای محلی: حالت
code_execution_mode="local"اجازه میدهد تا سرعت تکرار و تست در طول مراحل توسعه بهشدت افزایش یابد.
تلاشهای Strands Labs تنها به توابع نرمافزاری محدود نمیشود. این سازمان دو پروژه بزرگ دیگر را برای پر کردن شکاف بین زبان طبیعی و اقدام فیزیکی عرضه کرده است. پروژه Robots Sim به عاملها اجازه میدهد تا وظایف خود را در محیطهای شبیهسازی شده با استفاده از یک سیاست تقلبی (Mock Policy) یا سرویس استنتاج GR00T به پایان برسانند. کاربران میتوانند با اجرای دستور python examples/libero_example.py مشاهده کنند که یک عامل چگونه یک وظیفه را در محیط شبیهساز تکمیل میکند.
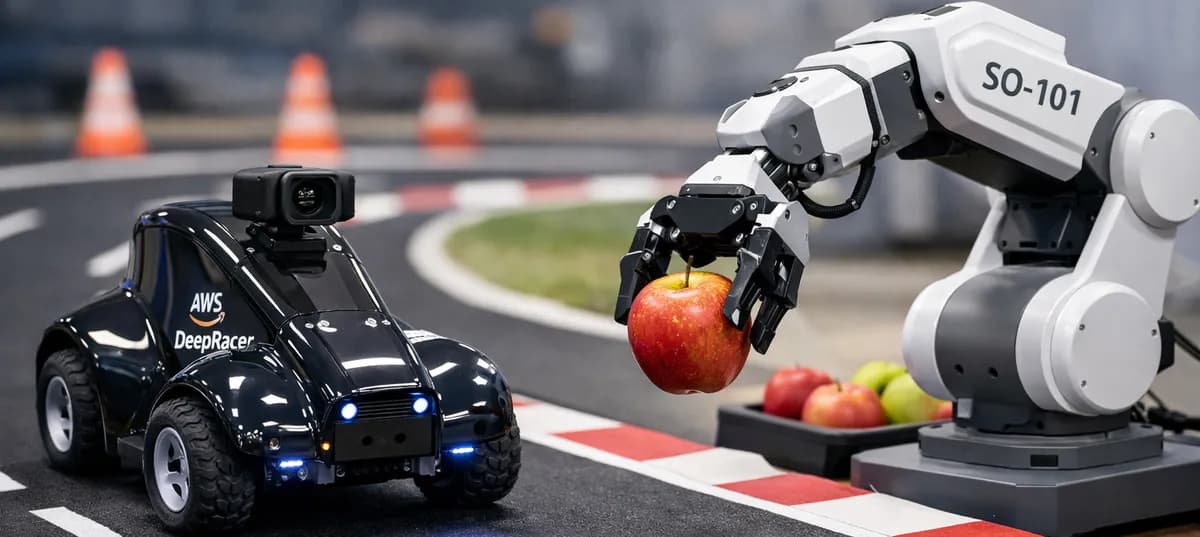
برای کسانی که سختافزارهای فیزیکی در اختیار دارند، پروژه Strands Robots کنترل بازوی رباتیک SO-101 و دستگاههای Jetson را ممکن میکند. این پیشرفت در کنترل سختافزار از طریق کدنویسی خودکار، یادآور پژوهشهای اخیر انویدیا است که در آن عاملهای کدنویس دقت رباتیک را به ۹۹٪ رساندند. با ترکیب اینها، AWS به سمتی میرود که یک خط دستور به زبان طبیعی بتواند بازوی رباتیک را در دنیای واقعی حرکت دهد. این گردشکار شامل راهاندازی سرویس استنتاج GR00T و دنبال کردن یک راهنمای شروع سریع برای انتقال از شبیهساز به سختافزار فیزیکی است.
فلسفه Strands Labs بر این است که بهطور عمدی از SDK اصلی Strands جدا شود تا از رکود چرخه نسخههای تجاری سنتی دوری کند. این یک انتخاب معماری است تا توسعه سریع، تجربی و جامعهمحور ممکن شود. این استراتژی به تیم اجازه میدهد کدهای آزمایشی را تحت لایسنس Apache-2.0، بدون فشار محدودیتهای تولید صنعتی، منتشر کند.
هر پروژه در این مجموعه ملزم است با موارد زیر عرضه شود:
- موارد استفاده (Use Cases) شفاف و تعریفشده
- کد و تستهای عملیاتی و فعال
- مستندات جامع
این استراتژی «مرز» توسعه هوش مصنوعی را هدف قرار داده است؛ جایی که سرعت و بازخورد جامعه برنامهنویسان ارزشمندتر از پایداری در سطح سازمانی است. این ابزارها محیطی برای آزمایش عاملهایی فراهم میکنند که واقعاً میتوانند بر دنیای فیزیکی یا خط لولههای داده پیچیده تأثیر بگذارند. این پاسخ AWS به سؤال «مسیر حرکت به کجاست؟» است؛ ارائه کدهای working بهجای اسلایدهای Roadmap.
این تغییر نشان میدهد که آینده توسعه هوش مصنوعی از «چت کردن» با مدلها بهسمت «ارکستراسیون» عاملهای خودمختاری میرود که توسط اصول سختگیرانه مهندسی نرمافزار محدود شدهاند. برای برنامهنویس، این یعنی تغییر مهارت از «نوشتن سینتکس» به «تعریف محدودیتها».
برای شروع، توسعهدهندگان میتوانند کتابخانه را با دستور pip install strands-ai-functions نصب کنند. پیشنیازها شامل پایتون ۳.۱۲+ (توصیه شده ۳.۱۴+) و اعتبارنامههای معتبر برای ارائهدهندگان مدلهای پشتیبانی شده مانند AWS Bedrock یا OpenAI است.
بسته به سطح تجربه کاربر، AWS نقاط ورود متفاوتی را پیشنهاد میکند:
- تازهواردان به عاملهای Strands: با Strands SDK اصلی شروع کنند تا با رویکرد مدلمحور آشنا شوند و عاملهای سادهای با یک یا دو ابزار بسازند.
- کاربران مسلط به Strands: بین AI Functions (با کلون کردن
strands-labs/ai-functionsو اجرای مثال خلاصهسازی جلسات) یا Simulation (با کلون کردنstrands-labs/robots-simو استفاده از مثال Libero) انتخاب کنند. - مالکان سختافزار: بازوی SO-101 و دستگاه Jetson را آماده کرده، سرویس استنتاج GR00T را مستقر نموده و مثال کامل گردشکار را اجرا کنند.
جامعه برنامهنویسان تشویق شدهاند تا در مخازن متنباز مشارکت کنند. بهطور خاص، پروژه robots-sim برای پیادهسازی ACT و SmolVLA به عنوان ارائهدهنده سیاست (Policy Provider) نیاز دارد. همچنین رفع باگها، بهبود مستندات و افزودن مثالهای جدید مورد استقبال قرار میگیرد.
در نهایت، رعایت پروتکلهای پاکسازی و ایمنی هنگام آزمایش این ابزارها حیاتی است:
- AI Functions: برای اجرای محلی نیازی به پاکسازی نیست، اما کاربران باید هزینههای فراخوانی مدل در AWS Bedrock را رصد کنند.
- Robots Sim: کانتینرهای Docker باید از طریق
docker stop <container_id>متوقف شده و ایمیجها با دستورdocker rmi <image_id>حذف شوند. - Strands Robots: سختافزار رباتیک باید بهطور ایمن خاموش شده و اتصالات سریال و دوربینها قطع گردند. همچنین تمام سرویسهای استنتاج GR00T باید متوقف شوند.
از روزهای اولیه خودروهای DeepRacer که در پذیرایی خانهها میچرخیدند تا امروز که عاملها بازوهای رباتیک را از طریق زبان طبیعی کنترل میکنند، جهش بزرگی در قابلیتها رخ داده است. Strands Labs فصل جدیدی است که ابزارهای واقعی را جایگزین دموهای ساده میکند تا توسعهدهندگان بتوانند سیستمهای خودمختار را در دنیای واقعی بسازند، بشکنند و بهینهسازی کنند.
گام بعدی شما
- اگر با پایتون آشنا هستید، کتابخانه
strands-ai-functionsرا نصب کرده و یک تابع برای تبدیل فایلهای متفرقه به فرمت استاندارد بسازید. - برای کاهش توهمات مدل در تولید کد، توابع اعتبارسنجی (Post-conditions) سختگیرانهتری تعریف کنید.
- اگر به رباتیک علاقهمندید، دموهای پروژه
robots-simرا برای درک نحوه تعامل مدلهای زبانی با محیط فیزیکی بررسی کنید.
اما اثر این اتوماسیون کدنویسی بر بازار کار برنامهنویسان حتی پیچیدهتر است — به تحلیل ما دربارهی آینده مهندسی نرمافزار در عصر عوامل مراجعه کنید.



گفتگو