
اگر امروز برای نوشتن مقالات دانشگاهی از هوش مصنوعی استفاده میکنید، احتمالاً متوجه شدهاید که مرز بین متنی انسانی و خروجیهای رباتیک بسیار باریک شده است. دادههای جدید نشان میدهد دانشجویان برای مرحله نهایی نوشتن، تعادل را به استدلال محض ترجیح میدهند. در حالی که برخی مدلهای هوش مصنوعی بر ساختار مکانیکی یا استدلالهای افراطی تمرکز میکنند، دانشجویان برای مراحل پایانی نگارش، به دنبال توازنی میان این ویژگیها هستند.
در یک آزمون کور (Blind Test) که روی ۶۸۵۱ دانشجو اجرا شد، جمینای (Gemini) با نرخ انتخاب ۳۹.۶٪ به محبوبترین ابزار برای نگارش مقالات تبدیل شد. نوشتن برای محیطهای آکادمیک همواره نبردی میان «خیلی رباتیک به نظر رسیدن» و «خیلی مبهم بودن» بوده است. دانشجویان اغلب برای حفظ لحن شخصی خود در عین رعایت ساختارهای سختگیرانه دانشگاهی دچار چالش میشوند. همانطور که در تحلیل قبلی ما دربارهی قابلیتهای جمینای فلش (Gemini Flash) در خودکارسازی وظایف پیچیده اشاره کردیم، این دادههای جدید نشان میدهد تطبیقپذیری این مدل به دنیای ظریف نثر دانشجویی نیز گسترش یافته است.
به نقل از گزارش اوت ۲۰۲۶ منتشر شده توسط استادیارنا (StudyArena)، نتایج از طریق یک «میدان رقابت کور» جمعآوری شده است؛ به این معنا که دانشجویان بدون دانستن نام مدل، به بهترین پاسخ رای دادند. این روش باعث شد وفاداری به برند، سوگیریهای مربوط به اشتراک یا تصورات پیشین درباره برتری یک مدل خاص، از معادله حذف شود. در این آزمایش، پاسخها مجبور بودند صرفاً بر اساس کیفیت روی کاغذ برنده شوند. این تمایل به استفاده از ابزارهای هوش مصنوعی در محیطهای تخصصی، تنها محدود به دانشجویان نیست و حتی در سطوح بالای روزنامهنگاری نیز دیده میشود؛ چنانکه اخیراً ۸ برنده و فینالیست جایزه پولیتزر استفاده از ابزارهای هوش مصنوعی را افشا کردند.
جدول ردهبندی نویسندگی
جمینای جایگاه نخست را در وظایف نویسندگی و مقاله کسب کرد و پس از آن کلود (Claude) با ۳۱.۸٪ و مدلهای اوپنایآی (OpenAI) با ۲۹.۲٪ قرار گرفتند.
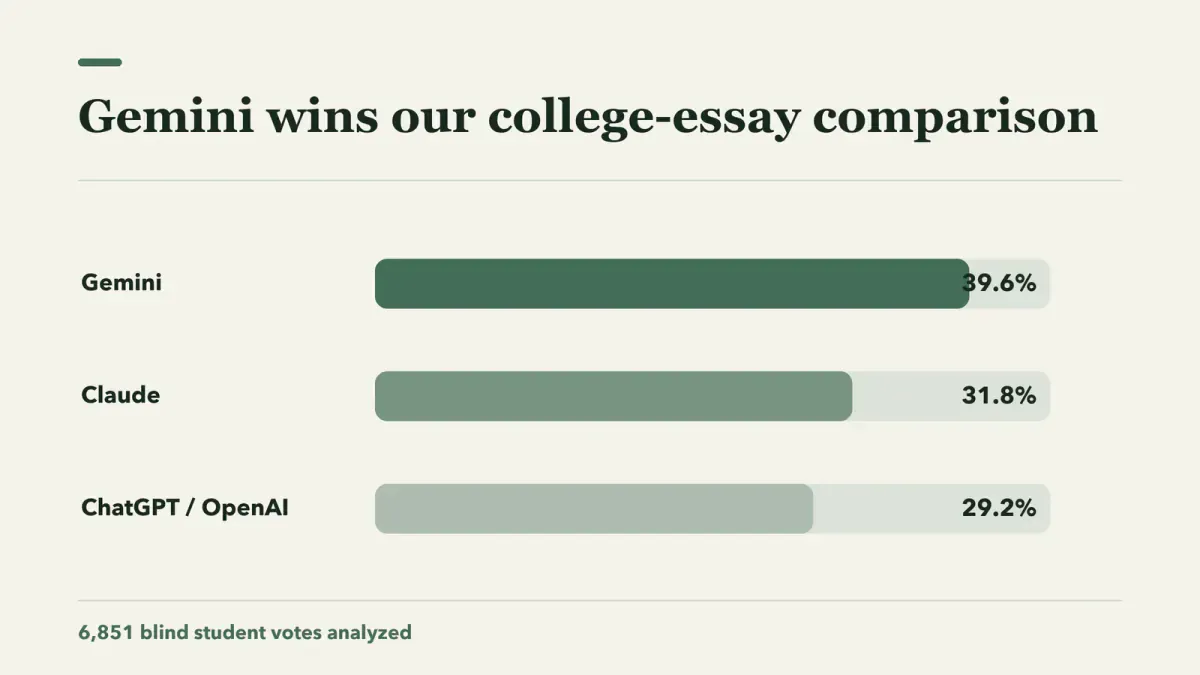
بستر این پیروزی
نگارش دانشگاهی بهندرت به یک ویژگی افراطی پاداش میدهد. بهترین پاسخ باید کامل باشد اما بیساختار نشود، منظم باشد اما مکانیکی به نظر نرسد و شفاف باشد اما لحن نویسنده را از بین نبرد. جمینای خانوادهای بود که دانشجویان در مواجهه با این موازنه در وظایف واقعی، بیشتر انتخاب کردند.
این نتایج بازتابدهنده نسل فعلی مدلهاست. در این رقابت، برخلاف بسیاری از مقایسههای دیگر که به نسلهای قدیمیتر ارجاع میدهند، از مدلهای GPT-5.6 Sol، Claude Opus 5 و Gemini 3.1 Pro استفاده شده است. در حالی که مدلهای غولپیکر در این آزمونها میدرخشند، بحثهای صنعتی نشان میدهد که مدلهای زبانی کوچک با کاهش هزینههای استنتاج در حال تبدیل شدن به برنده واقعی در محیطهای عملیاتی هستند.
پارادوکس طول متن و استدلال
بر اساس مستندات StudyArena، همبستگی شدیدی بین طول پاسخ و ترجیح دانشجویان وجود دارد. پاسخهای منتخب بهطور متوسط ۳۷٪ طولانیتر از جایگزینها بودند. در مقایسههای تعیینکننده، طولانیترین پاسخ در ۴۷.۷٪ موارد برنده شد، در حالی که کوتاهترین پاسخها همچنان ۲۵٪ رای آوردند.
نکته جالب اینجاست که تنظیمات استدلال (Reasoning) بالاتر، کیفیت نوشتار را بهبود نبخشید. در واقع دادهها یک رابطه معکوس را نشان دادند:
- تلاش کم (Low effort): نرخ انتخاب ۴۰.۷٪
- تلاش متوسط (Medium effort): نرخ انتخاب ۳۳.۳٪
- پیشفرض (Default): نرخ انتخاب ۳۰.۸٪
- تلاش زیاد (High effort): نرخ انتخاب ۲۹.۵٪
استدلال بیش از حد اغلب منجر به افزودن نکات زائد، توجیهات طولانی و تکرار میشود. در حالی که این ویژگی برای تدوین یک برنامه پژوهشی یا اثبات ریاضی مفید است، اما به نثر آسیب میزند. این مطالعه پیشنهاد میکند تنظیمات «تلاش زیاد» برای تحلیل شواهد مناسب است، نه برای نوشتن جملات.
ابزارهای تخصصی برای مراحل مختلف
با وجود پیروزی کلی جمینای، دادهها نشان میدهند که رویکرد «تکابزاری» بهینه نیست. عبارت «نوشتن یک مقاله دانشگاهی» در واقع مجموعهای از چندین شغل مختلف است و هر مدل در یک مرحله پیشرو بود:
- ChatGPT / OpenAI: پیشرو در کارهای پژوهشی (۳۹.۳٪). این مدل بهترین ابزار برای یافتن استدلال، ترسیم ادعاها، شناسایی اعتراضات و فهرست کردن حقایقی است که نیاز به تایید دارند.
- Claude: پیشرو در برنامهریزی تکالیف (۴۳.۲٪). این ابزار پیش از شروع پیشنویس، برای پیشنهاد ساختارهای متمایز و توضیح هزینههای هر ساختار، مفیدترین است.
- Gemini: پیشرو در بازخورد نویسندگی (۴۱.۷٪). این مدل در تشخیص بخشهای مبهم، کلیشهای یا متمرکز نشده در پیشنویسهای موجود تخصص دارد.
گردش کار پیشنهادی برای دانشجویان
برای رسیدن به بالاترین کیفیت، این گزارش پیشنهاد میکند از این مدلها مانند یک تحریریه مجازی استفاده کنید. جریان کاری پیشنهادی با نوشتن دستی متریال خام توسط دانشجو شروع میشود تا واقعیتها، صحنهها، نقلقولها و ادعاها صادقانه باقی بمانند.
سپس، دانشجو باید از جمینای برای تشخیص ضعیفترین تصمیمات پیشنویس استفاده کند، بدون اینکه اجازه دهد هوش مصنوعی متن را بازنویسی کند. اجرای همین درخواست در کلود و ChatGPT اجازه میدهد مقایسهای کور از نقدها صورت گیرد تا مشخص شود نقد کدام مدل مفیدتر است، پیش از آنکه لوگوی مدل دیده شود.
در نهایت، نویسنده باید سند را خودش بازنویسی کند. هدف این است که هوش مصنوعی مشکل را پیدا کند و انسان مالک جمله باشد. گام آخر، بازبینی دستی منابع است تا نویسنده از منبع اصلی پیروی کند، نه از استنادی که توسط یک چتبات ابداع یا خلاصه شده است.
این رویکرد مانع از ایجاد «نثر کمیتهای» میشود؛ وضعیتی که در آن نویسنده کورکورانه تمام پیشنهادات هوش مصنوعی را ترکیب میکند و در نهایت صدای شخصی خود را از دست میدهد. این روش تضمین میکند که مقاله نهایی دقیق باقی بماند و به لحن نویسنده وفادار باشد.
پرامپتنویسی برای قضاوت
چه در حال نوشتن یک بیانیه شخصی (Personal Statement) باشید و چه یک تحلیل ادبی، کلید موفقیت در استفاده از پرامپتهایی است که «قضاوت» مدل را فعال کند، نه توانایی تولید متن آن را.
- برای بیانیههای شخصی: بهجای «مقاله من را بنویس»، بپرسید: «این متن را بازنویسی نکن. بخشهایی را شناسایی کن که هر متقاضی دیگری هم میتوانست آنها را بنویسد. به من بگو خواننده هنوز چه چیزی درباره من نمیداند و سوالاتی بپرس که جزئیات خاصتری را آشکار کند.»
- برای مقالات استدلالی: از این پرامپت استفاده کنید: «ضعیفترین پیشفرض من، قویترین استدلال مخالف و هر ادعای واقعی که نیاز به منبع دست اول دارد را شناسایی کن. شواهدی اضافه نکن و پیشنویس را بازنویسی نکن.»
- برای تحلیل ادبی: بپرسید: «تفسیر را از خلاصه داستان جدا کن. نشان بده کجا پاراگراف ادعایی مطرح کرده که از متن استخراج نشده است. بهجای جملات جایگزین، سوال پیشنهاد بده.»
- برای پاسخهای کوتاه: استفاده کنید: «بخشهای مقدماتی که میتوانم حذف کنم، جزئیاتی که باید حفظ کنم و جملهای که بهترین پاسخ به سوال است را علامتگذاری کن. پاسخ را با لحن من حفظ کن.»
برای کسانی که تنها یک اشتراک میخواهند، در حال حاضر جمینای توصیه میشود. اما برای مقالات حساس، رویکرد چندمدلی یک سیستم کنترل و تعادل ضروری ایجاد میکند. همیشه خودتان سردبیر اصلی باشید.
منتظر بهروزرسانیهای جدول ردهبندی StudyArena باشید، زیرا با رای دادن بیشتر دانشجویان و ورود نسخههای جدید مدلها، ممکن است رتبهبندیهای فعلی تغییر کند.
گام بعدی شما
- برای پیشنویس بعدی، بهجای درخواست «بازنویسی»، از مدل بخواهید بخشهای «کلیشهای» متن شما را شناسایی کند.
- مراحل پژوهش را در ChatGPT، ساختار را در Claude و نقد نهایی را در Gemini تست کنید تا تفاوت خروجیها را حس کنید.
- هرگز اجازه ندهید مدل جملات نهایی را بنویسد؛ از هوش مصنوعی برای یافتن «سوراخهای استدلالی» استفاده کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو