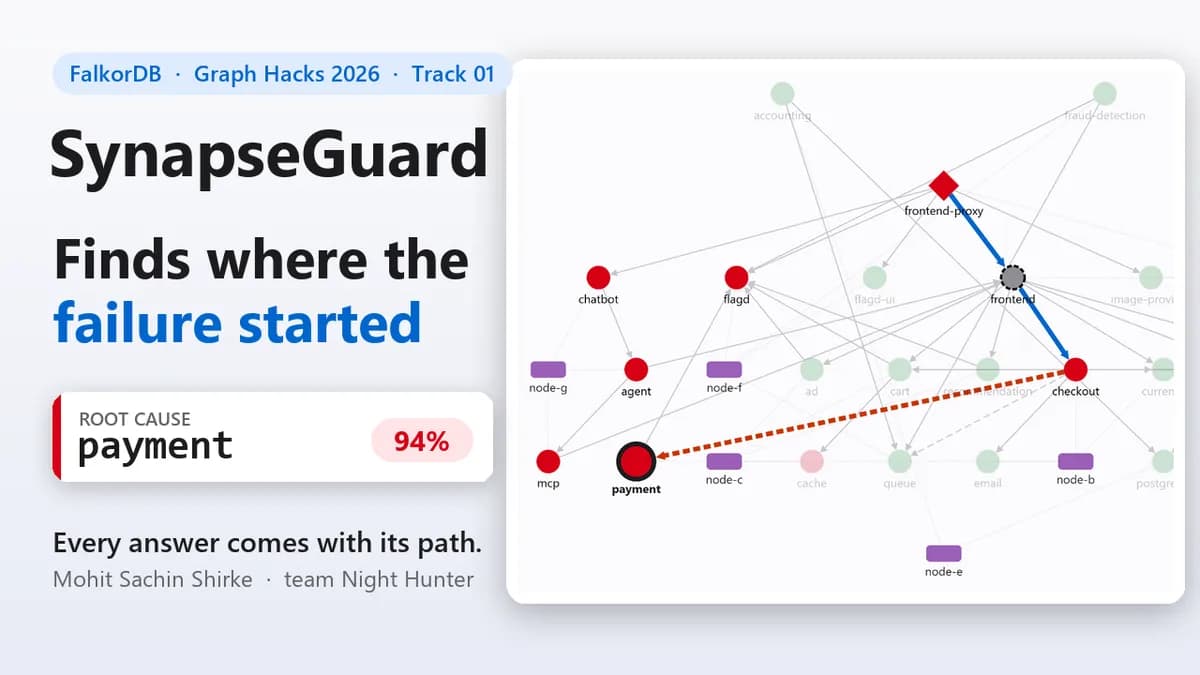
تصور کنید تفاوت بین دیدن دادهها به شکل یک لیست ساده با دیدن آنها به شکل یک نقشهی جامع را. طبق گزارش فنی منتشر شده در ۱۷ اکتبر ۲۰۲۶، یک عامل (Agent) — شبیه به یک کارآگاه دیجیتال که به جای خواندن گزارشها، روابط بین متهمان را ترسیم میکند — به نام SynapseGuard توانسته است علت ریشهای شکستهای سیستمی شبیهسازیشده را در ۹۵.۲٪ موارد بهدرستی شناسایی کند.
این عدد در مقایسه با صحت ۸۱.۶ درصدی مدلهای مبتنی بر ردیف (Row-based) که از همان سیگنالها استفاده میکردند اما فاقد نقشهبرداری از روابط بودند، یک جهش بزرگ است. حتی نسخههای ابتدایی این پروژه که صرفاً «عمیقترین سرویس معیوب» را انتخاب میکردند، تنها به صحت ۲۵ درصدی دست یافته بودند.
معماریهای مدرن میکروسرویس اغلب با هشدارهای «دزد و آتش» دستوپنجه نرم میکنند؛ هشداری که میگوید آتشسوزی رخ داده، اما هرگز نمیگوید در کدام اتاق شروع شده است. وقتی فرآیند پرداخت در یک سایت مختل میشود، هشدار در لایهی بیرونی (پراکسی) فعال میشود: پراکسی خطا برمیگرداند و تأخیر (Latency) در فرانتاند به شدت افزایش مییابد. در حالی که آتش واقعی معمولاً چندین گام پایینتر در زنجیرهی فراخوانیهاست. مهندسان عملیات معمولاً دقایق طلایی ابتدایی یک حادثه را صرف این میکنند که به صورت دستی بفهمند چه کسی چه کسی را فراخوانی کرده، چه تغییری اعمال شده و چه کسی مالک مؤلفهی معیوب است. این چالشها دقیقاً همان نقاط ضعفی هستند که در معماریهای جدید برای خودکارسازی رفع حوادث زیرساختی با هدف تضمین ایمنی عملیاتی مورد بررسی قرار گرفتهاند.
همانطور که در تحلیلهای پیشین ما دربارهی امنیت و پایداری مدلهای عاملمحور اشاره کردیم، مدیریت زمینه (Context) کلید موفقیت است. SynapseGuard این مشکل را با تبدیل کل زمینهی سیستم به یک گراف واحد در FalkorDB حل میکند. این گراف شامل مسیر فراخوانی سرویسها (بر اساس توپولوژی واقعی OpenTelemetry Demo)، تلهمتری زنده روی هر سرویس و محل استقرار میزبانها (Host Placement) است. همچنین دادههای گزارش تغییرات — شامل استقرارها (Deploys)، تغییرات پیکربندی و پرچمهای ویژگی (Feature Flags) — و دادههای انسانی مانند تیمها، مالکان، چرخه آنکال (On-call) و نویسندگان تغییرات را در خود جای داده است. در نهایت، این سیستم حافظهی خودِ عامل از حوادث گذشته و اقدامات پیشنهادی قبلی را نیز ذخیره میکند.
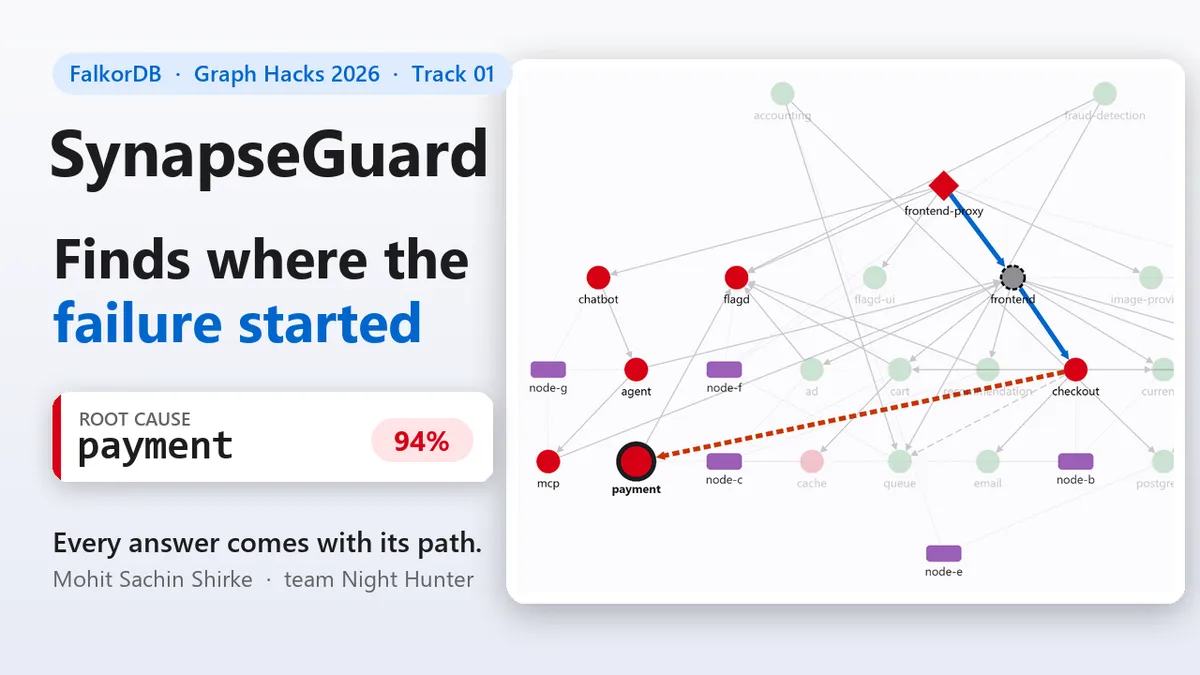
سازوکار عملیاتی عامل گرافی
این عامل برای جلوگیری از توهم (Hallucination) — یعنی وقتی مدل با اطمینان چیزی میگوید که اصلاً وجود ندارد — از دسترسی آزاد به پایگاهداده پرهیز میکند. در عوض، از یک کاتالوگ ثابت از ابزارهای پارامتریک زبان Cypher که توسط انسان نوشته شدهاند و از طریق یک سرور پروتکل زمینهٔ مدل (MCP) ارائه میشوند، استفاده میکند. این رویکرد در راستای پیادهسازی لایههای امنیتی برای جلوگیری از خطاهای دائمی عاملها است تا از اجرای دستورات غیرمنتظره جلوگیری شود. این ابزارها شامل توابع خاصی مانند blast_radius (محاسبه شعاع اثر)، who_to_page (شناسایی فرد مسئول)، path_between (یافتن مسیر بین دو نقطه) و recent_changes (بررسی تغییرات اخیر) هستند. نامها پیش از اجرای هر کوئری در گراف بررسی میشوند؛ اگر کاربر دربارهی یک «payments-gateway» غیرموجود بپرسد، عامل پاسخ میدهد که این نام در گراف نیست و میپرسد که آیا منظور کاربر «payment» بوده است یا خیر.
به نقل از مستندات پروژه، وقتی حادثهای رخ میدهد، عامل پنج عملیات ساختاری را اجرا میکند که در جداول معمولی غیرممکن است:
- هرس کردن دسترسیپذیری (Reachability Pruning): عامل لبههای فراخوانی همزمان (Synchronous CALLS) را از سرویس هشداردهنده دنبال میکند، اما فقط به سرویسهای ناسالم وارد میشود و این کار را گامبهگام انجام میدهد. برای هر گام، از یک کوئری Cypher مبتنی بر ایندکس استفاده میکند. اگر پایگاهدادهای خراب باشد اما از نقطه علامتدار (Symptom) غیرقابل دسترس باشد، به عنوان علت حادثه نادیده گرفته میشود.
- امتیازدهی شواهد (Evidence Scoring): در داخل زیرگراف، عامل میپرسد که آیا چیزی در پایینتر از کاندیدای فعلی، افت کیفیت را توضیح میدهد؟ چه مقدار از این افت کیفیت توجیه میشود؟ و آیا کاندیدای فعلی زودتر از بقیه دچار افت شده و فراخوانندههایش در کمتر از یک دقیقه به دنبال آن دچار مشکل شدهاند؟ همچنین بررسی میکند که آیا تغییری درست قبل از حادثه اعمال شده یا چندین سرویس معیوب روی یک میزبان اشباعشده قرار دارند.
- نقشهبرداری مالکیت (Ownership Mapping): یک مسیر قابل تایید از خطا به انسان میسازد (مثلاً:
p-alice → ON_CALL → team-checkout → OWNS → payment) و نویسندهی تغییر خاصی که باعث خطا شده را شناسایی میکند. - محاسبه شعاع اثر (Blast Radius Calculation): شعاع اثر را محاسبه کرده و با اجرای الگوریتم
algo.maxFlowدر FalkorDB، ارزانترین نقاط برای قرار دادن مدارشکنها (Circuit Breakers) را پیدا میکند تا کاربران را از نقطه خطا جدا کند. - تایید انسانی (Human-in-the-Loop): هر اقدام پیشنهادی باید توسط یک انسان تایید و اجرا شود. وقتی عامل در مورد پاسخ خود مطمئن نیست، آن را برای بازبینی علامتگذاری میکند.
در یک سناریوی دمو، یک «پرچم ویژگی» (Feature Flag) باعث خرابی سرویس پرداخت شد، در حالی که یک استقرار نامرتبط در فرانتاند نقش گمراه کننده (Red Herring) داشت. SynapseGuard با اطمینان نسبی ۹۴ درصدی، علت ریشهای را سرویس پرداخت تشخیص داد و اشاره کرد که پرچم مذکور ۷۹ ثانیه قبل از افت کیفیت اعمال شده است و سپس آلیس، مالک آنکال، را فراخواند.
بنچمارکها و اصطکاکهای دنیای واقعی
در آزمایشهایی با مدل llama3.1:8b روی CPU، عامل در ۱۲ مورد از ۱۲ پرسش، ابزار درست را انتخاب کرد. برای جلوگیری از توهم، هر جمله نهایی که نامی را ذکر کند که ابزارها برنگرداندهاند، رد میشود.
اما انتقال از دادههای شبیهسازیشده به دادههای واقعی، شکافی جدی را آشکار کرد. طبق گزارش توسعهدهنده، در محک RCAEval — که یک بنچمارک عمومی از تزریق خطاهای واقعی در سیستمهای Online Boutique, Sock Shop و Train Ticket است — برتری گراف کمرنگ شد. برای سیستم Train Ticket، گراف فراخوانی از ۵۷۴,۴۷۹ اسپان (Span) واقعی Jaeger استخراج شده بود. در Online Boutique، این روش تمام لبههای گراف دستنویس توسعهدهنده را تایید کرد.
با تنظیمات پیشفرض، رتبهبندی گراف با یک مدل ردیفی قوی برابری میکرد. در برخی موارد، عملکرد مدل گرافی حتی ۴ امتیاز ضعیفتر از مدلهای بدون گراف در دادههای Train Ticket بود. اگرچه مدل گرافی در ۴ مورد از ۶ مجموعه سیستم (هنگام استفاده از وزنهای یادگرفته شده از سیستمهای واقعی دیگر) پیروز شد، اما توسعهدهنده تنظیمات پیشفرض محصول را تغییر نداد. دلیل این اتفاق این بود که RCAEval فاقد گزارش تغییرات و دادههای استقرار میزبان است که گراف از آنها بهره میبرد. بدون توانایی ترکیب تلهمتری با تغییرات ساختاری، گراف هیچ مزیت منحصربهفردی نسبت به یک مدل ردیفی قوی ندارد. دادههای واقعی همچنین باگی را آشکار کردند که در آن امتیاز شدت (Severity Score) در مقدار ۱.۰ اشباع میشد و نمیتوانست بین سرویسها تفاوت قائل شود.
درسهای فنی از FalkorDB
فشار آوردن به این سیستم، دو باگ جدی در FalkorDB 6.0.2 را افشا کرد. یکی مربوط به ساختار کوئری با دو عبارت MATCH … WHERE … IN $list بود که بدون قرار دادن یک عبارت WITH بین آنها، بهصورت خاموش هیچ ردیفی برنمیگرداند. مورد دیگر، کوئری شامل دو عبارت OPTIONAL MATCH به همراه یک تجمیع (Aggregation) و ORDER BY بود که منجر به کرش کردن سرور میشد.
بهینهسازیها نشان داد که استفاده از WHERE n.id IN $list از ایندکس استفاده میکند، در حالی که UNWIND … MATCH (n {id: x}) این کار را نمیکرد. تغییر به روش اول، سرعت بررسیها را در محیطهای با ۱۰۰۰ سرویس، ۳.۶ برابر افزایش داد. توسعهدهنده همچنین اشاره کرد که نتایج بهصورت پیشفرض در RESULTSET_SIZE (۱۰,۰۰۰ ردیف) محدود میشوند بدون اینکه هشداری داده شود، که این امر مستلزم تعیین محدودیتهای صریح در کوئریهایی است که «همه چیز» را برمیگردانند.
این تجربه فرضیه «برتری مطلق گراف برای عاملهای AI» را به چالش میکشد. دادهها نشان میدهند گراف تنها زمانی ارزشمند است که پاسخ به ترکیب ساختار با زمینهی عملیاتی — بهویژه فراخوانیها، تغییرات، استقرار و زمان — وابسته باشد. اگر روابط را حذف کنید، همان سیگنالها سرویس اشتباهی را مقصر میکنند.
برای مهندسی که ساعت ۳ صبح بیدار شده، ارزشمندترین بخش، نه حکم نهایی AI، بلکه «مسیر استدلال» است. با مجبور کردن عامل به نمایش مسیرهای گرافی، سیستم از حالت «به من اعتماد کن» به «من را چک کن» تغییر وضعیت میدهد.
توسعهدهندگان علاقهمند میتوانند بنچمارکهای کامل و نتایج خام را در مخزن گیتهاب پروژه بررسی کنند.
گام بعدی شما
- اگر از معماری میکروسرویس استفاده میکنید، بررسی کنید که آیا تلهمتری شما قابلیت تبدیل به گراف (مثلاً با OpenTelemetry) را دارد یا خیر.
- برای کاهش توهم در عاملهای خود، دسترسی مستقیم به DB را حذف کرده و از ابزارهای پارامتریک (Tool Use) استفاده کنید.
- در صورت استفاده از پایگاهدادههای گرافی، محدودیتهای
RESULTSET_SIZEرا در کوئریهای حجیم لحاظ کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو