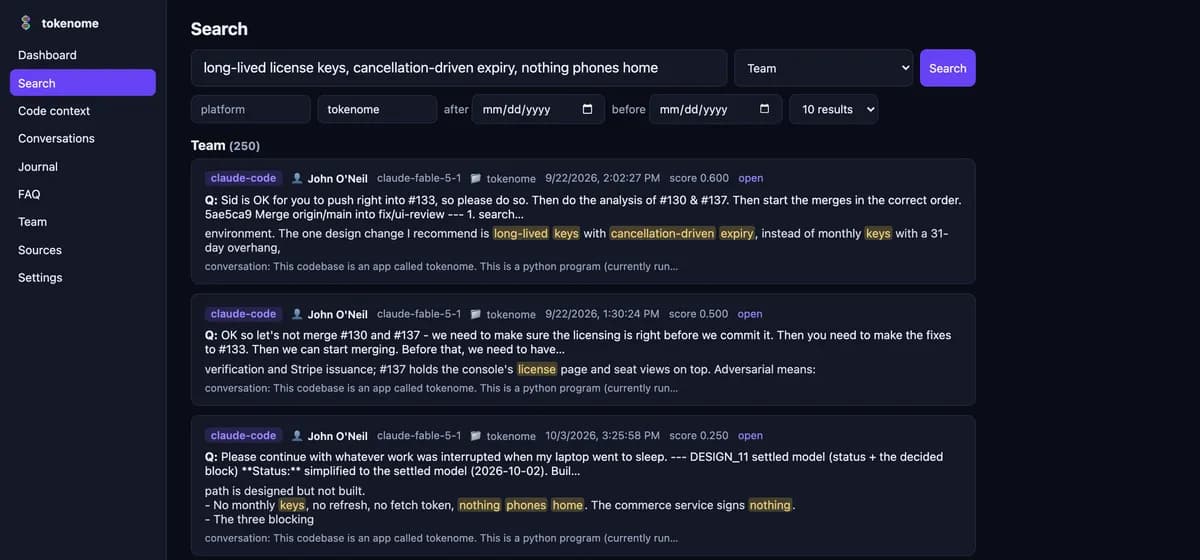
تصور کنید یک تصمیم معماری حیاتی — مثلاً جایگزینی کلیدهای لایسنس ماهانه با کلیدهای بلندمدت که منقضی شدن آنها وابسته به لغو اشتراک است — فقط در یک جلسه چت با Claude Code در لپتاپ یکی از بنیانگذاران ثبت شده باشد. این تصمیم که در یک سهشنبه شلوغ، همزمان با بررسی دو درخواست تغییر کد (Pull Request) نامرتبط گرفته شد، با هدف کاهش نارضایتی مشتریان بدون افزایش ریسک دزدی نرمافزاری اتخاذ شد، اما هرگز در هیچ سندی نوشته نشد. این تصمیم برای سه هفته برای بقیه تیم نامرئی ماند تا اینکه سرانجام یک ابزار جستوجوی تخصصی توانست آن را بازیابی کند.
این سناریو بحرانی را در مهندسی نرمافزار با کمک هوش مصنوعی نشان میدهد: «چرایی» یک محصول اکنون بهجای مستندات مشترک، در لاگهای پراکنده چتها زندگی میکند. استدلالها در دستگاههای مختلف، با فرمتهای متفاوت و در حسابهای شخصی پخش شدهاند. یک نیروی جدید نمیتواند بفهمد چرا منطق تکرار (retry logic) به این شکل نوشته شده و عاملهای هوش مصنوعی در جلسات جدید، نتایجی را با هزینه کامل دوباره استخراج میکنند که پیشتر توسط یک انسان به دست آمده است.
همانطور که در تحلیل قبلی ما دربارهی نحوه استفاده توسعهدهندگان از پروتکل زمینهٔ مدل (MCP) برای گسترش قابلیتهای هوش مصنوعی اشاره کردیم، Tokenome بهعنوان راهکاری برای این «فراموشی سازمانی» معرفی شده است. این ابزار گفتگوهای زودگذر هوش مصنوعی را به یک پایگاه دانش محلی، دائمی و قابل جستوجو تبدیل میکند.
بحران استدلالهای پراکنده
بسیاری از توسعههای مدرن درون عاملهای هوش مصنوعی رخ میدهند. وقتی برنامهنویسی از Claude Code یا ChatGPT برای پیادهسازی یک ویژگی استفاده میکند، استدلالها — یعنی بررسی مزایا و معایب و معماریهای رد شده — در همان جلسه محبوس میماند.
سیستم Git به برنامهنویس میگوید «چه چیزی» تغییر کرده است، اما بهندرت توضیح میدهد که «چرا». یک پیام کامیت ممکن است بگوید «بازگشت به جستوجوی مستقیم حساب»، اما ثبت نمیکند که در لحظه تصمیمگیری، برنامهنویس متوجه شد که کش (cache) ممکن بود دادههای قدیمی (stale) را برگرداند و باعث انتقال اشتباه پول شود، و در نتیجه متوجه شد که بهبود سرعت (latency win) ارزش این ریسک را ندارد. این جمله در لحظه حقیقت توسط انسان تایپ شده، اما در مخزن کد (repo) نیست. این چالش در مدیریت خروجیهای هوش مصنوعی مشابه وضعیتی است که در آن سیستم پینینگ MonkeyCode برای جلوگیری از تبدیل خروجیهای عاملها به افسانههای سازمان طراحی شده است تا حقیقت استدلالها حفظ شود.
مکانیزم ثبت تاریخچه در Tokenome
Tokenome برای پر کردن این شکاف، چهار منبع اصلی تعامل با هوش مصنوعی را ایندکس میکند که هر کدام به روش متفاوتی وارد سیستم میشوند:
- Claude Code: بهطور خودکار از مسیر
~/.claude/projectsخوانده میشود. اگر پلاگین Claude Code نصب باشد، یک قلاب (hook) در پایان هر جلسه، متن گفتگو را ایندکس میکند تا کارهای امروز، فردا قابل جستوجو باشند. - Claude Desktop & Cowork: از طریق API سایت claude.ai و با استفاده از یک کلید جلسه شخصی استخراج میشود. این تنها منبعی است که برای دسترسی به حساب کاربر، یک فراخوانی شبکه (network call) انجام میدهد.
- ChatGPT: با وارد کردن فایلهای خروجی
conversations.jsonدر پوشههای مخصوص وارد میشود. - Gemini: از طریق خروجیهای JSON ساده که در پوشههای واردات قرار میگیرند، ثبت میشود.
رشتههای گفتگو به اسناد پرسش و پاسخ تقسیم شده و هر کدام با برچسب زمان، پروژه، پلتفرم و مدل ثبت میشوند. نکته کلیدی این است که ابزار، «اکشنهای ابزاری» (tool actions) — یعنی ویرایشهای واقعی روی کد — را ثبت میکند؛ زیرا استدلال واقعی اغلب در خودِ ویرایش نهفته است. برای بهینهسازی، فقط نوبتهای (turns) جدید یا تغییر یافته بردار معنایی (Embedding) میشوند؛ به این معنا که یک جلسه فعال در هر بار بررسی، تقریباً به اندازه یک نوبت گفتگو هزینه پردازشی دارد.
جزئیات فنی پیادهسازی
طبق مستندات این ابزار، Tokenome از یک خط لوله پنج مرحلهای شامل ثبت (capture)، تکهبندی (segment)، تبدیل به بردار (embed)، ایندکس (index) و سرویسدهی (serve) استفاده میکند:
- تبدیل به بردار: روی دستگاه کاربر و با استفاده از ONNX انجام میشود و نیازی به واحد پردازش گرافیکی (GPU) ندارد.
- ایندکسگذاری: توسط Typesense و با ترکیب روش BM25 و شباهت برداری (vector similarity) مدیریت میشود.
- سرویسدهی: از طریق CLI، یک رابط کاربری وب محلی و یک سرور MCP ارائه میشود.
- ذخیرهسازی: تمام دادهها در مسیر
~/.tokenomeذخیره میشوند، از جمله ایندکس، ژورنال، پوشههای Drop و توکن API محلی.
معماری محلیمحور (Local-First)
برای محافظت از دادههای حساس، Tokenome بهصورت ساختاری محلی است، نه فقط بر اساس سیاستهای حریم خصوصی. محیط اجرای پایتون، موتور جستوجو و مدل تبدیل به بردار همگی در فایل دانلودی گنجانده شدهاند. هیچ حساب کاربری، نیاز به ورود (sign-in) یا نیازی به دریافت داده در اولین اجرا وجود ندارد.
محاسبات بردارها روی سختافزار کاربر انجام میشود تا هیچ متنی برای تبدیل به بردار به جایی ارسال نشود. در نسخه رایگان، تنها فعالیت شبکه، بررسی بهروزرسانی اپلیکیشن در صفحه انتشار عمومی است که هیچ دادهای از گفتگوها را منتقل نمیکند. استثنائات تنها زمانی رخ میدهند که کاربر صراحتاً منبع Claude Desktop یا قابلیت «تیم» (که فقط پروژههای انتخاب شده را ارسال میکند) را فعال کند.
این طراحی حیاتی است زیرا لاگهای چت حساسترین متنی هستند که یک برنامهنویس مالک آن است. در حالی که یک مخزن کد توسط هر بازبینیکنندهای خوانده میشود، لاگهای چت ممکن است حاوی Stack Traceهایی با توکنهای فعال، نام مشتریان در حین دیباگ یا معماریهای رد شدهای باشند که برنامهنویس نمیخواهد کسی آنها را نقل کند. در همین راستا، برای کاهش ریسکهای امنیتی در تعامل با عاملها، استفاده از توکنهای کوتاهمدت برای جلوگیری از نشت اعتبارنامهها به عنوان یک استاندارد امنیتی توصیه میشود.
اتصال کد به گفتگو
یکی از کاربردیترین ویژگیها، امکان بازگشت از یک خط کد به گفتگویی است که منجر به آن شده است. با دستور tokenome context src/ledger.py 31 ابزار از git blame استفاده میکند تا بفهمد این خط آخرین بار چه زمانی و توسط چه کسی تغییر کرده است. اگر فایل در حال حاضر در دسترس نباشد، ابزار به اطلاعات blame که در زمان ایندکسگذاری ثبت شده بود، رجوع میکند.
سپس با استفاده از آن برچسب زمانی، گفتگوهای دقیقاً قبل از ویرایش را پیدا کرده و نام کامیتکننده، زمان، کد کامیت و متن گفتگوها را چاپ میکند.
- پنجره زمانی: فلگ
--window Nدقایق مورد بررسی را تغییر میدهد (پیشفرض ۳۰ دقیقه است). - تقارن: فلگ
--symmetricهر دو طرف ویرایش را بررسی میکند تا مواردی که ویرایش مدتی بعد از گفتگو انجام شده، پیدا شوند.
این قابلیت برای «برگشتها» (reversals) — خطوطی که قبلاً چیز دیگری بودهاند — بیشترین ارزش را دارد؛ جایی که شکاف میان «چه چیزی» و «چرا» در بیشترین حد خود است. یک نتیجه موفق، یک کامیت واقعی، حداقل یک گفتگو در پنجره زمانی و دلیلی را ارائه میدهد که بیشتر شبیه به یک «تصمیم» است تا یک «گزارش وضعیت».
حافظه عاملمحور از طریق MCP
Tokenome یک سرور MCP را در آدرس http://127.0.0.1:8741/mcp اجرا میکند. این به یک عامل (Agent) اجازه میدهد بهجای اینکه کاربر متن را دستی کپی کند، تاریخچه خودش را جستوجو کند. برای کلاینتهایی که به stdio نیاز دارند، دستور tokenome mcp به عنوان پروکسی عمل میکند.
در Claude Code، این ابزار از طریق شل یا مارکتپلیس با دستور claude plugin marketplace add tokenome/releases اضافه میشود. این پلاگین یک «مهارت» (skill) به عامل اضافه میکند تا بداند از کدام ابزار استفاده کند، یک قلاب (prompt hook) برای ترغیب عامل به بررسی تاریخچه در پرسشهای بازنگرانه، و دستوراتی مانند /tokenome:why و /tokenome:search را فراهم میکند.
عاملها اکنون به مجموعهای از ابزارها دسترسی دارند:
why_was: دلیل ذکر شده برای یک تصمیم را همراه با نقلقولی که آن را ثابت میکند، برمیگرداند و بهجای جستوجوی ساده کلمات، به دنبال «دلایل» در ژورنال میگردد.ask_faq: پرسشهای تکراری «چرا» را از FAQ جاری همراه با شواهد و تاریخچه پاسخها استخراج میکند.search_memory: نقطه ورود کلی برای تصمیمات گذشته، آنچه امتحان شده و اینکه چه کسی با چه چیزی موافقت کرده است.get_journal: لیست کارهای انجام شده در یک روز خاص و دلیل آنها را با نقلقولهای مستند ارائه میدهد.get_conversation: یک رشته گفتگو را نوبتبهنوبت، همانطور که پیش رفته است، بازیابی میکند.get_document: یک نوبت گفتگو را با جزئیات و کلمات دقیق ارائه میدهد.find_related: موارد دیگری را که در آن یک موضوع مطرح شده است، بر اساس یک نتیجه موجود پیدا میکند.find_conversations_near: یک کامیت یا برچسب زمانی blame را به بحثهای پیرامونش لینک میکند.browse_by_label: نتایج را بر اساس مدل یا ابزار مورد استفاده فیلتر میکند.get_recent: جدیدترین کارهای انجام شده در تمام ابزارها را نشان میدهد.
ابزار why_was بهطور خاص حس جلسه را تغییر میدهد؛ زیرا هم تصمیم و هم هرگونه بازگشت بعدی را برمیگرداند و مانع از آن میشود که عامل با اطمینان، راهکاری را پیشنهاد کند که کاربر قبلاً امتحان کرده و رد نموده است.
کمیسازی بهرهوری
در یک ارزیابی کنترلشده روی ۴۰ جلسه (۱۰ پرسش که به ۴ روش مختلف روی یک مجموعه داده پرسیده شدند)، پیکربندی مسیریابی Tokenome دستاوردهای قابلتوجهی داشت. این سیستم توانست به پرسشها درباره کارهای گذشته، با استفاده از ۳۸٪ توکنهای زمینه کمتر نسبت به حالت پایه پاسخ دهد، بدون آنکه کیفیت پاسخها تغییر کند.
باید بین توکنهای زمینه و هزینه واقعی تفاوت قائل شد: هزینه دلاری ۲۲٪ کاهش یافت زیرا بازخوانی زمینه کششده ارزان است. این بهرهوری از پاسخهای کوتاهتر ناشی نشد — یک جستوجوی ایندکس حدود ۳۰۰۰ توکن برمیگرداند در حالی که grep حدود ۱۰۰۰ توکن برمیگرداند — بلکه از کاهش عملیاتها حاصل شد. تعداد نوبتهای (turns) عامل از ۲۵۲ به ۱۶۱ و عملیاتهای سیستم فایل از ۲۴۱ به ۱۳۶ کاهش یافت.
مقیاسپذیری برای تیمها
برای محیطهای مشارکتی، Tokenome یک سرور تیمی خودمیزبانیشده از طریق یک ایمیج کانتینر (ghcr.io/tokenome/tokenome-server) ارائه میدهد. بسته compose نسخه را تثبیت کرده و ایندکس، سرور و TLS خودکار را مدیریت میکند.
عملکرد تیمی به این صورت است:
- ثبتنام: برای هر دستگاه جداگانه است. دستور
tokenome remote enrollیک جفت کلید محلی تولید کرده و فقط نیمه عمومی را ارسال میکند. توکنهای ثبتنام پس از ۷۲ ساعت منقضی میشوند. - اشتراکگذاری: بهصورت اختیاری و برای هر پروژه جداگانه است (
tokenome remote share <project> --backfill). هیچ پیشفرضی برای «اشتراکگذاری همه چیز» وجود ندارد. - پاکسازی (Redaction): قبل از ارسال، روی لپتاپ کاربر انجام میشود. یک دروازه اشتراکگذاری (share gate)، اسرار و دادههای شخصی را بر اساس یک دیکشنری نامها که توسط کاربر مدیریت میشود، جایگزین میکند. مواردی که نمیتوان آنها را ایمن کرد، برای تایید دستی یا حذف نگه داشته میشوند.
- شفافیت: هر نتیجه نام مشارکتکننده را دارد و لاگهای بازرسی فقط افزایشی (append-only)، قابل فیلتر و قابل خروجی گرفتن هستند. ردیفهای جستوجو فقط هشها، دستهها و نام فیلترها را نگه میدارند و هرگز متن پرسوجو را ذخیره نمیکنند.
- پس گرفتن: دستور
tokenome remote unshare <project>اشتراکگذاری را متوقف میکند و فلگ--purgeدادههای ارسال شده قبلی را حذف میکند.
سرور، متنها و بردارها را بهصورت باز (in the clear) نگه میدارد تا جستوجو ممکن باشد؛ بنابراین حفاظت از دادهها سازمانی (درون مرز کاربر) است، نه رمزنگاریشده.
محدودیتهای شناختهشده
Tokenome یک راهکار جادویی نیست. این ابزار به یک مخزن git و یک خط ثبتشده برای اثبات منشأ نیاز دارد؛ خطوط ثبتنشده (uncommitted) به نسخه Working Copy ارجاع داده میشوند و فاقد برچسب زمانی برای جستوجو هستند. همچنین نمیتواند کارهای قبل از نصب یا در ابزارهای پشتیبانینشده را بازیابی کند، مگر اینکه یک فایل خروجی (export) ارائه شود.
علاوه بر این، ابزار علیت (causality) را اثبات نمیکند؛ یعنی اگر دو موضوع در یک بازه ۳۰ دقیقهای بحث شده باشند، هر دو ظاهر میشوند و کاربر باید تصمیم بگیرد آیا یکی باعث دیگری شده است یا خیر. همچنین نتایج را خلاصه نمیکند تا جزئیات حیاتی مثل IDها یا نام مدلها از بین نرود. خطی که هرگز دربارهاش بحث نشده، هیچ نتیجهای برنمیگرداند، که این یک پاسخ صادقانه است و نشان میدهد تصمیم در قالب نوشتاری گرفته نشده است.
در مورد ارزیابیها، نتایج متغیر بود (از ۸۷-٪ تا ۱۰۹+٪ در هر پرسوجو). پرسشهای کلی مثل «به چه نتیجهای رسیدیم» از این سیستم سود میبرند، اما پرسشهای محدود با فایل مشخص، تفاوت چندانی ندارند. همچنین، ایندکس مشکل «نادیده گرفتن حقایق» توسط عاملها را حل نمیکند؛ در تستها، تقریباً نیمی از حقایق از دست رفته در واقع در نتایج ابزار بودند اما عامل آنها را نادیده گرفت.
در نهایت، نسخه بومی برای ویندوز وجود ندارد. هرچند WSL2 نسخه لینوکس را اجرا میکند، اما ثبت دادهها از ابزارهای سمت ویندوز تست نشده است. ویژگیهایی مانند بات اثبات PR و FAQ تیمی در نقشه راه هستند اما هنوز ساخته نشدهاند.
تحلیل: تغییر به سمت «اثبات استدلال»
Tokenome نشاندهنده تغییری در تجربه توسعهدهنده از «مهندسی پرامپت» به «مدیریت حافظه» است. هرچه عاملهای هوش مصنوعی بخش بیشتری از کد ما را بنویسند، بدهی فنی اصلی نه خودِ کد، بلکه از دست دادن استدلالی خواهد بود که آن کد را خلق کرده است.
با تبدیل لاگهای چت به شهروند درجه اول کدبیس، توسعهدهندگان میتوانند از «حلقه استخراج مجدد» (re-derivation loop) جلوگیری کنند؛ جایی که یک عامل توکنهای گرانقیمت را صرف رسیدن به نتیجهای میکند که انسان سه هفته پیش به آن رسیده بود. این کار تاریخچه هوش مصنوعی را از یک ریسک (دادههای حساس در ابر) به یک دارایی (اثبات محلی و قابل جستوجو) تبدیل میکند.
برای شروع ردیابی استدلالهای هوش مصنوعی، میتوانید CLI را از طریق uv tool install tokenome-ai نصب کنید. اپلیکیشن دسکتاپ بهعنوان یک DMG امضا شده برای Apple Silicon و AppImage یا deb برای لینوکس (x86_64 و aarch64) در صفحه انتشار عمومی در دسترس است. اپلیکیشن، CLI را از طریق تنظیمات نصب میکند و دستور tokenome app رابط کاربری وب محلی را در localhost:8741 باز میکند.



گفتگو