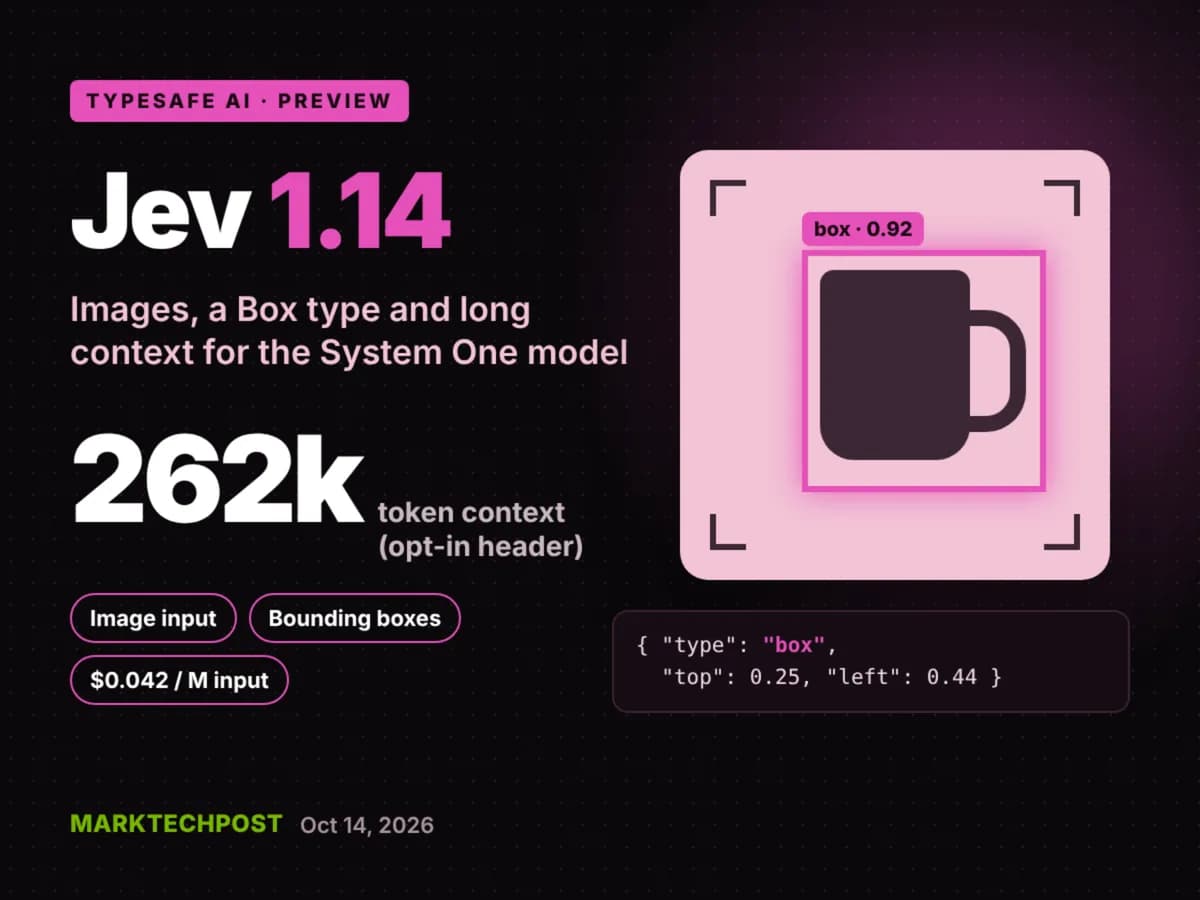
تصور کنید مدل تصمیمگیری شما بهجای توصیف متنی یک صحنه، مختصات دقیق اشیا را در قالب اعداد برگرداند. این تغییر رویکرد به سمت بینایی ماشین، با انتشار نسخه ۱.۱۴ مدل Jev در ۱۵ اکتبر ۲۰۲۶ توسط شرکت TypeSafe AI و معرفی نوع داده جدید Box محقق شده است.
در حالی که اکثر مدلهای زبانی بزرگ (LLM) بینایی را یک وظیفه توصیفی میبینند، Jev به عنوان یک مدل «سیستم یک» عمل میکند. طبق مستندات این شرکت، مدل Jev تصمیمات تایپشدهای مانند Choice، Score یا Noul را همراه با امتیاز اطمینان و احتمالات برمیگرداند. این معماری برای کارهای با قابلیت اطمینان بالا مانند بازرسی صنعتی و مکانیابی طراحی شده است، جایی که پاسخهای متنی طولانی، مانعی برای اتوماسیون هستند. TypeSafe برای رسیدن به این دقت از یادگیری تقویتی برای تصمیمات کالیبره شده (RLCD) استفاده میکند.
بر اساس یادداشتهای انتشار, Jev 1.14 سه قابلیت در «منطقه خطر» (Danger Zone) معرفی کرده که هنوز برای محیط عملیاتی آماده نیستند. مهمترین آنها نوع داده Box است که چهار لبه (بالا، پایین، چپ، راست) را به صورت کسری بین ۰ تا ۱ برمیگرداند. در تستهای داخلی روی ۳۶ برش از نقاشیها، پرسشهای چهارگانه از نوع Noul توانستند ۳۰ مورد از ۳۶ هدف برشخورده را با موفقیت شناسایی کنند. برای مقایسه، پرسش تکمرحلهای «آیا همه در داخل هستند» تنها ۲۶ مورد و رسم باکس به صورت خط محیطی فقط ۲۰ مورد را شناسایی کرد.
همانطور که در تحلیلهای پیشین ما درباره مدلهای تصمیمگیرنده اشاره کردیم، حذف لایههای متنی زائد، سرعت استنتاج را در محیطهای صنعتی بهشدت افزایش میدهد. این رویکرد بهینهسازی در راستای استراتژی TypeSafe برای کاهش هزینههاست، همانطور که پیشتر بررسی کردیم که مدل Jev چگونه هزینههای عملیاتی عاملهای هوش مصنوعی را تا ۲۲ برابر کاهش میدهد. نسخه Jev 1.14 (jev-1.14.0) بهبودهای جزئی در اکثر بخشهای مدل ایجاد کرده است. به نقل از TypeSafe، بیشترین پیشرفتها در پشتیبانی از زبانهای مختلف رخ داده، هرچند هنوز امتیازات عددی عمومی برای این بخش منتشر نشده است.
تصاویر در این مدل به عنوان داراییهای ترکیبپذیر (Composable Assets) مدیریت میشوند. هر تصویر یک بار در نقشه داراییهای سطح بالا با یک رشته مرجع ثبت میشود. توسعهدهندگان این مرجع را در دستورالعملها یا معیارها قرار میدهند و API پیش از خواندن توسط مدل، مرجع را با تصویر جایگزین میکند. اگرچه Jev 1.14 بر این ابزارها تأکید دارد، اما شرکت اشاره کرده که نسخه ۱.۱۳.۰ نیز از ابتدا چندوجهی (Multimodal) بوده است.
مشخصات فنی و محدودیتهای این نسخه به شرح زیر است:
- پنجره زمینه (Context Window): محدودیت پیشفرض ۶۴ هزار توکن برای هر درخواست و ۳۲ هزار توکن برای هر پرسش است. با ارسال هدر
TypeSafe-Danger-Zone-Long-Context: trueمیتوان این حد به ۲۶۲ هزار توکن افزایش داد. - مدیریت تصویر: نیازمند هدر
TypeSafe-Danger-Zone-Images: trueاست. پشتیبانی از فایلهای PNG و JPEG تا ۱۶ مگابایت برای هر تصویر و مجموعاً ۳۲ مگابایت برای کل بدنه درخواست. ابعاد تصاویر باید بین ۲۵۶ تا ۱۵۶۸ پیکسل در هر ضلع باشد. - قیمتگذاری: هزینه ورودی ۴۲ دلار به ازای هر میلیارد توکن (۰.۰۴۲ دلار برای هر میلیون) است. توکنهای خروجی رایگان هستند و تصاویر با نرخ توکنهای ورودی محاسبه میشوند.
- استقرار: مدل از طریق API در مسیر
POST /v1/systemoneبا نام مستعارjev-previewدر دسترس است. هیچ وزن باز (Open Weights) یا نسخه کوانتیده منتشر نشده است.
شرکت TypeSafe AI هشدار داده است که عملکرد مدل روی تصاویر ضعیفتر از متن خالص است و توصیه میکند برای وظایف بینایی از سادهترین پرسشهای ممکن استفاده شود. علاوه بر این، نوع داده Box در حال حاضر پاسخ «یافت نشد» ندارد و همیشه یک باکس برمیگرداند، حتی اگر شیء وجود نداشته باشد. برای حل این مشکل، توسعهدهندگان باید پرسشهای Box را با یک پرسش مجزای Noul برای تأیید وجود هدف ترکیب کنند.
از منظر فنی، این بهروزرسانی این فرض را تغییر میدهد که مدلهای تصمیمگیرنده محدود به دادههای دستهای یا عددی هستند. TypeSafe با ادغام مختصات نرمالشده مستقیماً در سیستم تایپ، تلاش میکند شکاف بین طبقهبندی و مکانیابی را بدون سربار تجزیه JSON (که در مدلهایی مثل Gemini 3.5 Flash-Lite رایج است) پر کند.
با این حال، موازنه قابلیت اطمینان کاملاً شفاف است. TypeSafe اعتراف میکند که پنجره متنی ۲۶۲ هزار توکنی نسبت به حالت ۶۴ هزار توکنی کمتر قابل اعتماد است و قابلیتهای بینایی صرفاً آزمایشی هستند. تصمیم شرکت برای عدم انتشار بنچمارکهای عددی و تکیه بر نمودارهای داخلی که Jev را فقط با مدلهای وزنباز مقایسه میکند، نشان میدهد این قابلیتها در مرحله تکرار سریع هستند. شرکت صراحتاً هشدار داده که اندازهگیریهای داخلی آنها ممکن است سوگیرانه باشد و توسعهدهندگان را به ارزیابیهای شخصی ترغیب کرده است.
توسعهدهندگان اکنون میتوانند از طریق jev-preview به این نسخه دسترسی داشته باشند و پیشبینی میشود jev-latest ظرف یک هفته به نسخه ۱.۱۴.۰ منتقل شود. باید مستندات TypeSafe را برای حذف نسخه ۱.۱۳.۰ (که پس از ۶۰ روز اعلان رخ میدهد) رصد کنید.
گام بعدی شما
- اگر از مدلهای بینایی برای اتوماسیون صنعتی استفاده میکنید، ترکیب پرسشهای Box و Noul را برای جلوگیری از توهمات مکانیابی تست کنید.
- برای پروژههایی با متون حجیم، هدر Long-Context را فعال کنید اما حتماً نرخ خطای مدل را در مقایسه با حالت ۶۴ هزار توکنی بسنجید.
- مهاجرت به نسخه ۱.۱۴.۰ را در تقویم توسعه خود برای هفته آینده برنامهریزی کنید.
اما چالش اصلی در این مسیر، مدیریت هزینههای استنتاج در مقیاسهای بزرگ است — به تحلیل ما درباره بهینهسازی توکنها در مدلهای تصمیمگیرنده مراجعه کنید.



گفتگو