تصور کنید ۶ ماه وقت و ۵۰ هزار دلار بودجه را صرف ساخت موتور سفارشی کنید، در حالی که یک موتور استاندارد با نقشهای بهتر، شما را سریعتر به مقصد میرساند. این دقیقاً همان اتفاقی است که برای تیمی افتاد که به جای بهینهسازی ورودیها، به سراغ پیچیدهترین ابزار موجود رفت. این شکست نشاندهنده یک مشکل سیستماتیک در چارچوب تصمیمگیری برای پیادهسازی هوش مصنوعی است؛ جایی که اکثر تیمها به جای انتخاب مؤثرترین ابزار، ابزاری را انتخاب میکنند که «حرفهایتر» و پیچیدهتر به نظر میرسد.
به گزارش dev.to در ۱۷ اکتبر ۲۰۲۶، یک تیم فنی بودجهای ۵۰ هزار دلاری را صرف خط لوله تنظیم دقیق (Fine-tuning) — شبیه وقتی به یک پزشک عمومی، تخصص پوست میدهیم تا روی یک حوزه دقیق شود — کرد، اما در نهایت متوجه شد که یک مدل پایه با پرامپتنویسی درست، با هزینه ماهانه ۲۰۰ دلار همان نتیجه را میدهد.
داستان مارکوس را در نظر بگیرید؛ او نیمی از سال را صرف تنظیم دقیق مدلی برای پشتیبانی مشتریان کرد. وقتی در نهایت مدل را منتشر کرد، خروجیها از نظر گرامری بینقص و صیقلخورده بودند، اما از نظر محتوایی غلط بودند. دلیلش ساده بود: تاریخ قطع دانش (Knowledge Cutoff) مدل، سه ماه قبل از آخرین تغییرات محصول بود که مشتریان درباره آنها سؤال میپرسیدند. او ابزار اشتباهی را برای مسئلهای انتخاب کرده بود چون هیچکس در ابتدا سؤال طبقهبندی سادهای نپرسیده بود تا بفهمد مشکل از کجاست.
همانطور که در تحلیل قبلی ما دربارهی جایگاه مهندسی پرامپت اشاره کردیم، نادیده گرفتن این مهارت به عنوان یک «راهکار موقت» یا مهارتی در سطح پایین، یک خطای استراتژیک است. در دنیای سازمانی، فاصله بین یک انتخاب «تولیدی-حرفهای» و یک پرامپت «ساده»، اغلب فقط اتلاف بودجه است. تصور کنید ماهها وقت صرف ساخت یک موتور سفارشی کنید، در حالی که یک موتور استاندارد با یک نقشه بهتر، شما را سریعتر به مقصد میرساند.
کالبدشکافی شکست ۵۰ هزار دلاری
هزینه این پروژه شکستخورده فقط ساعتهای پردازشی GPU نبود، بلکه هزینه یک تصمیم غلط در کل چرخه حیات محصول بود. مهندسان درگیر در این پروژه بیکفایت نبودند؛ آنها صرفاً پیش از آنکه مسئله را بهطور کامل درک کنند، تصمیمی در مورد تکنیک پیادهسازی گرفتند. طبق تحلیل dev.to، جزئیات هزینهها به این شکل توزیع شده بود:
- بررسی محدوده و ممیزی دادهها: ۴,۲۰۰ دلار در دو هفته؛ پیمانکار قبل از تست هرگونه جایگزین، تنظیم دقیق را به عنوان تنها راه «درست» معرفی و تعریف کرد.
- آمادهسازی دادههای آموزش: ۸,۵۰۰ دلار برای استخراج جفتهای پرسش و پاسخ، پاکسازی و قالببندی تقریباً ۲,۰۰۰ نمونه.
- اجرای آموزش روی GPU: ۶,۸۰۰ دلار برای چهار تکرار؛ این مبلغ شامل ساعتهای GPU ابری و اجراهای شکستخورده بود، جایی که هر ارزیابی نیاز به یک آموزش مجدد کامل داشت.
- ارزیابی و تکرار: ۹,۰۰۰ دلار بدون داشتن یک مجموعه ارزیابی ثابت که از ابتدا تعریف شده باشد؛ این یعنی تعریف «خروجی خوب» در هر دور از تکرار تغییر میکرد.
- استقرار و یکپارچهسازی: ۷,۵۰۰ دلار برای میزبانی، زیرساخت نقاط انتهایی (Endpoints) و عرضه مدل؛ مدلی که حتی قبل از انتشار، منسوخ شده بود.
- هزینه فرصت: ۱۴,۰۰۰ دلار بابت ساعتهای مهندسی که برای سه ماه از نقشه راه اصلی محصول منحرف شد.
در مجموع، این تلاش حدود ۵۰,۰۰۰ دلار هزینه داشت. این رقم در مقابل یک مدل پیشرو (Frontier Model) مقایسه شد که در آن مستندات صرفاً در پنجره متنی (Context Window) قرار گرفته بودند و هزینه آن تقریباً ۲۰۰ دلار در ماه بود. نکته تلخ این بود که تا زمان انجام این مقایسه، مستندات در طول فرآیند آموزش دو بار بهروز شده بودند و مدل تنظیمشده در لحظه تولد، کاملاً قدیمی و منسوخ بود.
سلسلهمراتب انتخاب تکنیک
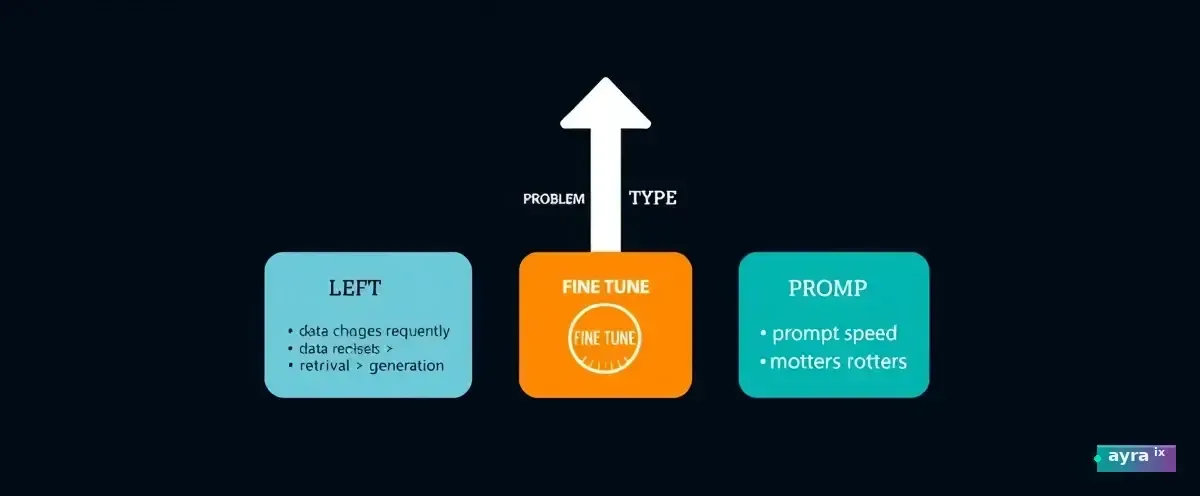
این گزارش یک ترتیب عملیاتی سختگیرانه را پیشنهاد میکند: مهندسی پرامپت $ \rightarrow $ تولید بازیابیافزا (RAG) $ \rightarrow $ تنظیم دقیق. این یک سلسلهمراتب کیفی نیست، بلکه سلسلهمراتب هزینه و انعطافپذیری است. هدف این است که ابتدا ارزانترین گزینهها را رد کنیم و اکثر مسائل در همان گام اول حل میشوند.
مهندسی پرامپت (Prompt Engineering) — هنر سؤال درست پرسیدن، مثل کسی که میداند چطور از یک مشاور باتجربه بهترین جواب را بگیرد — خط پایه است. این روش هزینه زیرساختی صفر و زمان آموزش صفر دارد و فقط هزینه توکنهای استنتاج (Inference) را میطلبد. این باید اولین تلاش برای هر مورد کاربردی باشد تا زمانی که واقعاً شکست بخورد. نقص مرگبار این است که اغلب خیلی زود به عنوان یک «پرامپت سیستمی تکخطی» نادیده گرفته میشود، در حالی که باید یک فرآیند دقیق باشد.
تولید بازیابیافزا (RAG) — مثل دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — برای دانشهای متغیر و بهروز است. هزینه آن معمولاً ۵۰ تا ۵۰۰ دلار در ماه برای پایگاهداده برداری و Embeddingها است، با یک تأخیر (Latency) اضافی بین ۵۰ تا ۲۰۰ میلیثانیه. اگر دادههای شما ماهانه تغییر میکنند (مثل مستندات محصول، بهروزرسانیهای قانونی یا پایگاههای دانش داخلی)، RAG تنها راه عملی است. تنظیم دقیق یک مدل روی دادههای پویا، مدلی میسازد که به محض تغییر دامنه، «منسوخ» میشود.
تنظیم دقیق (Fine-Tuning) آخرین راهکار است. این روش شامل آموزش نظارتشده مدل با هزینههایی بین ۵,۰۰۰ تا بیش از ۵۰,۰۰۰ دلار برای هر دور آموزش است. مزیت آن حذف هزینههای بازیابی در زمان استنتاج است. این روش تنها زمانی هزینهاش را توجیه میکند که سه شرط همزمان برقرار باشند: حجم استنتاج بسیار بالا (بیش از ۵۰ هزار درخواست در روز)، یک دامنه واقعاً پایدار و بدون تغییر، و نیاز به استنتاج آفلاین. اگر هر یک از اینها نادرست باشد، بازگشت سرمایه (ROI) معمولاً فرو میپاشد. برای درک بهتر ترکیب این دو رویکرد، میتوانید معماری ترکیبی برای افزایش دقت پاسخهای سازمانی را بررسی کنید که نشان میدهد چگونه تعادل بین RAG و تنظیم دقیق میتواند نتایج را بهبود بخشد.
ماتریس تصمیمگیری: انتخاب مسیر درست
برای جلوگیری از اشتباهات مالی ۴۰ هزار دلاری، تیمها باید از یک ماتریس تصمیمگیری بر اساس محدودیتهای خود استفاده کنند:
- بهروزرسانی ماهانه دانش: از RAG استفاده کنید. باز-بردارسازی تکهها سریع و ارزان است، اما آموزش مجدد نیست. انتخاب تنظیم دقیق در اینجا یعنی پرداخت هزینه برای حفظ دادههایی که تا ۳۰ روز دیگر غلط خواهند بود.
- فرمت خروجی ثابت در حجم بالا (بیش از ۵۰ هزار درخواست در روز): از تنظیم دقیق استفاده کنید. این کار باعث میشود طرح (Schema) در وزنهای مدل تثبیت شود و هزینهی توکنهای Few-shot در هر درخواست حذف شود که در مقیاس بالا باعث صرفهجویی میشود.
- نمونهسازی و اکتشاف: از مهندسی پرامپت استفاده کنید. هیچ تعهدی به زیرساخت نیست و تکرار سریع است. متعهد شدن به یک تکنیک قبل از شناخت نیازها، علت اصلی اتلاف بودجه است.
- دادههای حساس و خصوصی: ترکیب RAG و مدل محلی را انتخاب کنید. این به شما اجازه میدهد دادهها را بهصورت خصوصی بردارسازی کرده و در محیط داخلی (On-prem) تولید کنید. APIهای تنظیم دقیق ابری اغلب دادههای آموزشی را به خط لولههای شخص ثالث میفرستند، حتی با وجود قراردادهای سازمانی.
- بودجه زیر ۱ هزار دلار: فقط مهندسی پرامپت. تنظیم دقیق غیرممکن است و حتی RAG حداقلی هم هزینه زیرساختی اضافه میکند. ابتدا تمام ارزش ممکن را از پرامپت سیستمی استخراج کنید.
سیگنالهای هشدار در زمینه تصمیمگیری
هنگام انتخاب تکنیک، برخی سیگنالها باید باعث تغییر مسیر فوری شوند. اگر یک فروشنده یا پیمانکار، تنظیم دقیق را به عنوان تنها راه پیشنهاد میکند بدون اینکه درباره چرخه بهروزرسانی دادههای شما بپرسد، این یک «فروش» است، نه یک «مشاوره».
به همین ترتیب، اگر تنظیم دقیق را برای «دقت بیشتر» روی دادههایی انتخاب میکنید که مرتباً تغییر میکنند، در واقع دارید هزینه میکنید تا اطلاعاتی را حفظ کنید که تا ۳۰ روز دیگر غلط خواهند بود. هزینه واقعی تنظیم دقیق، هزینه اجرای آموزش نیست، بلکه هزینه چرخه بهروزرسانی است: آمادهسازی دادهها، آموزش، ارزیابی و استقرار در هر بار تغییر دامنه.
چرا RAG بهصورت خام شکست میخورد؟
اگرچه RAG استاندارد فعلی صنعت است، اما دچار یک حالت «شکست خاموش» میشود. خط لوله ممکن است بدون هیچ خطایی اجرا شود، تأخیر در سطح مناسب باشد و معیارها نشان دهند که «بازیابی در حال کار است»، اما پاسخ همچنان غلط است چون بازیابیکننده، تکههای (Chunks) اشتباهی را استخراج کرده است.
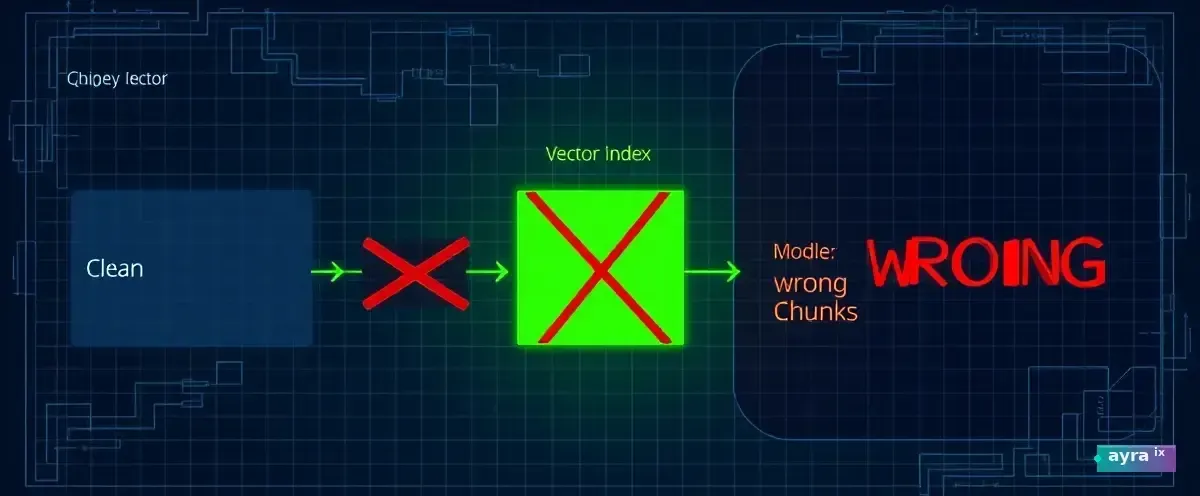
این اتفاق میافتد چون شباهت برداری (Vector Similarity) همیشه به معنای ارتباط معنایی (Semantic Relevance) نیست. برای مثال، پرسشی درباره «زمان بازگشت وجه برای سفارشات بینالمللی» ممکن است تکهای از «سیاست کلی بازگشت وجه» را بازیابی کند چون هر دو حاوی کلمه «بازگشت وجه» هستند. چون مدل در استدلال عالی است، با اعتمادبهنفس کامل، بر اساس متن غلط، یک توهم (Hallucination) تولید میکند. در واقع، سیستم به یک «ماشین توهمِ مطمئن» تبدیل میشود. این چالشها در تحلیل ۳ نقطه شکست در RAG بهطور مفصل بررسی شدهاند تا تیمهای سازمانی از تکرار این خطاهای رایج اجتناب کنند.
راهکارهای فنی برای اصلاح بازیابی
برای حل این مشکل، نویسنده چندین تغییر فنی را پیشنهاد میکند تا اطمینان حاصل شود که زمینه (Context) قبل از رسیدن به مدل، واقعاً درست است:
- جستوجوی ترکیبی (Hybrid Search): ترکیب جستوجوی کلمات کلیدی (Keyword Search) با جستوجوی معنایی. این برای دامنههایی با اصطلاحات دقیق، شماره مدلها، کدهای سیاست یا نام APIها که جستوجوی معنایی خالص اغلب آنها را نادیده میگیرد، ضروری است. هر دو را اجرا کرده و نتایج را ادغام کنید.
- ثبت تکهها (Chunk Logging): ارزیابی کیفیت بازیابی بهطور مستقل از کیفیت پاسخ نهایی. با ثبت اینکه برای هر پرسش دقیقاً چه تکههایی بازیابی شدهاند، میتوانید بفهمید آیا خط لوله روی زمینه غلط اعتماد دارد یا خیر. این یک اصلاح کلیدی در سیستم حافظه نویسنده با پشتیبانی Qdrant برای حذف مثبتهای کاذب بود.
- همراستایی بردارها (Embedding Alignment): اطمینان از اینکه بردارهای پرسش و بردارهای سند از توزیعهای آموزشی مشابهی میآیند. عدم تطابق باعث شکستهای «نزدیک به هدف» در بازیابی میشود که تشخیص آنها سخت است چون شباهت کسینوسی (Cosine Similarity) منطقی به نظر میرسد، اما محتوا کمی غلط است.
- بهینهسازی اندازه تکهها: تست تکههای کوچک (برای حقایق دقیق) و تکههای بزرگ (برای درک زمینه). تکههای کوچکتر حقایق دقیق را بیرون میکشند اما زمینه را از دست میدهند؛ تکههای بزرگتر زمینه را حفظ میکنند اما سیگنال برداری را رقیق میکنند.
ساخت پرامپت سیستمی در سطح تولید
بسیاری از تیمها در مهندسی پرامپت شکست میخورند چون از جایگاههای سادهای مثل «تو یک دستیار مفید هستی» استفاده میکنند. یک پرامپت سیستمی (System Prompt) حرفهای به چهار جزء خاص نیاز دارد:
۱. نقش با محدودیتهای دامنه: تعریف دقیق اینکه هوش مصنوعی کیست، چه چیزاتی را باید رد کند و مرزها را چگونه مدیریت کند (مثلاً: «تو یک X هستی که فقط Y را مدیریت میکند، Z را رد میکند و همیشه W را انجام میدهد»). بدون محدودیت، مدلها به حوزههای مجاور منحرف میشوند.
۲. قوانین دامنه: کدگذاری اصطلاحات و موارد خاص (Edge Cases) در پرامپت. پرامپت را با حقایقی که مدل از قبل میداند پر نکنید؛ حقایق متعلق به RAG هستند و قوانین متعلق به پرامپت سیستمی.
۳. طرح دقیق خروجی (Schema): ارائه یک مثال تکمیلشده از JSON یا فرمت مورد نیاز. تفاوت در ثبات بین دستور «به صورت JSON پاسخ بده» و «دقیقاً در این فرمت JSON پاسخ بده: [مثال]» بسیار زیاد است.
۴. مدیریت صریح شکست: دستور به مدل که وقتی اطلاعات در زمینه موجود نیست، صراحتاً اعلام کند (مثلاً: «اگر اطلاعات لازم برای پاسخ به این سؤال در زمینه ارائه شده نیست، این را بیان کن و توضیح بده چه چیزی کم است»).
استک RAG محلی و کمهزینه
برای کسانی که از هزینههای ابری و پیچیدگیهای چارچوبها گریزانند، نویسنده یک استک سبک و مستقیم مبتنی بر HTTP را توصیه میکند. این کار باعث میشود از لایههای انتزاعی ابزارهایی مثل LangChain که میتوانند حالتهای شکست جدیدی را قبل از حل مشکل بازیابی اضافه کنند، دوری کنید.
- ذخیرهساز برداری: Qdrant که روی یک سرور خانگی برای مجموعههای پایگاه دانش اجرا میشود.
- بردارساز: nomic-embed-text از طریق Ollama. این مدل انتخاب شده چون روی مجموعه دادههای بزرگتر و متنوعتری آموزش دیده و زبانهای تخصصی دامنه را بهتر از all-MiniLM یا bge-small مدیریت میکند بدون اینکه نیاز به تنظیم دقیق داشته باشد. همچنین روی CPU سریع اجرا شده و ۵۰۰ تکه را در چند ثانیه بردارسازی میکند.
- تولیدکننده: qwen2.5-coder:14b از طریق Ollama برای پاسخهای مستند و دقیق.
گردش کار (Workflow):
پرسش $ \rightarrow $ nomic-embed-text (Ollama :11434) $ \rightarrow $ Qdrant (جستوجوی Cosine similarity, top-k=5) $ \rightarrow $ اسمبل کردن زمینه $ \rightarrow $ qwen2.5-coder:14b (Ollama :11434) $ \rightarrow $ پاسخ نهایی همراه با ارجاع به منابع.
ریشه مشکل: نبود مجموعه ارزیابی
اشتباه ۵۰ هزار دلاری به این دلیل رخ داد که تیم فاقد یک «مجموعه ارزیابی» (Evaluation Set) ثابت قبل از انتخاب تکنیک بود. آنها موفقیت را به صورت مبهم تعریف کرده بودند: «مدل به سؤالات پاسخ دهد». آنها یک مجموعه تعریفشده از ۵۰ سؤال مشخص، شامل ۱۰ مورد خاص (Edge Case) برای تست نداشتند.
اگر آنها ابتدا یک مجموعه ارزیابی با بیش از ۲۰ سؤال میساختند، در همان هفته اول متوجه میشدند که یک مدل پایه با پرامپت درست و مستندات در زمینه، کف نیاز آنها را پوشش میدهد. یک مجموعه ارزیابی، تیم را مجبور میکند قبل از ساخت هرگونه زیرساخت، تعریف دقیقی از «خروجی خوب» داشته باشد. بدون آن، تیمها دچار «مهندسی بر اساس حس» (Vibe-based engineering) میشوند و نمیتوانند تشخیص دهند که آیا مدل «هفته پیش بدتر شده» یا چرا تغییر کرده است.
این تغییر در رویکرد، توسعه هوش مصنوعی را به یک علم قابل اندازهگیری تبدیل میکند. هدف باید یافتن ارزانترین تکنیکی باشد که از سد ارزیابی عبور کند. ابتدا دو ساعت روی مهندسی پرامپت وقت بگذارید. اگر به ۷۰٪ دقت رسیدید، RAG را اضافه کنید. تنها در صورتی که هنوز فاصله دارید و مورد کاربردی شما هزینهی چرخه بهروزرسانی را توجیه میکند، به تنظیم دقیق فکر کنید.
گام بعدی شما
- پیش از هرگونه هزینه برای آموزش مدل، یک مجموعه ارزیابی شامل ۵۰ پرسش و پاسخ مرجع (Ground Truth) بسازید.
- ابتدا دو ساعت روی مهندسی پرامپت وقت بگذارید؛ اگر به ۷۰٪ دقت رسیدید، RAG را اضافه کنید.
- اگر از RAG استفاده میکنید، لاگ تکههای بازیابیشده را بررسی کنید تا مطمئن شوید توهمات مدل ناشی از بازیابی غلط نیست.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو