اگر ابزار پرسشوپاسخ داخلی شرکت شما ناگهان شماره تلفن مشتریان را لو میدهد یا پاراگرافهای بیربطی از قراردادها را برمیگرداند، غریزه اولیه بسیاری از مهندسان این است که مدلهای بردارسازی (Embedding) را تعویض کنند یا اندازه تکههای متن (Chunk size) را تغییر دهند. اما حقیقت این است که شکست سیستم در موارد نادر ناشی از مدل است. در واقع، سیستمهای تولید بازیابیافزا (RAG) — شبیه دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — معمولاً به دلیل نقص در خط لوله دادهها (Data Pipeline) شکست میخورند.
به نقل از راهنمای میدانی منتشر شده در dev.to در ۱۳ اکتبر ۲۰۲۶، ریشه این خطاها معمولاً در مراحل بالادستی خط لوله اسناد یافت میشود. همانطور که در تحلیل قبلی ما دربارهی استفاده از مدلهای محلی برای راهنماهای میدانی اشاره کردیم، کیفیت خروجی کاملاً به ساختار ورودی وابسته است. در محیطهای سازمانی، شکاف میان «نمونه اولیه» و «تولید واقعی» دقیقاً همینجا عمیق میشود؛ دموها با متنهای تمیز و ایدهآل کار میکنند، اما بدنه دادههای واقعی شرکتها آشفته، تکراری و ناامن هستند.
شکست اول: پوسیدگی اسکنها
بسیاری از اسناد سازمانی در واقع تصاویری هستند که لباس PDF پوشیدهاند. قراردادهای اسکن شده، پروندههای اداری فتوکپی شده و فکسهایی که با عکس گرفتن از نسخه چاپی دیجیتالی شدهاند، پس از عبور از لایه نویسهخوانی نوری (OCR) — ابزاری که متن را از روی عکس میخواند — به «سوپ متنی» تبدیل میشوند.
یک تکهبند (Chunker) استاندارد، این صفحات را بدون چون و چرا برش میزند و روی هر متنی که لایه OCR تولید کرده است، بردار معنایی (Embedding) — مثل کارت معرفی عددی برای هر واژه که میگوید این کلمه همسایهی چه کلمات دیگری است — میسازد. این رویکرد ساده در بسیاری از سیستمها منجر به نتایج ضعیفی میشود، چرا که تکهبندی با اندازه ثابت در اکثر موارد باعث گسستگی جملات و از دست رفتن معنا میشود. برای مثال، یک تکه واقعی از یک اسکن آسیبدیده ممکن است چنین باشد: «...طبق قرارداد، فروشنده مبلغ ۱?.۳?۴?۵?۶?.۷۸ را ظرف ۳۰ (3O) روز پس از صدور فاکتور پرداخت کند... [مهر روی بلوک امضا همپوشانی دارد] [خط ناخوانا — ستون جدول از دست رفته].»
این یک شکست خاموش است؛ چون بردار متن نویزی همچنان در نزدیکی ناحیه درست در فضای برداری قرار میگیرد، بنابراین سیستم بازیابی آن تکه را با شباهت کسینوسی (Cosine Similarity) بالا برمیگرداند. سپس مدل تولیدکننده با اطمینان کامل، پاسخی بر اساس یک فرض فاسد و غلط میسازد. در این حالت هیچ خطایی (Exception) در پشته سیستم ثبت نمیشود، اما کیفیت بازیابی بهتدریج به گونهای افت میکند که هیچ بودجه خطای (Error Budget) استاندارد نمیتواند آن را شناسایی کند.
سه نوع رایج از این پوسیدگی عبارتاند از:
- جداول پیکسلمحور: جداول قیمت که به صورت تصویر رندر شدهاند، روابط ردیفی و ستونی خود را در حین OCR از دست میدهند و دادههای ساختاریافته را به متنی بیمعنا تبدیل میکنند.
- مهرهای همپوشان: مهرهای رسمی که در اسناد دولتی و مالی چین (جایی که فرمت چیدمان OFD استاندارد است) بسیار رایج هستند، اغلب مستقیماً روی فیلدهای حیاتی قرار میگیرند و باعث میشوند خط لولههای OCR عمومی دچار اختلال شوند.
- نمایش دروغین امتیاز اطمینان: تیمها به میانگین امتیاز اطمینان (Confidence Score) لایه OCR به عنوان دلیلی بر سلامت متن اعتماد میکنند. اما میانگینها، فیلدهای خاص و حیاتی را که در واقع فاسد شدهاند، پنهان میکنند.
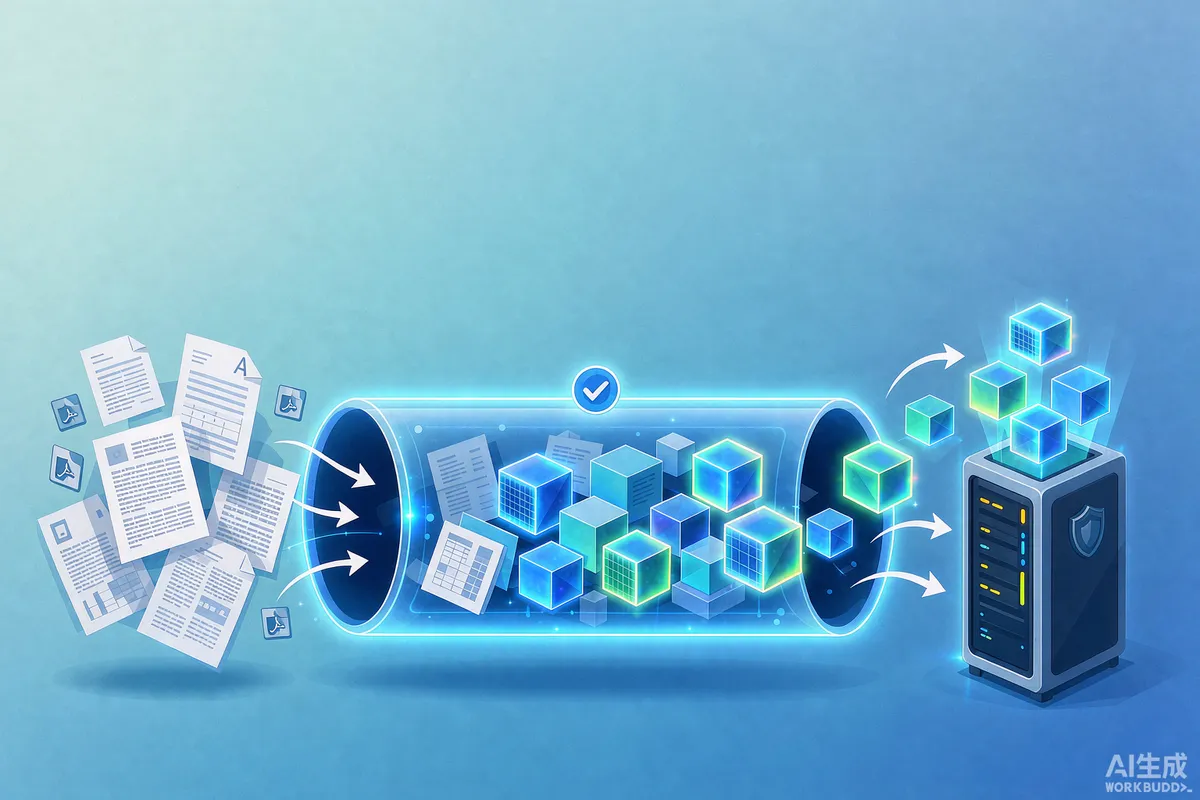
برای حل این مشکل، تیمها باید پیش از تکهبندی، «بازیابی ساختار» (Structure Recovery) را اجرا کنند. این به معنای بازسازی چیدمان منطقی سند — شامل تیترها، جداول و ترتیب خواندن — است تا تکهها از جملات واقعی تشکیل شوند، نه لکههای متنی. این یک گام مهندسی داده است، نه تنظیم مدل، و بخش بزرگی از تیکتهای «پاسخهای RAG عجیب است» در واقع از همینجا ریشه میگیرند.
شکست دوم: تکههای تکراری
پایگاههای داده برداری، محتوا را حذف تکرار (Deduplicate) نمیکنند. در چرخه عمر معمول یک سند سازمانی، ممکن است یک قرارداد در قالب پیشنویس، نسخه بازبینی شده، نسخه نهایی، نسخه «نهایی-نهایی» و نسخهای که در ماه مارس برای یک تامینکننده ایمیل شده است، وجود داشته باشد.
چون این پنج نسخه محتوای تقریباً یکسانی را توصیف میکنند، بردارهای آنها بهشدت در یک خوشه متراکم جمع میشوند. وقتی یک پرسوجو به این ناحیه میرسد، پنجره k-برتر (top-k) با نسخههای تکراری از یک پاراگراف پر میشود. این اتفاق باعث میشود تکه منحصربهفرد و معتبری که واقعاً پاسخ سؤال را دارد، از پنجره بیرون رانده شود.
این یک مشکل سیستماتیک است. طبق نظرسنجی M-Files، حدود ۹۶٪ کارکنان برای یافتن بهروزترین نسخه یک سند مشکل دارند و ۸۳٪ مجبور شدهاند سندی را دوباره بسازند چون نسخه اصلی را نیافتند. به عبارت دیگر، بدنه دادههای سازمانی توسط فرآیندی تولید میشود که تکرار را به عنوان یک حالت طبیعی میسازد.
راهکارهای عملی برای مقابله با این وضعیت، به ترتیب افزایش تلاش:
- حذف تکرارهای دقیق: استفاده از هشینگ محتوا (Content Hashing) برای حذف فایلهای کاملاً یکسان (سادهترین گام اول).
- خوشهبندی تکرارهای نزدیک: استفاده از شباهت برداری برای نگه داشتن تنها یک تکه مرجع (Canonical Chunk) در هر خوشه.
- سیاستهای مرجعسازی: تصمیمگیری درباره اینکه کدام نسخه از سند «حقیقت» است و تنزل رتبه سایر نسخهها از طریق متادیتا به جای حذف کامل.
- وزندهی به متادیتای منبع: تنظیم بازیابی در زمان پرسوجو بهگونهای که سیستم نسخه معتبرتر و رسمیتر را ترجیح دهد.
هیچکدام از این موارد نیازی به تغییر مدل ندارند، اما همه آنها تغییر میدهند که پنجره top-k چه شکلی باشد؛ و این تنها چیزی است که مدل تولیدکننده پاسخ میبیند.
شکست سوم: ایندکسهای نشتکننده
بازیابی دادهها اغلب به یک راه میانبر برای دور زدن کنترل دسترسی (Access Control) تبدیل میشود. مجوزهای سطح سند معمولاً در هنگام تکهبندی و ایندکسگذاری از بین میروند. پایگاه داده برداری قانونی مثل «فقط تیم مالی میتواند این فایل را باز کند» را به «هر کسی که پرسوجویش با این بردار مطابقت داشت، متن را میبیند» تبدیل میکند.
برای نشت فیلدهای حساس، نیازی به حملات پیچیده نیست. یک سؤال ساده درباره یک حساب خاص میتواند تکهای را بازیابی کند که شامل شماره تلفن آن حساب است، صرفاً چون بردارهای معنایی مطابقت دارند. در اینجا خودِ کتابخانه منبع نشت است. این مشکل در واقع بخشی از یک چالش بزرگتر است؛ جایی که شکاف میان اصطلاحات فنی و نحوه جستوجوی کاربران باعث میشود ایندکسهای AI نتوانند پاسخهای دقیق و ایمن را بازیابی کنند.
بر اساس گزارش هزینه نشت دادههای IBM در سال ۲۰۲۵، از هر پنج شرکت، یک شرکت دچار نشت دادهای به دلیل «هوش مصنوعی سایه» (Shadow AI) — یعنی استفاده کارکنان از ابزارهای AI غیرمجاز — شده است. این سازمانها بهطور متوسط ۶۷۰ هزار دلار بیشتر از همتایان خود برای هر نشت پرداخت کردهاند. همچنین ۶۳٪ این سازمانها هیچ سیاست حاکمیتی رسمی برای هوش مصنوعی نداشتند و ۵۳٪ دادههای سرقت شده، اطلاعات شناسایی شخصی (PII) مشتریان بود؛ دقیقاً همان دادههایی که در قراردادها، فاکتورها و پروندههای HR یافت میشوند.
دو قانون طراحی برای جلوگیری از این اتفاق:
۱. شناسایی و ماسک کردن فیلدهای حساس پیش از بردارسازی و ایندکسگذاری. این کار باید در ابتدا انجام شود، نه از طریق یک فیلتر پسینی (Post-hoc) که همیشه یک گام از پرسوجو عقبتر است.
۲. اجرای ماسکگذاری بهصورت محلی. ارسال اسناد خام به یک API خارجی برای ماسک کردن، فقط نشت داده را یک مرحله زودتر در خط لوله ایجاد میکند.
یک خط پایه عملی شامل شناسایی مبتنی بر قانون (Rule-based) برای دستههای رایج (شمارههای شناسایی، کارتهای بانکی، شماره تلفنها) و ساختارهای خاص هر صنعت است. این مجموعه قوانین باید قابل تنظیم باشد زیرا ترکیب اسناد هر شرکت متفاوت است.
راهکار سه مرحلهای اصلاح
برای حل این بحران، خط لوله ورودی باید توالی سختگیرانه «پاکسازی $ \rightarrow $ ماسکگذاری $ \rightarrow $ فشردهسازی $ \rightarrow $ ایندکسگذاری» را طی کند.
- پاکسازی: این مرحله شامل هشینگ تکرارهای دقیق، خوشهبندی تکرارهای نزدیک، بازیابی ساختار و جداول برای اسکنها و نرمالسازی فاصلههای خالی و کدگذاریها (Encodings) است.
- ماسکگذاری: این مرحله نیازمند شناسایی قطعی فیلدهای حساس است، بهطوری که ماسکگذاری پیش از بردارسازی و بهصورت محلی در شبکه داخلی اجرا شود.
- فشردهسازی: این یک کاهش حجم فایلهای حجیم با حفظ دقت (Fidelity) است که متن و ساختار را دستنخورده نگه میدارد.
یکی از پیادهسازیهای این مرحله به عنوان «پایه مهندسی داده RAG» از UglyPear Data در دسترس است، هرچند یک تیم داخلی قوی میتواند این مراحل را از روی ابزارهای اولیه بسازد.
این رویکرد اقتصاد هوش مصنوعی را بهطور قابلتوجهی تغییر میدهد. طبق دادههای IDC، ۸۰ تا ۹۰ درصد دادههای سازمانی در قالبهای بدون ساختار هستند. همچنین بررسیهای Komprise نشان میدهد ۶۰ تا ۷۰ درصد دادههای ذخیرهشده در NASهای سازمانی، بیش از ۹۰ روز است که دستنخورده در گرانترین لایههای ذخیرهسازی ماندهاند.
اسناد اسکنشده بدترین بخش این مشکل هستند؛ یک قرارداد چندصد صفحهای اسکن شده میتواند صدها مگابایت حجم خام داشته باشد. با حذف دادههای زائد بدون دست زدن به متن، میتوان حجم فایلها را در PDFها، تصاویر، اسناد Office و اسکنها ۶۰ تا ۸۰ درصد کاهش داد. برای یک کتابخانه ۲ ترابایتی، این یعنی کاهش حجم به ۴۰۰ تا ۸۰۰ گیگابایت، پیش از محاسبه حجم کوچکتر پایگاه داده برداری و کاهش اندازه دستههای بردارسازی.
هزینههای توکن حتی بیشتر کاهش مییابد. توکنسازهای چندوجهی (Multimodal) برای محتوای تصویری هزینه زیادی میگیرند. وقتی محتوای تصویری فشرده و پردازش شود، هزینههای توکن در مدل GPT-4o تا ۸۵.۹٪ کاهش مییابد. این صرفهجویی برخلاف ذخیرهسازی که یکباره است، در هر پرسوجو و هر روز بهصورت ترکیبی افزایش مییابد.
ارزیابی خط لوله
مهندسان باید خط لوله پیشپردازش خود را به جای لیست ویژگیها، بر اساس پنج معیار بسنجند:
- دقت (Fidelity): آیا متن دستنخورده باقی مانده؟ آیا چیدمان (جداول، مهرها، ترتیب خواندن) حفظ شده است؟
- پوشش و محلی بودن ماسکگذاری: چه دستههای حساسی شناسایی میشوند و آیا پردازش داخل شبکه شما اجرا میشود؟
- توان عملیاتی (Throughput): در حجم واقعی، چند صفحه در ثانیه پردازش میشود، از جمله فرمتهای دشوار و غیرمعمول؟
- یکپارچگی: آیا خروجی بدون نیاز به بازسازی کامل ایندکس، به پایگاه داده برداری موجود متصل میشود؟
- مشاهدهپذیری: آیا میتوان نمونههای قبل و بعد را با زوم کامل مشاهده کرد و متن استخراج شده را مقایسه (Diff) کرد؟
برای کسانی که این سیستم را پیاده میکنند، یک چکلیست پیشپرواز ضروری است:
- خروجی OCR را با چشم و با زوم کامل بررسی کنید — هرگز به میانگین امتیاز اطمینان اعتماد نکنید.
- نسبت تکرار تکههای بازیابی شده را در یک مجموعه تست از پرسوجوها اندازهگیری کنید.
- ایندکس خود را برای الگوهای PII (اطلاعات شناسایی شخصی) جستوجو (Grep) کنید؛ فرض کنید حتماً مورد نشت پیدا خواهید کرد.
- هزینه ذخیرهسازی و هزینه توکن هر پرسوجو را قبل و بعد از فشردهسازی محاسبه کنید.
- اطمینان حاصل کنید که ماسکگذاری در تمام مراحل داخل شبکه خودتان باقی میماند.
مدلها توجه همه را جلب میکنند، اما خط لوله است که پاسخها را فراهم میکند. این تغییر تمرکز، RAG را از یک مشکل «مهندسی پرامپت» به یک مشکل «مهندسی داده» تبدیل میکند. هدف این است که اطمینان یابیم پنجره top-k تنها شامل متنوعترین، تمیزترین و مجازترین تکههای اطلاعات است.
اگر در سیستم RAG خود پاسخهای «عجیب» میبینید، تنظیم مدل را متوقف کنید و حسابرسی لایههای OCR و حذف تکرار خود را آغاز کنید. مرز بحرانی بعدی، انتقال این مراحل ماسکگذاری و پاکسازی به خط لولههای CI/CD خودکار و مشاهدهپذیر برای دادهها است.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو