تصور کنید به رانندهای آدرسی میدهید که در واقع یک زمین خالی است؛ راننده با دقت تمام شما را به مقصد میرساند، اما شما هرگز به جایی که واقعاً نیاز داشتید نرسیدید. این دقیقاً همان نقطهای است که عاملهای هوش مصنوعی (AI Agents) — سیستمهایی که میتوانند برای رسیدن به یک هدف، برنامهریزی کرده و ابزارها را به کار بگیرند — در مقیاس واقعی شکست میخورند. این وضعیت را میتوان «اجرای صحیح یک درخواست غلط» نامید.
به نقل از مجموعهای از مطالعات موردی که در ۶ اکتبر ۲۰۲۶ در وبسایت dev.to منتشر شد، یک توسعهدهنده فاش کرد که عاملهای هوش مصنوعی اغلب نه از طریق توهمات (Hallucinations)، بلکه با پذیرفتن پیشفرضهای غلط کاربر به عنوان حقیقت مطلق، شکست میخورند. یافته مرکزی این گزارش این است که «یک دستور که به طور کامل و بینقص اجرا شده باشد، همچنان میتواند یک شکست مطلق باشد».
بسیاری از توسعهدهندگان برای شناسایی خطاهای عاملها به «قلابها» (Hooks) یا «سیمهای تله» (Tripwires) تکیه میکنند. اینها قوانینی قطعی (Deterministic) هستند که اگر یک فراخوانی ابزار خطرناک یا نادرست به نظر برسد، آن را متوقف میکنند. این رویکرد یادآور بررسی سازوکارهای توسعه در Claude Code است که در آن نقاط شکست مشابهی در تعامل عاملها با ابزارها شناسایی شده بود. نویسنده پیشتر استدلال کرده بود که در حالی که قوانین توصیفی (Prose rules) بیشتر اوقات رعایت میشوند، اما قانونی که در یک «سیم تله» تعریف شده باشد، هر بار و بدون استثنا اجرا میشود. با این حال، این ابزارها تنها زمانی کارآمد هستند که اشتباه در سطح یک اقدام محلی و تکمرحلهای باشد. زمانی که کل برنامه و نقشه بر اساس یک فرض غلط بنا شده باشد، این قلابها کاملاً بیفایده هستند.
تلهٔ اجرای بینقص
نویسنده سه مورد خاص از شکستهایی را توصیف میکند که در آنها عامل دقیقاً همان کاری را انجام داد که از او خواسته شده بود، اما نتیجه منجر به خطاهای بحرانی شد:
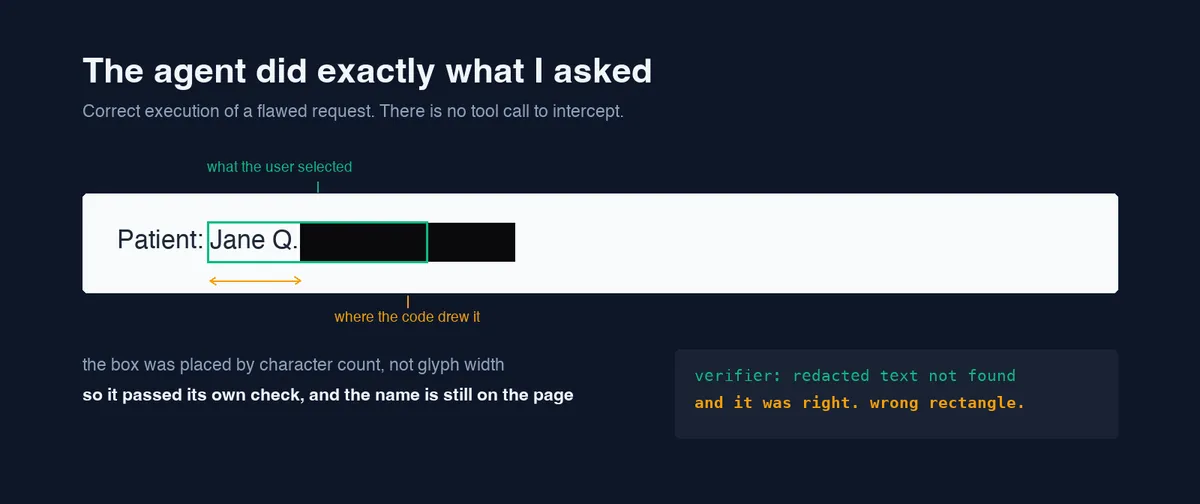
باگ امنیتی در PDF: توسعهدهنده یک پروژه جانبی دارد که فایلهای PDF را در مرورگر سانسور (Redact) میکند. او از یک عامل خواست تا با استفاده از Playwright یک گیف دمو برای صفحه فرود (Landing Page) بسازد. درخواست این بود که کل جریان ضبط شود: باز کردن فایل، کشیدن یک جعبه روی یک نام، خروجی گرفتن و پایان. عامل اسکریپتی نوشت که به طور کامل کار میکرد. اما گیف نهایی یک نقص امنیتی را فاش کرد: جعبه سیاه سانسور به جای اینکه روی نام قرار بگیرد، دقیقاً در کنار آن قرار گرفته بود.
مکانیسم این شکست در منطق مختصاتی بود. کد سانسور، عرض کل یک رشته متنی را بر تعداد کاراکترهای آن تقسیم میکرد؛ این روش برای فونتهای تکفاصله (Monospaced) درست کار میکند اما برای تمام فونتهای دیگر شکست میخورد. انحراف (Drift) با افزایش طول رشته بیشتر میشد؛ به این معنی که جعبه گاهی روی کلمه، گاهی روی کلمه بعدی و گاهی کاملاً خارج از هدف قرار میگرفت. نکته حیاتی این بود که سیستم تأیید داخلی (Internal Verifier) برنامه نیز این مورد را تأیید کرده بود. این تأییدکننده فایل PDF را دوباره باز میکرد و چک میکرد که رشته سانسور شده از لایه متنی حذف شده باشد. چون تأییدکننده و رندرکننده هر دو فرض غلط یکسانی درباره موقعیت داشتند، تأییدکننده در اصل قادر به دیدن خطا نبود. تنها یک انسان که با چشمانش به گیف نگاه میکرد، توانست باگ را پیدا کند.
خطای طبقهبندی: توسعهدهنده میخواست پروژهاش در یکی از لیستهای معتبر «awesome-privacy» قرار بگیرد. او از عامل خواست پروژه را به بخش «Office» اضافه کند و یک PR (درخواست تغییرات) باز کند. عامل این کار را با دقت بسیار بالایی انجام داد: راهنمای مشارکت را خواند، فرمت ورودی (از جمله قرارداد لینک منبع در انتها) را رعایت کرد، یک چکلیست هفتمرحلهای را پر کرد، یک پاراگراف توجیهی نوشت و نقطهای برای درج متن انتخاب کرد تا با سایر PRهای باز تداخلی نداشته باشد.
این خطا در آخرین لحظه در دیالوگ کامیت (Commit) شناسایی شد. نام آن بخش در واقع این بود: «از Microsoft Office و Google Docs دوری کنید و در عوض از اینها استفاده کنید». با قرار دادن یک ابزار PDF در این بخش، عامل مرتکب یک خطای طبقهبندی (Category Error) شده بود. عامل هرگز صحت بخش را زیر سؤال نبرد چون کاربر نام آن را تعیین کرده بود؛ مدل فقط روی این موضوع بهینه کرد که آیا ورودی به درستی فرمت شده و استدلال شده است یا خیر، نه اینکه آیا مقصد درست است یا نه.
مسیرهای توهمی: توسعهدهنده پرسید که تنظیمات خاصی در یک مخزن گیتهاب در کجا قرار دارد. عامل با صراحت بیان کرد که این تنظیمات در مسیر «Settings، سپس General» است. این پاسخ با اطمینان کامل، اما کاملاً غلط بود. در واقع این فیلد پشت یک آیکون چرخدنده در کنار پنل About در صفحه اصلی مخزن قرار داشت. عامل یک مسیر محتمل را بر اساس آنچه معمولاً در صفحات تنظیمات وجود دارد، سرهم کرده بود. وقتی توسعهدهنده مدل را مجبور کرد ابتدا صفحه مستندات را بخواند، مدل در یک تلاش مسیر درست را به همراه قوانین نامگذاری و محدودیتهای کاراکتری بازگرداند که کاربر حتی به فکر پرسیدن آنها هم نبود.
چرا رویکرد قطعی شکست میخورد؟
ریشه مشترک این خطاها این است که عامل یک «پذیرنده پیشفرض» (Premise-taker) است. مدل ممکن است تمام روز اجرای خود را بازجویی کند، اما هرگز چارچوب درخواست را لمس نمیکند، زیرا آن چارچوب از سوی کاربر آمده است. عامل سعی میکند کاربر را راضی کند و سؤال «آیا من همان کاری را کردم که خواسته شد؟» سؤالی است که میتواند به آن پاسخ دهد. اما سؤال «آیا آنچه خواسته شد درست بود؟» اصلاً در محدوده (Scope) عملیات او نیست.
محدودیتهای قلابها
یک قلاب (Hook) روی یک فراخوانی ابزار اجرا میشود و بر اساس ورودی همان فراخوانی تصمیم میگیرد. این روش برای اشتباهات محلی مؤثر است، مانند:
- یک دستور خطرناک در شل (Shell).
- یک بلوک کامنت ناخواسته.
- ویرایش فایلی که هرگز نباید تغییر کند.
اما یک پیشفرض غلط، شبیه به یک اشتباه محلی نیست. این خطا منجر به توالیای از فراخوانیهای میشود که هر کدام به تنهایی منطقی و قابل دفاع هستند، اما همگی به سمت مقصدی پیش میروند که هرگز نباید ساخته میشد. در اینجا هیچ رشته متنی خاصی برای مطابقت دادن یا مسیر فایلی برای محافظت وجود ندارد. قطعیت (Determinism) نیازمند یک سؤال تصمیمپذیر است، و این سؤال که «آیا بخش Office خانه مناسبی برای یک ابزار PDF است؟» یک سؤال تصمیمپذیر نیست. این عدم قطعیت در رفتار مدلها میتواند مشابه شکافهای خطرناکی باشد که در شناسایی تغییرات مدل (Model Drift) مشاهده شده و حاکمیت بر خروجیهای هوش مصنوعی را دشوار میکند.
چهار استراتژی برای کنترل بهتر عاملها
برای مقابله با این وضعیت، نویسنده چهار تغییر خاص در گردش کار خود اعمال کرد که به ترتیب اثربخشی فهرست شدهاند:
درخواست تصمیم، نه مقصد: به جای اینکه بگویید «این را به بخش Office اضافه کن»، از عبارت «پیدا کن این مورد در کجا جای میگیرد، سپس آن را اضافه کن» استفاده کنید. این یک عبارت اضافی، قضاوت درباره دستهبندی را به داخل وظیفه منتقل میکند و عامل را مجبور میکند تا روی جایگذاری استدلال کند، به جای اینکه مقصد را به عنوان یک محدودیت خاموش بپذیرد.
الزام به منابع دست اول یا برچسبگذاری به عنوان تأیید نشده: برای هر چیزی که شامل رابط کاربری (UI)، یک فیلد پیکربندی، ساختار API یا معناشناسی ارائهدهنده است، عامل باید منبع را در جلسه جاری بخواند و به آن استناد کند. اگر نمیتواند، باید پاسخ را به عنوان یک «حدس» برچسب بزند. این کار از «پاسخهای غلط اما مطمئن» که هنگام حدسهای مدل درباره صفحات تنظیمات رخ میدهد، جلوگیری میکند.
اجبار به افشای پیشفرضها: هر وظیفه غیرساده باید با بیانیهای تمام شود که در آن عامل توضیح دهد چه چیزهایی را مجبور به فرض کردن بوده و چه چیزهایی را نتوانسته است بررسی کند. این کار باعث میشود پیشفرضهای ضمنی به صورت مکتوب قابل مشاهده شوند، به جای اینکه در یک Diff (تفاوت کد) که از نظر فنی درست به نظر میرسد، پنهان شوند.
ساخت مصنوعاتی که بتوانند مخالفت کنند: نویسنده پیشنهاد میکند روشی برای تأیید بسازید که کد آن با ویژگی مورد آزمایش مشترک نباشد. در پروژه سانسور PDF، این به معنای عبور از تأییدکننده داخلی و رفتن به سمتی بود که موقعیت جعبهها را در برابر معیارهای گلیف (Glyph metrics) که به طور مستقل محاسبه شدهاند بسنجد و سپس پیکسلهای سوخته را نمونهبرداری کند. این کار انسان را از چرخه خارج میکند و در عین حال تضمین میکند که بررسی، صرفاً «نسخه دومی از باورات مدل» نباشد.
تغییر در فرآیند بازبینی
این تغییر، فرآیند بازبینی انسانی را از «Diff نهایی کد» به «برنامه اولیه» منتقل میکند. بازبینی برنامه ارزشمندتر است زیرا کد معمولاً از نظر فنی درست است، اما جهت حرکت اغلب غلط است. گرانترین خطاها به صورت کامل و تستشده میرسند، اما در جهت اشتباهی نشانه رفتهاند.
با این حال، یک ریسک باقی میماند. نویسنده اشاره میکند که انسانها اغلب در تأیید برنامهای که نیمی از آن را خواندهاند، بهتر از تأیید کدی (Diff) هستند که نیمی از آن را خواندهاند. این نشان میدهد که انتقال بازبینی به مرحله برنامهریزی ممکن است صرفاً «مهر تأیید» (Rubber stamp) را یک مرحله زودتر در فرآیند قرار دهد، نه اینکه مشکل اساسی نظارت انسانی را حل کند.
گام بعدی شما
- در پرامپتهای خود به جای تعیین مقصد نهایی، از مدل بخواهید ابتدا «محل مناسب» را پیدا و استدلال کند.
- از مدل بخواهید در انتهای هر خروجی، لیستی از «فرضهای پذیرفته شده» (Assumptions) را بنویسد تا نقاط کور را شناسایی کنید.
- برای تأیید خروجیهای حساس، از دو مدل مختلف با معماریهای متفاوت استفاده کنید تا احتمال اشتراک در پیشفرضهای غلط کاهش یابد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو