
تصور کنید یک برنامهنویس ارشد خطی مشکوک از کدهای قدیمی (Legacy Code) را حذف میکند، تستها پاس میشوند و PR (درخواست ادغام) پذیرفته میشود؛ اما سه ساعت بعد، کل سیستم در محیط عملیاتی (Production) سقوط میکند. این سناریوی رایج، شکاف عمیق و بحرانی در مهندسی نرمافزار به کمک هوش مصنوعی فعلی را نشان میدهد: هوش مصنوعی میتواند کد را به طور ارزان تولید کند، اما درک «چرایی» پشت کدهای موجود همچنان هزینهای گزاف دارد. این چالش با این واقعیت که کدهای تولیدی هوش مصنوعی گاهی کاربردی اما از نظر فنی غلط هستند، پیچیدهتر میشود زیرا ظاهر درست کد میتواند مهندسان را به اشتباه بیندازد.
به نقل از گزارشی که در ۳۰ اوت ۲۰۲۶ در وبسایت dev.to منتشر شد، صنعت نرمافزار به گلوگاهی رسیده است که در آن سرعت تولید کد توسط ماشین، از توانایی انسان و مدلها برای درک و تحلیل آن پیشی گرفته است. برای درک بهتر، یک مثال خاص را در نظر بگیرید: قطعه کدی مانند if (user.isLegacy && !featureEnabled) { return fallback(); }. برای یک عامل (Agent) هوش مصنوعی، این کد شبیه به یک کد بلااستفاده (Dead Code) یا بخشی است که پاکسازی آن فراموش شده است. عامل پیشنهاد حذف آن را میدهد، تستها سبز میشوند و PR تمیز به نظر میرسد. اما سه ساعت بعد، سیستم برای گروهی از مشتریان از کار میافتد. پاسخ به این سؤال حیاتی که «چه کسی میدانست این کد چرا اینجا بود؟» معمولاً بیپاسخ میماند؛ زیرا پاسخ در میان ۴۷ کامیت، ۱۲ درخواست ادغام (PR)، یک گزارش حادثه قدیمی، گفتگوهای اسلک (Slack) که هیچکس به یاد نمیآورد و حافظه مهندسی که شش ماه پیش شرکت را ترک کرده، دفن شده است.
بسیاری از توسعهدهندگان برای ردیابی اینکه چه چیزی تغییر کرده، چه کسی آن را تغییر داده و چه زمانی این اتفاق افتاده، به گیت (Git) تکیه میکنند. اما گیت نمیتواند دانش پراکندهای را که در گفتگوهای اسلک، گزارشهای قدیمی حوادث یا حافظه مهندسی که شرکت را ترک کرده است، ثبت کند. گیت به ما میگوید «چه چیزی» تغییر کرده است، اما مهندسان نیاز دارند بدانند «چرا» تغییر کرده، این کد در حال حل چه مشکلی بوده، چه بخشهایی به آن وابسته هستند و آخرین باری که کسی به آن دست زده چه اتفاقی افتاده است. این خلأ اطلاعاتی و فقدان زمینه (Context)، محیطی خطرناک برای عاملهای هوش مصنوعی ایجاد میکند که فقط بر اساس وضعیت فعلی فایل منبع عمل میکنند. در همین راستا، ابزارهایی مانند Gitmore تلاش میکنند تا گزارشهای مهندسی را مستقیماً از تاریخچه گیت استخراج کنند تا بخشی از این خلأ اطلاعاتی پر شود.
سازوکار گراف مهندسی
برای حل این مشکل، پیادهسازی یک گراف مهندسی (Engineering Graph) پیشنهاد شده است. برخلاف جستوجوی سنتی کد که فقط نشان میدهد کدام فایلها فایل دیگری را Import میکنند، گراف مهندسی روابط بین انواع مختلف مصنوعات مهندسی را ترسیم میکند.
در یک جستوجوی سنتی، فایل checkout.ts ممکن است صرفاً به عنوان فایلی لیست شود که توسط payment.ts ، cart.ts و order.ts فراخوانی شده است. اما گراف مهندسی یک روایت (Narrative) ارائه میدهد: فایل checkout.ts توسط PR شماره ۸۴۲ تغییر کرد، که این PR مشکل شماره ۴۲۱ را حل میکرد، توسط «مایا» بازبینی شد و در پی حادثه شماره ۹۱ ایجاد گشت. این فایل به retry.ts وابسته است و دقیقاً پس از وقوع یک خطای تایماوت در مرحله پرداخت معرفی شد. همچنین این فایل در طول حوادث مربوط به پرداخت، هفت بار تغییر یافته است.
گرههای این گراف شامل موارد زیر است:
- فایلها و سرویسها: اجزای فیزیکی و ساختاری سیستم.
- کامیتها و Pull Requestها: سوابق رسمی تغییرات.
- تیکتها و حوادث (Incidents): مشکلاتی که تغییر در کد را ضروری کردند.
- افراد و تصمیمات: بستر انسانی، تصمیمگیرندگان و نتایج حاصل از آن انتخابها.
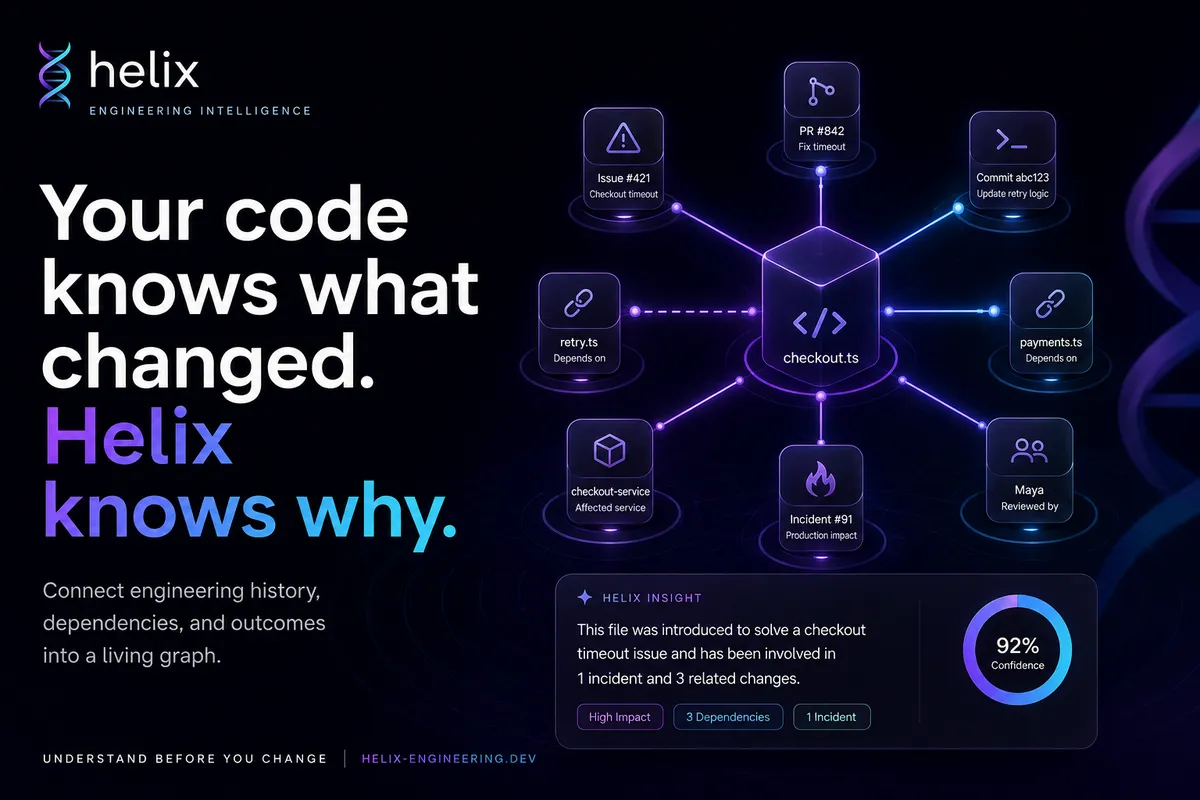
ارزش واقعی این سیستم در یالها (Edges) یا همان روابط نهفته است. گراف یک جریان منطقی را دنبال میکند: یک تیکت (Issue) توسط یک PR حل میشود $
ightarrow$ PR کد را تغییر میدهد $
ightarrow$ کد به یک سرویس وابسته است $
ightarrow$ سرویس تحت تأثیر یک حادثه قرار میگیرد $
ightarrow$ حادثه با یک اصلاحیه (Fix) حل میشود $
ightarrow$ اصلاحیه به یک مهندس متصل است $
ightarrow$ مهندس تصمیمی میگیرد که منجر به یک نتیجه (Outcome) میشود.
روایت به جای منبع
وقتی از یک عامل هوش مصنوعی پرسیده شود «آیا میتوانم این مکانیزم تلاش مجدد (Retry) را حذف کنم؟» و او فقط به کد منبع دسترسی داشته باشد، احتمالاً پاسخ میدهد: «این Retry اضافی به نظر میرسد و احتمالاً میتوان آن را حذف کرد». این پاسخ نه تنها مفید نیست، بلکه بالقوه خطرناک است.
اما اگر به زمینه مهندسی دسترسی داشته باشد — یعنی بداند retry.ts $
ightarrow$ توسط checkout.ts استفاده میشود $
ightarrow$ در PR شماره ۸۴۲ معرفی شده $
ightarrow$ این PR به تایماوت پرداخت شماره ۴۲۱ مرتبط است $
ightarrow$ حادثه شماره ۹۱ دقیقاً همین مسیر درخواست را درگیر کرده بود $
ightarrow$ و سه PR بعدی رفتار Retry را اصلاح کردهاند — استدلال هوش مصنوعی تغییر میکند. حالا او میتواند پاسخ دهد: «من فعلاً آن را حذف نمیکنم. این مکانیزم برای رفع یک مشکل تایماوت در پرداخت ایجاد شده و پس از حوادث عملیاتی چندین بار تغییر کرده است. من ابتدا حادثه شماره ۹۱ و PRهای مرتبط را بررسی میکنم و سپس تصمیم میگیرم». این سطح از دقت در تحلیل، مشابه رویکردی است که در سیستم AI Code Guard برای شناسایی نقصهای امنیتی در PRهای تولید شده توسط هوش مصنوعی به کار میرود تا از تایید باگهای پنهان جلوگیری شود.
ساختار گراف و پیادهسازی
برای شروع، نیازی به یک پروژه زیرساختی عظیم نیست. یک گراف کوچک را میتوان با استفاده از تایپهای ساده تعریف کرد:
- نوع گره (NodeType):
file,commit,pull_request,issue,service,incident,person. - رابطه (Relationship):
MODIFIED(تغییر داد)،SOLVED(حل کرد)،DEPENDS_ON(وابسته است به)،AUTHORED_BY(نوشته شده توسط)،REVIEWED_BY(بازبینی شده توسط)،AFFECTED(تحت تأثیر قرار گرفت)،CAUSED(باعث شد).
هر گره توسط یک ID، نوع، نام و متادیتا تعریف میشود و یالها این گرهها را به هم متصل میکنند. برای مثال، مجموعهای از یالها میتواند اینگونه باشد:
pr:842$
ightarrow$MODIFIED$
ightarrow$file:checkout.tspr:842$
ightarrow$SOLVED$
ightarrow$issue:421file:checkout.ts$
ightarrow$DEPENDS_ON$
ightarrow$file:retry.tsincident:91$
ightarrow$AFFECTED$
ightarrow$service:checkout
این ساختار به سیستم اجازه میدهد به سؤالاتی پاسخ دهد که جستوجوی متنی ساده در برابر آنها ناتوان است.
گردشکار جدید عاملها
یک عامل هوش مصنوعی سنتی از حلقهی «هدف $
ightarrow$ مشاهده $
ightarrow$ تصمیم $
ightarrow$ اجرا $
ightarrow$ بررسی» پیروی میکند. این یعنی او هر وظیفه را با سطح بالایی از جهل آغاز میکند. با ادغام گراف، این گردشکار تکامل مییابد:
هدف $
ightarrow$ پرسوجو از گراف $
ightarrow$ مشاهده $
ightarrow$ تصمیم $
ightarrow$ اجرا $
ightarrow$ تأیید $
ightarrow$ بهروزرسانی گراف.
اکنون عامل فقط مخزن کد را مشاهده نمیکند، بلکه پیش از آنکه حتی یک خط کد را لمس کند، مشاهده میکند که در گذشته چه اتفاقاتی افتاده است.
معماری یادگیرنده برای عاملها
این گراف به عاملهای هوش مصنوعی اجازه میدهد بدون نیاز به آموزش مجدد (Retraining) مدلهای پایه، یاد بگیرند. در حالت عادی، هوش مصنوعی از طریق مدلهای بهتر و آموزش بیشتر برای بهروزرسانی وزنها بهبود مییابد. اما عاملها مسیر دیگری دارند: تجربه بهتر $
ightarrow$ گراف بهتر $
ightarrow$ زمینه (Context) بهتر $
ightarrow$ تصمیمات بهتر $
ightarrow$ تجربه بهتر. در واقع محیط اطراف مدل بهبود مییابد، حتی اگر خود مدل ثابت بماند.
برای جلوگیری از ایجاد «حلقه اعتماد» (Confidence Loop) — جایی که هوش مصنوعی یک حدس غلط را به عنوان حقیقت ثبت میکند (مثلاً ثبت میکند که «۱۰ بار تلاش مجدد مشکل پرداخت را حل میکند» فقط چون یک بار تست پاس شد) — سیستم به شواهد نیاز دارد. یک تغییر تنها زمانی به «دانش» ارتقا مییابد که یک زنجیره تأیید شده را طی کند:
تغییر کد $
ightarrow$ پاس شدن تستهای واحد $
ightarrow$ پاس شدن تستهای یکپارچگی $
ightarrow$ ادغام PR $
ightarrow$ استقرار موفق $
ightarrow$ عدم وقوع حادثه پس از استقرار.
این فرآیند توسط یک تایپ به نام Outcome (نتیجه) نمایش داده میشود که شامل وضعیت (موفقیت/شکست)، امتیاز اطمینان (مثلاً ۰.۹۲) و لیستی از رشتههای شواهد است. برای مثال، یک شیء Outcome لیست میکند: «تستهای واحد پاس شدند»، «تستهای یکپارچگی پاس شدند»، «PR ادغام شد» و «استقرار موفق بود».
سطوح مختلف دانش
هر مشاهدهای لزوماً یک حقیقت نیست. سیستم برای جلوگیری از ریختن هر فکر پراکنده عامل در یک پایگاه داده برداری (Vector Database)، بین سطوح مختلف اطلاعات تفاوت میگذارد:
- مشاهده (Observation): فایل
checkout.tsفایلretry.tsرا فراخوانی میکند. - رویداد (Event): PR شماره ۸۴۲ فایل
checkout.tsرا تغییر داد. - نتیجه (Outcome): تستها پس از تغییر پاس شدند.
- دانش (Knowledge): فایل
checkout.tsمکرراً همراه باretry.tsتغییر میکند. - قاعده سرانگشتی (Heuristic): وقتی تستهای تایماوت پرداخت شکست میخورند، ابتدا رفتار Retry را بررسی کن.
ارزش دانش منفی
یکی از قدرتمندترین جنبههای این سیستم، ثبت شکستها است. اکثر سیستمهای هوش مصنوعی فقط آنچه را که جواب داده به یاد میآورند. اما یک گراف مهندسی یادگیرنده به خاطر میسپارد که «رویکرد الف» نتوانست مشکل تایماوت را حل کند، بنابراین عامل بعدی همان اشتباه را تکراد نمیکند. این «دانش منفی» از برخورد مکرر هوش مصنوعی به یک دیوار جلوگیری میکند و صراحتاً ترسیم میکند: وظیفه $
ightarrow$ تلاش شد $
ightarrow$ رویکرد الف $
ightarrow$ شکست خورد.
فراتر از RAG
اگرچه تولید بازیابیافزا (RAG) رایج است، اما برای این مشکل کافی نیست. RAG میپرسد چه اطلاعاتی با یک سؤال مرتبط است، اما گراف میپرسد چیزها چگونه به هم مرتبطاند. یک بازیاب سند ممکن است سه PR مرتبط را پیدا کند، اما یک گراف میتواند کل داستان یک فایل پرریسک را بازسازی کند و آن را به افراد خاص و شکستهای گذشته متصل کند.
وقتی میپرسیم «چرا فایل checkout.ts پرریسک است؟»، RAG ممکن است لیستی از PRها را برگرداند. اما گراف زنجیره را بازسازی میکند: checkout.ts $
ightarrow$ تغییر یافته توسط PR شماره ۸۴۲ $
ightarrow$ نوشته شده توسط مایا $
ightarrow$ بازبینی شده توسط بابی $
ightarrow$ مرتبط با retry.ts $
ightarrow$ اثر گذاشته بر checkout-service $
ightarrow$ متصل به حادثه شماره ۹۱ $
ightarrow$ ایجاد شده توسط تغییر قبلی در بخش پرداخت.
این فناوریها در کنار هم بهترین نتیجه را میدهند: پرسش کاربر $
ightarrow$ جستوجوی معنایی $
ightarrow$ شناسایی موجودیتهای مرتبط $
ightarrow$ پیمایش گراف $
ightarrow$ استخراج روابط $
ightarrow$ مدل زبانی (LLM) $
ightarrow$ پاسخ مستند به شواهد.
مقیاسپذیری هوشمندی
این مدل میتواند فراتر از یک مخزن کد واحد، با جذب دادهها از سراسر سازمان مقیاس یابد:
- گیتهاب: کامیتها، PRها، کدها، سرویسها، استقرارها، حوادث، اصلاحات و تجربیات عاملها.
- ابزارهای خارجی: جیرا (Jira)، اسلک، کانفلوئنس (Confluence)، دیتاداگ (Datadog)، تصمیمات معماری و بازخوردهای انسانی.
این کار یک مدل زنده از سازمان ایجاد میکند و اجازه میدهد کاربران بپرسند:
- «چرا این معماری انتخاب شد؟»
- «چه کسی این سرویس را به خوبی میشناسد؟»
- «معمولاً وقتی این بخش را تغییر میدهیم، چه چیزی میشکند؟»
- «کدام فایلها پرریسک هستند؟»
- «تا به حال چه روشهایی امتحان شده است؟»
- «کدام مهندسان مشکلات مشابه را حل کردهاند؟»
- «بعد از آخرین استقرار چه اتفاقی افتاد؟»
- «یک عامل هوش مصنوعی قبل از دست زدن به این سرویس باید چه چیزهایی را بررسی کند؟»
این پاسخها از اتصالات بین سیستمها بیرون میآیند، نه از یک پایگاه داده واحد.
معماری چهارلایه
معماری نهایی یک پشته (Stack) ساده و قدرتمند است:
۱. عاملها (Agents): مدیریت استدلال، برنامهریزی و اقدام.
۲. زمینه (Context): مدیریت جستوجو، بازیابی و RAG.
۳. گراف مهندسی (Engineering Graph): ذخیره حافظه کدها، PRها، افراد، حوادث، تصمیمات، وابستگیها و نتایج.
۴. شواهد (Evidence): استخراج داده از گیتهاب، CI، ابزارهای استقرار، ابزارهای مشاهدهپذیری (Observability) و انسانها.
فرصت واقعی
هوش مصنوعی تولید نرمافزار را به شدت سریعتر کرده است، اما این موضوع گلوگاه جدیدی ایجاد میکند: درک نرمافزار. اگر هوش مصنوعی بتواند ۱۰ برابر بیشتر کد تولید کند، ما به ابزارهایی نیاز داریم که به مهندسان کمک کند ۱۰ برابر بیشتر نرمافزار را درک کنند. در غیر این صورت، ما فقط در حال شتاب دادن به تولید سیستمهایی هستیم که هیچکس آنها را به طور کامل نمیفهمد.
این رویکرد در حال پیادهسازی در Helix است؛ ابزاری که برای ساخت یک مدل زنده از نحوه عملکرد واقعی یک سازمان مهندسی طراحی شده است. با متصل کردن فعالیتهای گیتهاب به دادههای تصمیمگیری، هدف این است که هوش مصنوعی از ابزاری که «با اطمینان حدس میزند» به ابزاری تبدیل شود که «میتواند مستندات کارش را نشان دهد». برای توسعهدهنده مدرن، گلوگاه از «نوشتن کد» به «مدیریت گراف دانش» منتقل میشود. هدف، سیستمی مهندسی است که بتواند از کارهایی که انجام میدهد یاد بگیرد و تضمین کند که تاریخچه کد، به اندازه خود کد در دسترس است.
گام بعدی شما
- اگر مدیر فنی هستید، بررسی کنید که آیا مستندات تصمیمات معماری (ADR) شما به کامیتهای گیت متصل است یا خیر.
- برای تیمهای توسعه، ثبت دقیق «علت تغییر» در پیامهای کامیت را اجباری کنید تا دادههای اولیه برای ساخت گراف فراهم شود.
- ابزارهای تحلیل گراف را برای شناسایی فایلهای «پرریسک» (آنهایی که بیشترین تغییرات و حوادث را داشتهاند) در پروژه خود به کار بگیرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو