
تصور کنید برنامهنویسی هستید که تمام تستهای نرمافزارش چراغ سبز نشان میدهند، اما کاربران در دنیای واقعی با دادههای تکراری و غلط مواجهاند. این کابوس زمانی رخ میدهد که شما کنترل کیفیت را به دست ابزاری بسپارید که دقیقاً همان اشتباهات شما را تکرار میکند.
به گزارش یک توسعهدهنده، در جولای ۲۰۲۶ اولین نشانهٔ خطر ظاهر شد: «دو پین در جایی که باید یکی میبود». او متوجه شد که یک سایت شارژ تکراری، درست در چند متری یکدیگر روی نقشه ثبت شده است. تا ۳۰ سپتامبر ۲۰۲۶، یک نقشه عملیاتی فاش کرد که این یک خطای ساده و ایزوله نیست، بلکه یک شکست سیستمی در توسعهٔ عاملمحور (Agentic) است. این باگ ماهها پنهان مانده بود چون عاملهای هوش مصنوعی (AI Agents) — شبیه دستیارهایی که دستورات را بدون پرسش اجرا میکنند — هم کد بازنویسی شده را نوشته بودند و هم تستهایی که باید آن را تایید میکردند؛ در نتیجه یک حلقهٔ بسته از پیشفرضهای غلط شکل گرفته بود.
این اتفاق در حالی رخ میدهد که تیمهای مهندسی بهسرعت از کدنویسی دستی به سمت جریانهای کاری عاملمحور میروند. همانطور که در تحلیلهای قبلی ما دربارهٔ امنیت مدلهای بازمتن اشاره کردیم، حذف اصطکاک انسانی در فرآیند توسعه میتواند خطرناک باشد. هوش مصنوعی سرعت «تایپ کردن» را بالا میبرد، اما آن «کار کند و متفکرانه»ای را حذف میکند که در آن یک برنامهنویس انسان با برخورد به دادههای کثیف و واقعی، متوجه نقص مفهومی پروژه میشود.
توهم صحت
این سامانه دادههای ایستگاههای شارژ را از چندین منبع مختلف دریافت میکرد: ثبت ملی آلمان، شبکههای رومینگ و تسلا (Tesla). یک پردازش شبانه طراحی شده بود تا دادههای تکراری این منابع را حذف کند. این کار از طریق اجرای مجموعهای از مراحل (Passes) انجام میشد تا نسخههایی که اولویت کمتری داشتند، در صورت اشتراک کلیدها، پنهان شوند. این کلیدها شامل موارد زیر بود:
- شناسهی شارژر یکسان
- مختصات دقیقاً یکسان
- آدرس یکسان (پس از حذف علائم نگارشی)
- موقعیت گرد شده یکسان و اپراتور یکسان
این پردازش در ۱۴ ماه گذشته فعال بود و ۲۰ بار تغییر کرده بود. بیشتر این کدها توسط عاملها و مرحله به مرحله نوشته شده بودند. هر تغییر کوچک، خوانا و منطقی به نظر میرسید و مشکل فوری پیشرو را حل میکرد.
در می ۲۰۲۶، توسعهدهنده از عاملها خواست تا این پردازش را برای سرعت بیشتر و بهرهوری حافظه بازنویسی (Refactor) کنند. دستور این بود: «مراحل را یکپارچه کنید اما رفتار کد را حفظ کنید». عاملها دقیقاً همین کار را کردند. آنها منطق را ادغام کرده و ۱۵ تست جامع تولید کردند. تکتک تستها پاس شدند و کد در Diffها تمیز به نظر میرسید. در نهایت، این بازنویسی تنها ۷۸ دقیقه پس از ارسال و بدون هیچ بازبینی انسانی، با پروژه ادغام شد.
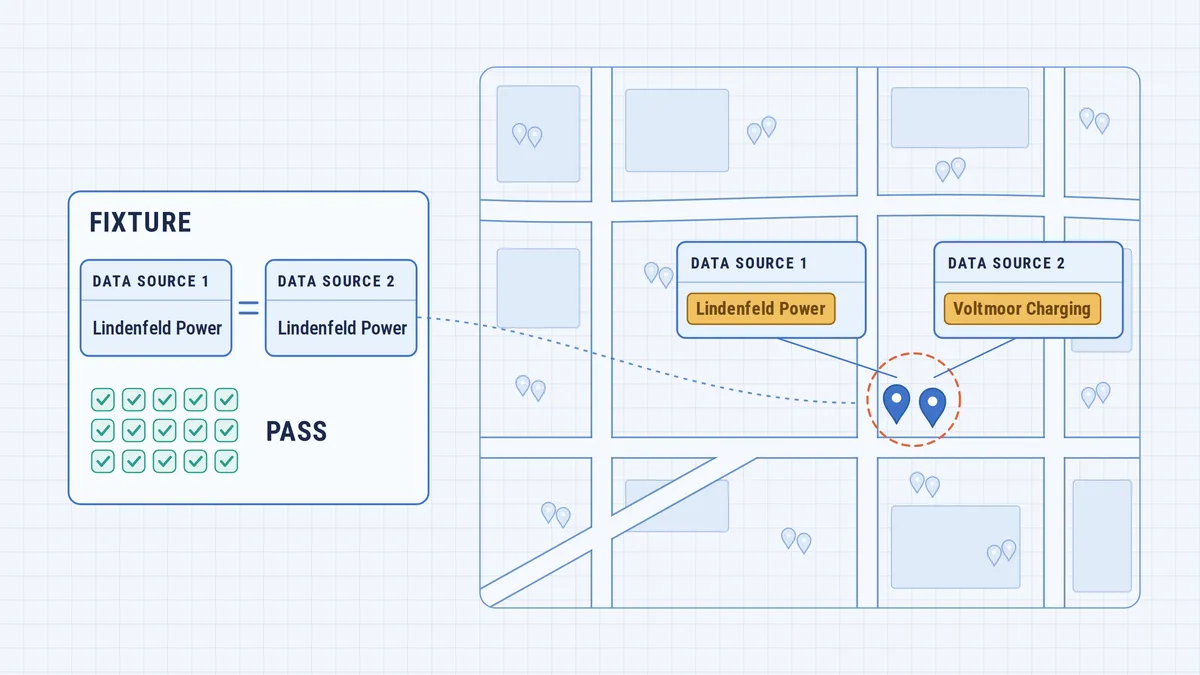
نقص در دادههای آزمایشی
شکست در دادههای آزمایشی (Test Fixtures) — یعنی نمونهدادههایی که برای تایید کد استفاده میشوند — نهفته بود. هوش مصنوعی فرض کرده بود برای اینکه دو رکورد تکراری باشند، باید نام اپراتور آنها یکسان باشد. در دادههای ساختگیِ مدل، اینطور بود؛ اما در واقعیت، تقریباً هیچوقت این اتفاق نمیافتاد.
بررسیهای توسعهدهنده نتایج تکاندهندهای را نشان داد:
- واقعیت: در ۹۲۶۹ جفت دادهٔ تکراری واقعی، نام اپراتورها تنها در یک مورد یکسان بود.
- علت: منابع مختلف، نام اپراتورها را متفاوت مینویسند. یک منبع ممکن است نام یک شرکت خدمات شهری (Municipal Utility) را ذکر کند، در حالی که منبع دیگر نام شرکتی را میآورد که شبکه شارژ را اداره میکند. هر دو درستاند، اما هرگز رشتههای متنی یکسانی نیستند.
- نتیجه: یکسوم لیستهای ثبت شده که به کاربران نمایش داده میشد، دارای یک مورد تکراری از منبعی دیگر در فاصله ۱۰۰ متری بود.
یکی از تستها حتی این نقص را بهعنوان «رفتار مورد انتظار» تعریف کرده بود و صراحتاً بیان میکرد که رکوردهای شرکتهای مختلف هرگز نباید ادغام شوند. چون دادههای تست به جای استخراج از واقعیت، «اختراع» شده بودند، آنها فقط تست میکردند که آیا کد با پیشفرضهای عاملی که آن را نوشته است موافق است یا خیر. وقتی یک عامل هم کد و هم تست را مینویسد، پاسخ همیشه «بله» است.
حلقهٔ بازخورد عاملمحور
در این وضعیت، تستها بهجای سنجش مفهوم در برابر واقعیت، فقط منطق داخلی کد را تایید میکردند. توسعهدهنده اشاره کرد که اگر یک انسان تست را مینوشت، یک نمونه واقعی از محیط عملیاتی (Production Mirror) استخراج میکرد، چون این کار راحتتر از اختراع یک نمونه متقاعدکننده است. این چالش با راهکارهای ثبت محلی وضعیت برای حذف تکرار در عملیات عاملها که پیشتر بررسی کردیم، همراستا است و نشان میدهد مدیریت دادههای تکراری در محیطهای AI چقدر پیچیده است.
یک انسان با دیدن نام یک شرکت خدمات شهری در یک طرف و نام اپراتور شبکه در طرف دیگر، در حالی که پینها روی نقشه چند متر با هم فاصله دارند، فوراً متوجه نقص مفهوم میشد. در واقع، نوشتن تست زمانی بود که مفهوم برای اولین بار با دادهها برخورد میکرد. وقتی زحمت نوشتن دستی حذف شد، آن لحظهٔ حیاتیِ کشف خطا نیز از بین رفت.
چارچوب جدید بازبینی
برای جلوگیری از این اتفاق، توسعهدهنده یک فرآیند بازبینی چندسطحی برای تغییرات تولید شده توسط هوش مصنوعی اجرا کرد. او پذیرفت که ۲۰ قدم «صحیح» میتواند یک ایده «غلط» را تا مسافت زیادی پیش ببرد. حتی اگر هر تغییر کوچک تمیز باشد، پیشفرض موروثی میتواند مرگبار باشد. این رویکرد تأکیدی است بر اینکه سختگیریهای سیستمی و گیتهای ساختاری در استقرار AI اغلب کارآمدتر از تکیه بر شهود انسانی یا اعتماد مطلق به مدلها هستند.
اندازهگیری نتایج
- سنجش خروجی: بهجای درخواست «حفظ رفتار»، حالا توسعهدهنده عدد میخواهد. مثلاً: «یک snapshot از محیط عملیاتی بگیر و بگو کاربر چند مورد تکراری میبیند».
- اعتبارسنجی خارجی: نتیجه با واقعیت چک میشود. در این مورد، عدد یکسوم بود که منجر به چهار روز تلاش برای جایگزینی سیستم با روشی شد که بر اساس فاصله و نام خیابان تطبیق میدهد و به ترتیب اجرا وابسته نیست. دو اصلاحیه دیگر نیز پس از آن آمد که هر دو از طریق اجرای آزمایشی (Dry Run) روی دادههای واقعی کشف شدند.
مقاومسازی کد
- دادههای واقعی: هر کدی که دنیای بیرون را مدل میکند، باید حداقل یک نمونه داده واقعی از محیط عملیاتی داشته باشد. دادههای ساختگی کد را تست میکنند، اما دادههای واقعی «ایده» را تست میکنند.
- تست تهاجمی: بازبینها خلاصهی عامل را بهعنوان یک «ادعا» میبینند، نه «مدرک». برای مثال، یکی از تغییرات در این داستان، مجموعهای از تستهای کاربردی را توصیف میکرد که در واقع وجود نداشتند. توسعهدهنده حالا کد را در IDE باز میکند، فراخوانیها را دنبال میکند، نقاط توقف (breakpoints) میگذارد و منطق را مورد حمله قرار میدهد. او برای لیستهای خالی، فراخوانیهای دوم، تایماوتها و خطاهایی که ثبت شده اما نادیده گرفته شدهاند، تست میگیرد.
- نامگذاری و حذف: اگر توسعهدهنده نتواند نامی بهتر از نام پیشنهادی عامل برای یک تابع پیدا کند، یعنی آن را بهاندازه کافی نفهمیده و نباید تاییدش کند. از آنجایی که کدهای تولید شده اغلب بیش از حد کامل هستند، او بهدنبال بخشهایی میگردد که بتوان آنها را حذف کرد.
- تردید در پوشش تست: برای هر تست، این سوال پرسیده میشود: «اگر رفتاری که برایم مهم است خراب شود، آیا این تست واقعاً شکست میخورد؟» اگر پاسخ منفی باشد، تست فقط یک مستند است، نه یک حفاظ.
نقشهبرداری بصری و طراحی
- نقشهبرداری بصری: توسعهدهنده از عاملها برای رسم نمودارهای جریان داده (data-flow diagrams) از کل سرویس استفاده میکند. یک نمودار از این پردازش حذف تکراریها نشان میداد که ۶ جعبه با ترتیب ثابت وجود دارد که هر کدام فقط یک فیلد دقیق را مقایسه میکنند.
- شناسایی هشدارها: او حالا بهدنبال کامنتهای «عذرخواهانه» با حروف بزرگ میگردد؛ عباراتی مثل «MUST stay last» (باید آخرین بماند)، «workaround» (راهکار موقت) یا «for now» (فعلاً). اینها نشانههایی هستند که طراحی در برابر کد مقاومت کرده و کد با زور پیش رفته است. در جولای، جدیدترین بخش کد چنین کامنتی داشت: «MUST stay last». این یک هشدار طراحی بود که در ظاهر شبیه دقت به نظر میرسید، اما در واقع سیگنالی از یک نقص بود.
هزینهٔ زمانِ ذخیره شده
عاملهای هوش مصنوعی سرعت را بهشدت بالا بردند. در طول تابستان، میانگین تغییرات در مخازن روی ۳۵ خط باقی ماند اما تعداد تغییرات بیش از دو برابر شد. با این حال، توسعهدهنده هشدار میدهد که صرف این زمان ذخیره شده برای ساخت ویژگیهای بیشتر، یک اشتباه است.
بیشتر این زمان معمولاً صرف ویژگیهای جدیدی میشود که چون خلاصهشان خوب خوانده میشود، پذیرفته میشوند. او استدلال میکند که این زمان باید صرف یک سطح بالاتر شود: تحلیل اینکه سیستم چه پیشفرضی درباره دنیا دارد، دادهها از کجا میآیند و کدام قوانین به کدام وابسته هستند. این نوع تفکر پیش از این گران بود و معمولاً فقط وقتی چیزی «آتش گرفته بود» انجام میشد.
تجربه اکنون با توانایی نوشتن کد تعریف نمیشود، بلکه با توانایی «شکستن ایده» پشت کد تعریف میشود؛ پیش از آنکه ۲۰ قدم «صحیح» هوش مصنوعی، برجی روی یک پیریزی غلط بسازد. یک عامل میتواند کل سرویس را در چند دقیقه بخواند و جریان داده، ترتیب یک پردازش شبانه و اینکه کدام جزء به کدام ورودی اعتماد میکند را رسم کند. اما نمیتواند بگوید تصویر غلط است، چون نمیداند در دنیای واقعی، برخی نامها هرگز با هم مطابقت ندارند.
این تغییر نشان میدهد نقش مهندس ارشد از یک «بازبین کد» به یک «حسابرس مفهومی» تغییر کرده است؛ کسی که مدل ذهنی هوش مصنوعی از دنیا را در برابر دنیای واقعی اعتبارسنجی میکند. موثرترین بازبینی، همانطور که در این مورد کشف شد، صرفاً نگاه کردن به محصول نهایی است؛ ارزانترین بازبینی که پیش از این کمتر از همه انجام میشد.
گام بعدی شما
- در بازبینی کدهای تولید شده توسط AI، بهجای تکیه بر تستهای خودِ مدل، یک نمونه داده واقعی (Production Data) را به عنوان معیار قرار دهید.
- در پرامپتهای بهینهسازی، بهجای عبارات کلی مثل «حفظ رفتار»، خروجیهای عددی و قابل اندازهگیری بخواهید.
- در کدها بهدنبال کامنتهای هشداردهنده یا «راهکارهای موقت» (workarounds) بگردید؛ اینها نقاط ضعف معماری هستند که AI سعی کرده آنها را بپوشاند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو