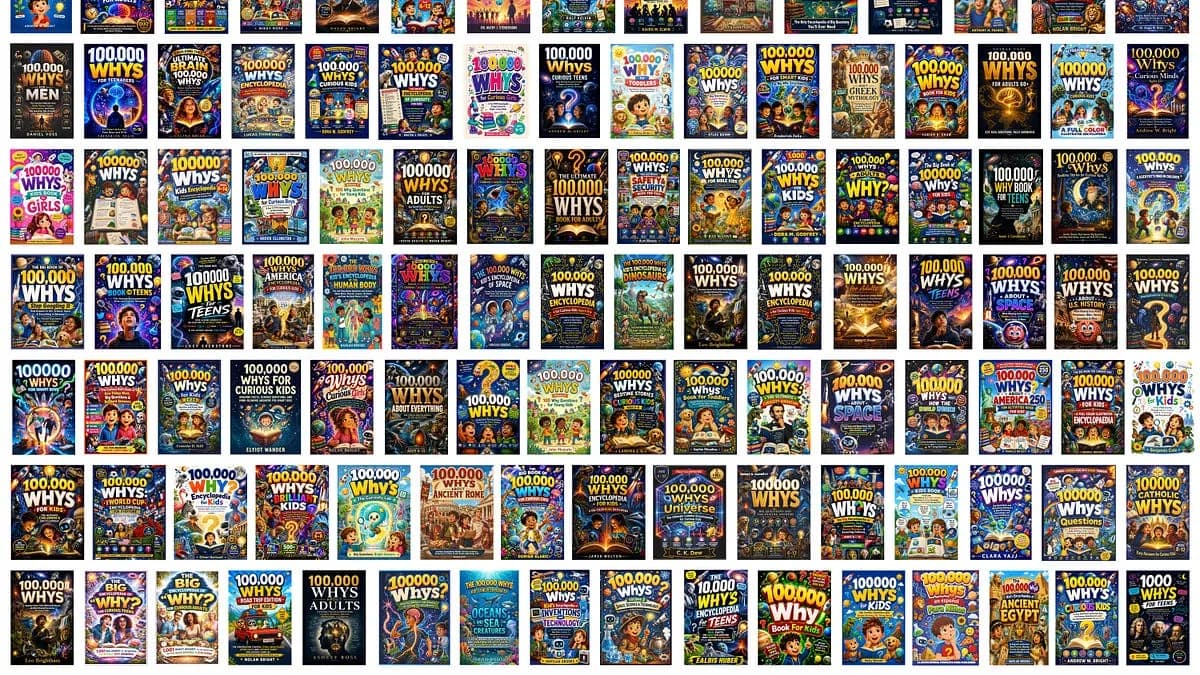
تصور کنید صدها نویسنده مختلف، همگی کتابهایی با محتوای تقریباً یکسان را همزمان وارد بازار کنند؛ این دقیقاً همان اتفاقی است که اکنون در بخش کتابهای غیرداستانی آمازون میافتد. اگر شما هم از هوش مصنوعی برای تولید محتوا استفاده میکنید، باید بدانید که خروجیهای شما احتمالاً تکراریتر از آن است که تصور میکنید.
بر اساس گزارش lcamtuf.substack.com، بررسی نتایج جستوجوی عبارت «۱۰۰ هزار چرا» (100,000 whys) در تاریخ ۲۱ ژوئن ۲۰۲۶، نشان میدهد بسیاری از این کتابها — حتی برخی از پرفروشترینهای ادبیات کودک — ساختار DNA یکسانی دارند. این آثار نتیجهی استفاده از ابزارهای «شبهقطعی» هستند؛ یعنی نویسندگان مختلف با استفاده از پرامپتهای یکسان، در ۸۰٪ مواقع نتایجی عملکردی یکسان دریافت میکنند.
مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — در اینجا دچار یک بنبست شده است. همانطور که در تحلیلهای پیشین ما دربارهی «توهمات مدلهای زبانی» اشاره کردیم، مشکل این بار نبودِ واقعیت نیست، بلکه نبودِ تنوع است. برای مقابله با این چالش، برخی رویکردهای جدید مانند تکنیک دفع معنایی تلاش میکنند تا تنوع خروجیهای مدلها را به طور چشمگیری افزایش دهند.
طبق این گزارش، شواهد در خوشههای بصری و متنی نهفته است. برای نمونه:
- دستهای از جلدها همگی تصویری از یک دایناسور خشمگین در گوشه بالا-چپ دارند.
- موشکهای کارتونی قرمز و سفید در کتابهای مختلف تکرار شدهاند.
- تصاویر سگهای گلدن ریتریور یا شیرها در عناوینی که ظاهراً متفاوتاند، عیناً تکرار شدهاند.
این الگوها به این دلیل شکل میگیرند که مدلهای زبانی برخلاف انسانها، تکیههای زبانی و عادتهای رفتاری فردی ندارند. در عوض، در پاسخ به هر پرامپت معمولی، به سراغ مجموعهای پیچیده اما ثابت از الگوها میروند. این وضعیت یک «سیگنال مبهم» ایجاد میکند که به چشمهای آموزشدیده اجازه میدهد تنها با تکیه بر شهود، محتوای تولیدشده توسط AI را تشخیص دهند.
برای خواننده عادی، این یعنی هزینه تولید محتوا به شدت کمتر از هزینه مصرف و تحلیل آن شده است. وقتی هزاران «نویسنده» میتوانند دستهبندیهای مرجع را با کتابهای تکراری اشغال کنند، مدل سنتی اعتماد آنلاین فرو میپاشد. این بحران تولید محتوای یکسان، تفاوت بنیادینی میان ابزارهای متکی به قالبهای ایستا و سیستمهای پیشرفتهتر عاملمحور را در مدیریت اسناد ایجاد میکند.
اگر از یک مدل زبانی برای اتوماسیون وبلاگنویسی یا نشر استفاده میکنید، در معرض این خطر هستید. اثر کار شما شاید از نظر فنی درست باشد، اما بدون یک «لنگر انسانی» منحصربهفرد، اثرتان در میان نویز کتابهای «۱۰۰ هزار چرا» گم خواهد شد.
گام بعدی شما
- هنگام تولید محتوا، از مدل بخواهید «ضد-الگوهای» (anti-patterns) رایج در آن موضوع را شناسایی و از آنها دوری کند.
- برای خروج از تکرار، از ترکیب چند مدل با معماریهای متفاوت برای بازنویسی متن استفاده کنید.
- منتظر استانداردهای جدید متادیتای آمازون برای شناسایی محتوای سنتتیک باشید.
نبرد شناسایی AI اکنون از شکار «کلمات کلیدی» به تشخیص الگوهای سیستمی تکرار تغییر مسیر داده است؛ اما اثر این موج بر اقتصاد نشر را در گزارش بعدی بررسی خواهیم کرد.


گفتگو