
تصور کنید یک چهره کاملاً یخزده را میبینید که تنها لبهایش با دقت میلیمتری تکان میخورند؛ این تضاد بصری بهجای ایجاد حس واقعگرایی، باعث ایجاد حسی آزاردهنده در مخاطب میشود که کل ویدیوهای ساخته شده با هوش مصنوعی را تخریب میکند. در ۲۴ سپتامبر ۲۰۲۶، یک راهنمای فنی در dev.to افشا کرد که مشکل اصلی کلیپهای «سرِ سخنگو» (Talking-head) و پدیده «دره وهمناک» (Uncanny Valley)، نه در همگامسازی لبها، بلکه در فقدان حرکات ارگانیک است.
این یافتهها در ادامه پوششهای پیشین ما دربارهی TalkPix AI و تبدیل پرترهها به ویدیوهای ۱۰۸۰p قرار میگیرد و نشان میدهد صنعت اکنون از «همگامسازی صرف» به سمت «حرکت ارگانیک» تغییر مسیر داده است. این تحول در واقع تکامل همان رویکردی است که در قابلیتهای رندرینگ عصبی TalkPix برای جایگزینی اقتصادی استودیوها بررسی کرده بودیم. اکثر ابزارهای مدرن زمانبندی لبها را حل کردهاند، اما در بازسازی ریز-حرکات — مانند پلکزدن، شیب سر و تکانهای شانه — که سیگنالهای حیاتی زنده بودن یک انسان هستند، شکست میخورند.
ریشه توهم بصری
به نقل از گزارش dev.to، توهم زندگی زمانی میشکند که محیط اطراف دهان کاملاً ساکن بماند. نویسنده این گزارش تجربه اولین تلاش خود را توصیف میکند که در آن همگامسازی لبها کاملاً بینقص بود، اما ویدیو همچنان «غلط» و غیرطبیعی به نظر میرسید. او تنها با بررسی فریمبهفریم متوجه شد که دهان درست کار میکند، اما بقیه صورت مرده است.
این موضوع تعریف مسئله را تغییر میدهد: شما دیگر در حال عیبیابی همگامسازی (Sync) نیستید، بلکه در حال عیبیابی حرکت (Motion) هستید. این حرکات توسط دادههایی که به مدل میدهید هدایت میشوند. توهم واقعگرایی به دلیل سه نقص خاص در ورودیها میشکند:
- عکسهای منبع صلب: یک پرتره خشک، مستقیم و رسمی، هیچ فضای مانوری برای مدل فراهم نمیکند تا بتواند حرکات طبیعی را بر اساس آن بسازد.
- صوت تخت: صدای یکنواخت، بدون احساس و ویرایشنشده، حرکاتی یکنواخت تولید میکند؛ در حالی که تأکیدها، تغییرات لحن و ضربآهنگ صداست که حالتهای چهره را به حرکت در میآورد.
- برداشتهای طولانی: تکهای طولانی و یکسره تمایل دارند دچار لغزش شوند یا بهصورت عجیب و تکراری (Loop) عمل کنند. در مقابل، قطعات کوتاه و تمیز کیفیت خود را بهتر حفظ میکنند.
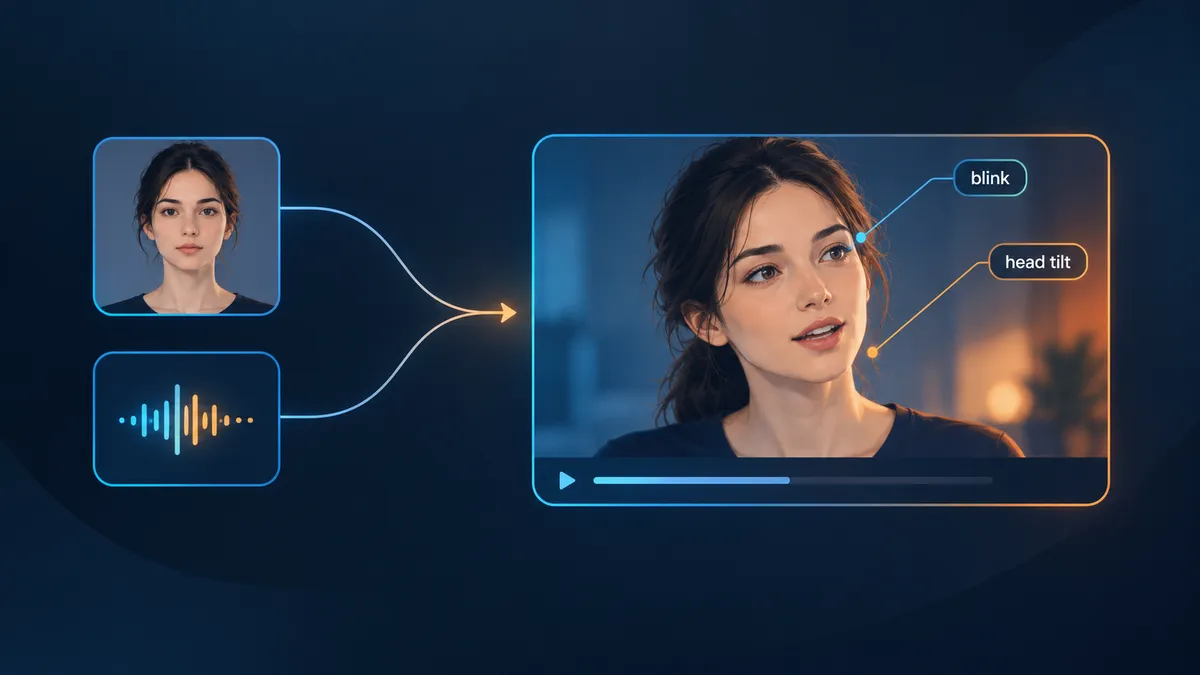
راهکارهای فنی برای حرکت طبیعی
برای حل این مشکلات، نویسنده یک خط لوله (Pipeline) پیش-تولید را پیشنهاد میکند که از دو اسکریپت خاص برای پاکسازی ورودیها پیش از رسیدن به مدل هوش مصنوعی استفاده میکند. این فرآیند تضمین میکند که هوش مصنوعی به «نویز» موجود در دادهها واکنش نشان ندهد.
آمادهسازی صوت
صوت باید بهطور کامل از سکوتهای زائد پاک شود. وجود سکوت در ابتدای فایل، سطوحی که بیش از حد آرام هستند یا کلیکهای مزاحم صوتی، در خروجی بهصورت زمانهای مرده یا «پرشهای» ناگهانی (Flinch) در حرکت ظاهر میشوند. اسکریپت audio_prep.sh با استفاده از ffmpeg، سکوتهای ابتدا و انتها را میبرد و بلندی صدا را به استاندارد پخش (Broadcast Standard) با مقادیر (I=-16, TP=-1.5, LRA=11) میرساند.
این اسکریپت برای دستیابی به این هدف، ابتدا فایل را معکوس میکند، سکوتها را حذف میکند و سپس دوباره آن را به حالت اول برمیگرداند. این روش سیگنالی بسیار تمیزتر برای انیمیت کردن به مدل میدهد و ریسک مکثهای ناشی از خطای داده در لبههای کلیپ را حذف میکند. در واقع، مدیریت دقیق سکوتها و ضربآهنگ، همان کلیدی است که در تحلیل سیستمهای کپشننویس هوشمند برای کاهش خطا به اهمیت آن اشاره کرده بودیم.
تکهبندی متن
متون طولانی نباید بهصورت یک بلوک واحد وارد شوند، بلکه باید به تکههای کوچکتر تقسیم گردند. با استفاده از اسکریپت پایتون script_split.py میتوان متن را دقیقاً بر اساس مرز جملات تقسیم کرد.
- کالیبراسیون WPM: این اسکریپت از نرخ کلمات در دقیقه (WPM) — که بهصورت پیشفرض روی ۱۵۰ کلمه تنظیم شده — برای تخمین زمان استفاده میکند. نویسنده اشاره میکند که مقدار
--wpmباید با سرعت واقعی گوینده مطابقت داشته باشد؛ برای example، یک خوانش آرام و متفکرانه نیازمند عدد پایینتری است. - محدودیت زمانی: پیشفرض اسکریپت روی محدودیت
--max-seconds 20تنظیم شده است.
با این تکهبندی، هر بخش به یک تولید مجزا تبدیل میشود و از «سردرگمی» یا «پرسه زدن» مدل در برداشتهای طولانی جلوگیری میشود.
گردش کار تولید
این راهنما پلتفرم VOKOO را توصیه میکند؛ یک پلتفرم خلق محتوای چند-مدلی با شعار «بیشتر خلق کنید، کمتر جابهجا شوید». VOKOO برای مواردی طراحی شده که یک «ارائهدهنده» (Presenter) باید پیام را منتقل کند، نه یک محصول. مراحل کار عبارت است از:
۱. انتخاب منبع: استفاده از عکسی با چرخش جزئی سر یا حالت طبیعی. این کار به مدل اجازه میدهد تا بیش از یک عکس پاسپورتی، حرکات بیشتری را انیمیت کند.
۲. بهبود: استفاده از ویرایشگرهای داخلی هوش مصنوعی و ابزارهای بزرگنمایی (Upscaling) برای تبدیل تصاویر کوچک یا تار به تصاویری شفاف و قابل استفاده، بدون نیاز به خروج از محیط کاری.
۳. تکرار مدل: اگر ریز-حرکات همچنان خشک بودند، از طریق عامل (Agent) بین مدلهای مختلف جابهجا شوید؛ برخی مدلها بهصورت پیشفرض ریز-حرکات طبیعیتری را اضافه میکنند.
۴. مدیریت هزینه: پیشنمایش هزینه اعتبار (Credit) برای هر تکه. از آنجایی که کاربران بهجای کل متن، بهازای هر کلیپ پرداخت میکنند، نویسنده پیشنهاد میکند ابتدا تکه اول را با مشخصات کیفیت پایینتر تست کنید تا از ترکیب درست عکس و صدا مطمئن شوید و سپس برای بقیه بخشها کیفیت کامل را فعال کنید.
برای کسانی که میخواهند متنها را پیش از تکهبندی به جملاتی موجزتر و ضربآهنگدارتر تبدیل کنند، RouteAI پیشنهاد شده است؛ یک درگاه API سازگار با OpenAI که دسترسی مقرونبهصرفه به چندین مدل زبانی بزرگ (LLM) فراهم میکند.
تحلیل تحریریه
این تغییر دیدگاه، هدف بنیادین تولید آواتارهای هوش مصنوعی را تغییر میدهد. ما در حال حرکت از ذهنیت «همگامسازی» به سمت ذهنیت «اجرا» (Performance) هستیم. برای سازندگان، این یعنی کیفیت خروجی اکنون بیشتر به آمادهسازی داراییها (Assets) وابسته است تا قدرت پردازشی خودِ مدل.
این رویکرد در کنار مدلهای سادهتر تبدیل تصویر به ویدیو قرار میگیرد. در حالی که یک دموی محصول بدون چهره، راه سریعتری برای انیمیت کردن یک شیء است، ویدیوهای سخنگو بهطور خاص برای پیامرسانیهای انسانمحور هستند. این تمرکز بر اجرای طبیعی، مشابه رویکردی است که آمازون برای تطبیق دقیق دوبله با حرکات بازیگران در Prime Video به کار گرفته است. اگر از سخنگویان مجازی استفاده میکنید، پیام روشن است: دست از عیبیابی دهان بردارید و عیبیابی حرکت را شروع کنید. عنصر «انسانی» در شکافهای بین کلمات — پلکزدنها و نفس کشیدنها — زندگی میکند، نه در خودِ کلمات.
برای تست این متد در امروز، این توالی دقیق را امتحان کنید: یک ضبط صدای واقعی را از طریق audio_prep.sh پاکسازی کنید، یک متن کوتاه را با script_split.py --max-seconds 15 تقسیم کنید و اولین تکه را در VOKOO با استفاده از عکسی با حالت طبیعی تولید کنید. پیش از تولید تکههای باقیمانده، هزینه تخمینی را بررسی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو