اگر تصور میکنید هرچه دادههای بیشتری به مدل بدهید، پاسخهای دقیقتری میگیرید، احتمالاً در تلهٔ «توهمِ ظرفیت» افتادهاید. در بسیاری از محیطهای عملیاتی، گسترش بیش از حد زمینه باعث میشود مدل در میان انبوه اطلاعات، رشتهٔ استدلال را گم کند. این پدیده نشان میدهد که تغذیه کردن مدل با دادههای بیشتر، لزوماً تضمینکننده پاسخهای بهتر نیست؛ در واقع در بسیاری از موارد تولیدی، زمینه (Context) بیشتر منجر به خروجیهای بدتر میشود. این تضاد میان ظرفیت اسمی و کارایی عملی، همان چیزی است که در تحلیل ما درباره شکاف ظرفیت و کیفیت در پنجرههای متنی بزرگ به تفصیل بررسی کردیم.
به نقل از گزارشی در ۱ سپتامبر ۲۰۲۶ در وبسایت dev.to، شکاف عمیقی میان توانایی فنی مدل برای «نگهداری» توکنها و توانایی آن برای «استدلال» روی آنها وجود دارد. پنجرهٔ زمینه (Context Window) — شبیه میز کاری است که جا برای چند ورق دارد، نه برای کل کتابخانه — و وقتی این میز بیش از حد شلوغ شود، یافتن یک حقیقت کلیدی دشوار میشود. همانطور که در بحثهای گذشتهی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، مدیریت ورودیها همواره نقطهٔ ضعف مدلهای ترنسفورمر بوده است.
تصور کنید میخواهید یک جمله خاص را در کتابی ۳۰۰ صفحهای پیدا کنید؛ با اینکه کل کتاب پیش روی شماست، اما حجم عظیم متنهای بیربط، تمرکز روی آن یک حقیقت مهم را سخت میکند. این دقیقاً همان چالشی است که ترنسفورمرها (Transformer) هنگام گسترش پنجرهٔ زمینه به ۱، ۲ یا حتی ۱۰ میلیون توکن با آن دستوپنجه نرم میکنند. در این مقیاس، حجم متنهای غیرضروری مانع از تمرکز مدل بر روی تکه اطلاعاتی میشود که واقعاً اهمیت دارد.
بر اساس بررسیهای Chroma و Anthropic، صحت استدلال با رشد زمینهٔ اطراف کاهش مییابد. این اتفاق به معنای «فراموش کردن» دادهها توسط مدل نیست، بلکه به دلیل فروپاشی نسبت سیگنال به نویز رخ میدهد. مدل باید سیگنالهای مفید را از میان حجم فزایندهای از اطلاعات بیربط تشخیص دهد و هرچه این حجم بیشتر شود، تفکیک سیگنال از نویز دشوارتر میگردد. این چالشهای عملیاتی اغلب با هزینههای پنهان و محدودیتهای فنی پنجرهٔ زمینه گره خورده است که بهرهوری مدل را تحت تأثیر قرار میدهد.
شکست محکهای فعلی
بسیاری از آزمایشگاههای هوش مصنوعی برای بازاریابی پنجرههای زمینهٔ بزرگ خود، به آزمونهای «سوزن در انبار کاه» (Needle-in-a-haystack) تکیه میکنند. این تستها فقط بازیابی ساده را میسنجند؛ یعنی پیدا کردن یک حقیقت مشخص در دریایی از متن. اما وظایف دنیای واقعی نیازمند سنتز (ترکیب) هستند، مواردی مثل:
- یافتن سه تکه اطلاعات مجزا از بخشهای مختلف سند.
- درک رابطه منطقی و ارتباط میان این تکهها.
- استفاده از این سنتز برای اتخاذ یک تصمیم پیچیده یا پاسخ به یک پرسش تحلیلی.
یک مدل میتواند در محک بازیابی نمره کامل بگیرد، اما در استدلالهای چندنقطهای کاملاً شکست بخورد. پیدا کردن یک سوزن با درک ساختار انبار کاه متفاوت است؛ بازیابی صرف به معنای درک محتوا نیست.
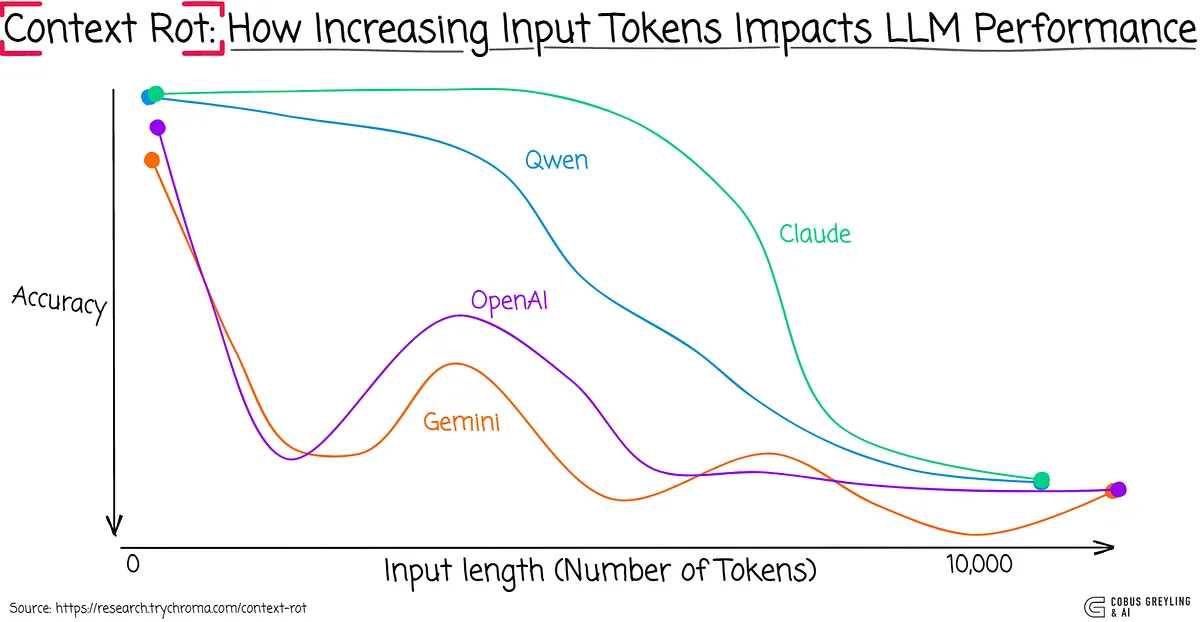
اثر «گمشده در میانه»
ترنسفورمرها سوگیری مستندی دارند که در آن اطلاعات ابتدا و انتهای پرامپت را قابلاعتمادتر از مرکز بازیابی میکنند. اگر دادههای حیاتی در وسط یک سند بزرگ دفن شده باشند، سیستم ممکن است با وجود دسترسی فنی به توکن درست، بهطور خاموش پاسخ اشتباهی بدهد یا اطلاعات را نادیده بگیرد.
این یک خطای محاسباتی ساده یا یک خطای گرد کردن (Rounding error) نیست؛ بلکه تفاوت میان یک دموی خیرهکننده برای مدیران و یک سیستم عملیاتی است که در دنیای واقعی شکست میخورد. مدل ممکن است از نظر فنی به اطلاعات دسترسی داشته باشد، اما نمیتواند بهطور قابلاعتمادی از آن برای پاسخدهی استفاده کند.
محدودیتهای معماری
این مسئله پیامد معماری مکانیزم توجه (Attention) است، نه باگی که بهسادگی وصله شود. در این ساختار، توکنها برای تعیین میزان ارتباط، به توکنهای دیگر «توجه» میکنند. با رشد ورودی، تعداد روابطی که مدل باید روی آنها استدلال کند، بهصورت تصاعدی افزایش مییابد.
در واقع مکانیزم دقیقاً همان کاری را میکند که برایش طراحی شده، اما در مقیاسی که نسبت سیگنال به نویز علیه کاربر عمل میکند. مشکل این نیست که مدل «به اندازه کافی باهوش نیست»، بلکه ما اطلاعاتی بیش از حد توان استدلالِ قابلاعتمادِ آن به او میدهیم و باعث میشویم مدل در تحلیل روابط پیچیده غرق شود.
فراتر از RAG ساده
تولید بازیابیافزا (RAG) — مثل دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — راهکار استاندارد است، اما آن هم نقاط ضعفی دارد. اگر سیستم چندین تکه «تقریباً مرتبط» را بازیابی کند، همان مشکل رقیقشدن اطلاعات را بازتولید میکند و مدل را با نویزهای جدید مواجه میسازد. برای حل این بنبست، برخی رویکردها به جای حافظه خطی، بر استفاده از ذخیرهسازهای معنایی برای حفظ دستورات تمرکز کردهاند تا دسترسی به اطلاعات کلیدی بهینهتر شود.
در یک سیستم بازیابی دستورالعمل برای استانداردهای کدنویسی که هدفش اعمال قوانین پیش از تولید کد است، چالش اصلی نه بازیابی، بلکه رتبهبندی (Ranking) است. سیستم باید میان این موارد تمایز قائل شود:
- تکههای بسیار مرتبط (Highly relevant)
- تکههای نسبتاً مرتبط (Partially relevant)
- تکههایی با شباهت ظاهری اما بیمحتوا (Superficially similar)
- تکههای کاملاً بیربطه (Completely irrelevant)
ارسال ده تکه «تقریباً مرتبط» در کنار یک تکه حیاتی، کار مدل را سختتر میکند و احتمال خطا را بالا میبرد. کیفیت بازیابی به همان اندازه به «آنچه حذف میکنید» وابسته است که به «آنچه اضافه میکنید».
مسیرهای آینده در زمینه
رویکردهای جدیدی مثل مهندسی زمینه (Context Engineering) و مدلهای زبانی بازگشتی (Recursive Language Models) در حال تغییر تمرکز هستند. پژوهشگران بهجای پرسش درباره نحوه جای دادن توکنهای بیشتر، میپرسند مدلها چگونه باید اطلاعات را برای استدلال بهتر جذب، فشرده و سازماندهی کنند.
این رویکردها این فرض را به چالش میکشند که راه حل محدودیتهای زمینه، صرفاً «زمینه بیشتر» است. آنها مسئله را نه یک بحث ظرفیت خام، بلکه مسئله سازماندهی و فشردهسازی میبینند تا مدل بتواند روی ساختارهای منظمتر استدلال کند.
برای توسعهدهندگان، معیار حیاتی دیگر این نیست که مدل چقدر زمینه را «پذیرفته»، بلکه این است که چقدر از آن را «بهطور قابلاعتمادی استفاده میکند». سام آلتمن از آیندهای گفته است که هوش مصنوعی زمینه کاملی از کل زندگی کاربر دارد، اما امروز شکاف بزرگی میان این وعده و توانایی ترنسفورمر در مدیریت دهها هزار توکن وجود دارد.
بیشتر باگهای سیستمهای زمینه-بلند در محیط عملیاتی از همین شکاف ریشه میگیرند. منتظر ظهور مدلهای بازگشتی باشید که با زمینه بهمثابه یک پایگاهداده ساختاریافته برخورد میکنند، نه یک جریان تخت و خطی از توکنها.
گام بعدی شما
- در طراحی سیستمهای RAG، بهجای افزایش تعداد تکههای بازیابیشده (Top-K)، روی پیادهسازی یک لایه بازرتبهبندی (Reranking) دقیق تمرکز کنید.
- دادههای حیاتی و دستورالعملهای کلیدی را در ابتدا یا انتهای پرامپت قرار دهید تا اثر «گمشده در میانه» را خنثی کنید.
- برای ارزیابی مدلهای خود، بهجای تستهای بازیابی ساده، سناریوهای سنتز اطلاعات را طراحی کنید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو