
تصور کنید برای اثبات انسان بودنتان، مجبور باشید ساعتها به دنبال عکسهای چراغ راهنما بگردید در حالی که یک مدل هوش مصنوعی این کار را در میلیثانیهها انجام میدهد. این واقعیت تلخ باعث شده تا عصر کلیک روی تصاویر برای عبور از سدهای امنیتی به پایان برسد. طبق بینش اصلی Browserbase، «هر چالشی که پاسخ درستی داشته باشد، در نهایت تبدیل به هدفی برای بهینهسازی توسط هوش مصنوعی میشود.» این حقیقت توضیح میدهد که چرا دوران کلیک روی شیرهای آتشنشانی برای اثبات انسان بودن به بنبست رسیده است. طبق اعلام Browserbase، تا ۲۴ ژوئن ۲۰۲۶، صنعت وب از پرسش درباره «تواناییهای مرورگر» به سمت «تأیید هویت واقعی مرورگر» حرکت کرده است. این تغییر یعنی کپچاهای (CAPTCHA) سنتی دیگر عملاً شکست خوردهاند و از نظر بنیادین ناکارآمد شدهاند.
برای درک این تحول، باید وب را به چشم یک تمرین بزرگ اعتماد ببینید. دههها بود که وبسایتها با هر اتصال ورودی مانند یک غریبه ناشناس برخورد میکردند. در این مدل، وبسایتها فرض میکردند هر کسی که وارد میشود ممکن است یک مهاجم باشد. تنها راه اعتماد به کاربر، ایجاد یک چالش بود که ماشین قادر به حل آن نباشد. این وضعیت منجر به یک بازی دائمی موش و گربه شد؛ جایی که مدافعان دیواری میساختند و مهاجمان همواره راهی برای عبور از روی آن یا تخریب آن مییافتند.
زمینه اتوماسیون و تاریخچه
با رشد وبسایتها در اواخر دهه ۱۹۹۰، انگیزهها برای سوءاستفاده از آنها نیز به همان نسبت افزایش یافت. اسپمرها هزاران حساب کاربری جعلی ساختند، اسکریپتها تالارهای گفتگو را با تبلیغات پر کردند و باتها شروع به استخراج دادهها (Scraping) از موتورهای جستوجو کردند. هر سایت محبوبی با یک پرسش حیاتی و وجودی روبرو بود: چگونه میتوان یک انسان را از یک ماشین تشخیص داد؟
در سال ۲۰۰۳، مقالهای توسط لوییز ون آن، مانوئل بلوم، نیکولاس هاپر و جان لنگفورد در دانشگاه کارنگی ملون منتشر شد که اصطلاح کپچا را ابداع کرد. کپچا در واقع یک «بکرونیم» (Backronym) یا واژهای است که برای عبارت «آزمون تورینگ عمومی کاملاً خودکار برای تشخیص کامپیوترها و انسانها از یکدیگر» ساخته شده است.
برخلاف تست تورینگ اصلی که در آن یک انسان سعی میکند از طریق گفتگو بفهمد طرف مقابل ماشین است یا خیر، کپچا یک «تست تورینگ معکوس» است. در این حالت، ماشین سؤال میپرسد و اگر پاسخدهنده مانند یک انسان رفتار کند، تست پاس میشود. هدف از این کار، اثبات هوشمندی یا نبوغ نبود؛ بلکه هدف این بود که هزینه اتوماسیون را چنان بالا ببرند که بیشتر از سود حاصل از حمله باشد و در نتیجه مهاجم منصرف شود.
اینترنت اولیه را تصور کنید که در آن باتها اسکریپتهای سادهای برای ارسال اسپم بودند. در آن دوران، نمایش چند حرف کج و کوله برای متوقف کردن یک ماشین کافی بود. اما با تکامل هوش مصنوعی، قابلیتهای «صرفاً انسانی» — مثل خواندن متنهای تغییر شکل یافته یا شناسایی یک اتوبوس در یک عکس — دقیقاً به همان چیزهایی تبدیل شدند که مدلهای هوش مصنوعی برای تسلط بر آنها آموزش میدیدند.
شکست چالشهای بصری
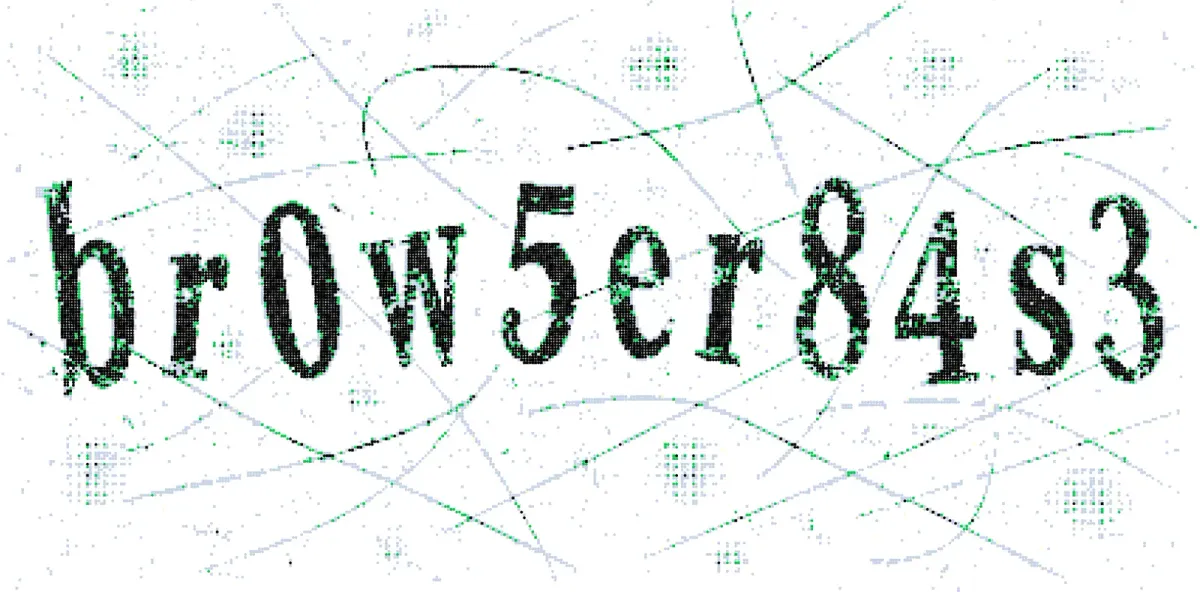
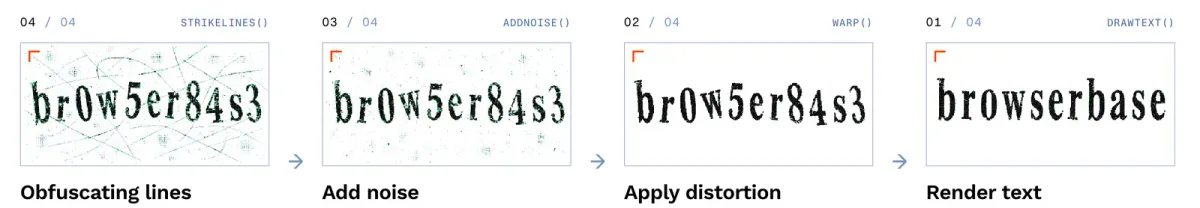
کپچاهای اولیه بر این فرض استوار بودند که کامپیوترها نمیتوانند متنهای دگرگون شده (Distorted Text) را پردازش کنند. این چالشها دارای ویژگیهایی چون حروف کج، فاصلههای نامنظم بین کلمات، خطوط تصادفی روی متن و پسزمینههای نویزدار بودند. برای انسان این کار راحت بود چون مغز ما الگوها را حتی با وجود پیکسلهای گمشده تشخیص میدهد. اما برای کامپیوترهای آن دوران، زمانی که کاراکترها میچرخیدند، کشیده میشدند یا روی هم میافتادند، پردازش دشوار میشد. تئوری این بود که «ادراک» (Perception) سختترین بخش است؛ اگر کامپیوتر نتواند تشخیص دهد کجا یک حرف تمام شده و حرف بعدی شروع میشود، نمیتواند کلمه را بخواند.
این رویکرد توسط غولهای اولیه وب مانند AltaVista و Yahoo پذیرفته شد. این روش تا زمانی کار میکرد که مهاجمان متوجه شدند نیازی نیست کل کپچا را یکباره حل کنند. آنها خط لولههای بینایی کامپیوتری ساختند که فرآیند خلق کپچا را به صورت معکوس اجرا میکرد: ابتدا نویز پسزمینه را حذف میکردند، تصاویر را به سیاه و سفید (Thresholding) تبدیل میکردند و سپس کاراکترها را به نواحی جداگانه برای نویسهخوانی نوری (OCR) تقسیم میکردند. آنچه زمانی یک مسئله پیچیده هوش مصنوعی بود، به یک مسئله سادهی پردازش تصویر تبدیل شد.
در پاسخ به این موضوع، مدافعان متنها را دشوارتر کردند و این امر منجر به خلق reCAPTCHA شد. لوییز ون آن متوجه شد میلیونها نفر هر روز ثانیههای زیادی را صرف حل این پازلها میکنند—که حجم عظیمی از کار شناسایی بصری بود که معمولاً هدر میرفت. او سیستم را تغییر داد تا کلمات اسکنشده از کتابها و آرشیوهای قدیمی را که OCRهای آن زمان قادر به خواندنشان نبود، نمایش دهد. با این کار، هر پاسخ صحیح توسط انسان به دیجیتالی شدن متریالهای تاریخی کمک میکرد؛ وبسایتها محافظت میشدند و کتابخانهها دیجیتالی میشدند.
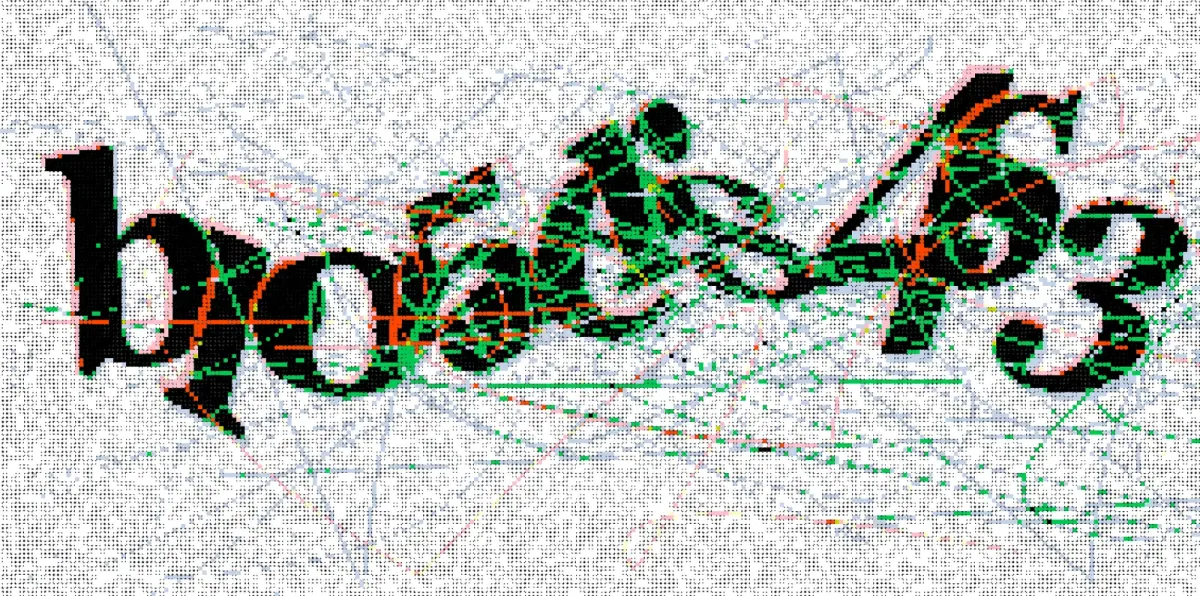
اما ورود یادگیری ماشین (Machine Learning) نیاز به این قوانین مهندسیشدهی دستی را از بین برد. OCRهای سنتی بر اساس تشخیص لبهها و الگوهای ثابت کار میکردند، اما شبکههای عصبی الگوها را از میلیونها نمونه یاد گرفتند. آنها میتوانستند کاراکترهای بهشدت دگرگون شده را بدون نیاز به جداسازی (Segmentation) کامل تشخیص دهند، زیرا نویزها هنوز سیگنال کافی برای مدل فراهم میکردند. در نهایت، این کپچاها برای انسان سختتر از مدلهای هوش مصنوعی شدند.
در اوایل دهه ۲۰۱۰، صنعت به سمت «درک معنایی» (Semantic Understanding) حرکت کرد. به جای حروف، کاربران باید اشیایی مثل چراغ راهنمایی، اتوبوس، خط عابر پیاده یا ویترین مغازهها را شناسایی میکردند. این تست، توانایی انسان در تشخیص یک دوچرخه از زاویهای عجیب، یا زمانی که نیمی از آن پشت یک ماشین پنهان شده یا در نور کم است را میسنجید.
برای کامپیوترها، این در ابتدا یک مسئله «الگوی ثابت» (Template Problem) بود. سیستمهای بینایی سنتی سعی میکردند لبهها، گوشهها و گرادینتها را ترکیب کنند تا با یک الگوی خاص مطابقت دهند. منطق آنها چیزی شبیه به این بود:
detect_edges(image)detect_corners(image)compute_gradients(image)if matches_bicycle_template(features): return "bicycle"
این دفاع زمانی فروپاشید که مجموعه داده ImageNet در سال ۲۰۰۹ منتشر شد و میلیونها تصویر برچسبدار در هزاران دستهبندی را در اختیار پژوهشگران قرار داد. در سال ۲۰۱۲، انتشار AlexNet ثابت کرد که شبکههای عصبی عمیق (Deep Neural Networks) میتوانند از سیستمهای بینایی سنتی پیشی بگیرند. شبکههای عصبی پیچشی (CNN) لبهها را در لایههای اولیه و اشیای کامل را در لایههای عمیقتر، بدون نیاز به الگوهای ثابت، یاد میگرفتند.
از چالشها به امتیازدهی احتمالی
سیستمهای ضدبات مدرن از پرسشهای پاسخمحور دست کشیدند و سراغ این پرسش رفتند که «آیا اصلاً مرورگر باید مورد چالش قرار گیرد یا خیر؟». آنها احتمالی شدند و سیگنالهایی را در طول یک جلسه جمعآوری میکنند تا یک «امتیاز ریسک» (Risk Score) بسازند. این سیگنالها شامل موارد زیر است:
- اثرانگشت دیجیتال (Fingerprinting): اثرانگشت TLS، فونتهای نصب شده روی سیستم و رندرهای Canvas/WebGL.
- محیط: اثرانگشت مرورگر و اعتبار شبکه (Network Reputation).
- رفتار: زمانبندی درخواستها و الگوهای تعاملی کاربر با صفحه.
- تاریخچه: تاریخچه کوکیها و اعتبار دستگاه مورد استفاده.
این همان فلسفه پشت reCAPTCHA v3 و Cloudflare Turnstile است. یک مرورگر کروم واقعی روی یک لپتاپ واقعی، متفاوت از یک نمونه ساخته شده در مرکز داده (Data Center)—یعنی همان ساختمانهای عظیم سرور که مثل مغزهای دیجیتال شهر عمل میکنند—رفتار میکند. وقتی سیستم به کاربر اطمینان داشته باشد، هیچ کپچایی ظاهر نمیشود. اما وقتی تردید وجود داشته باشد، سیستم درخواست اطلاعات یا تایید بیشتر میکند.
اما مهاجمان دوباره تطبیق یافتند. آنها متوجه شدند اگر چالشها فقط زمانی ظاهر میشوند که مرورگر «مشکوک» به نظر برسد، هدف باید این باشد که «غیرمشکوک» به نظر برسند. در نتیجه، حل چالشها به مهندسی اثرانگشت مرورگر تبدیل شد. مهاجمان سیگنالهای شبکه و اعتبار را مطالعه کردند تا با اثر انگشت یک کاربر واقعی ترکیب شوند و در جریان ترافیک عادی وب گم شوند.
گذار به هویت عامل (Agent Identity)
اکنون وارد مرحلهای میشویم که وب باید عاملهای (Agents) هوش مصنوعی قانونی را بپذیرد. وب امروز با دوران ناشناس اسکرپرهای قدیمی متفاوت است. عاملهای مرورگر اکنون در حال رزرو سفر، ثبت گزارشهای انطباقی و نظارت بر زیرساختها برای کاربران واقعی هستند. برخورد با هر بات به عنوان یک مهاجم، دیگر استراتژی قابلقبولی نیست زیرا باعث اختلال در خدمات قانونی میشود. در این مسیر، امنیت دادهها در دست عاملها حیاتی است؛ برای مثال، روش PA-DR توانسته است شدت نشت دادهها در عاملهای پژوهشی را به شکل چشمگیری کاهش دهد تا اعتماد به اتوماسیون افزایش یابد.
در حال حاضر تمرکز از این پرسش که «آیا این مرورگر میتواند کپچا را حل کند؟» به این پرسش تغییر کرده که «آیا این مرورگر اصلاً باید کپچا ببیند؟».
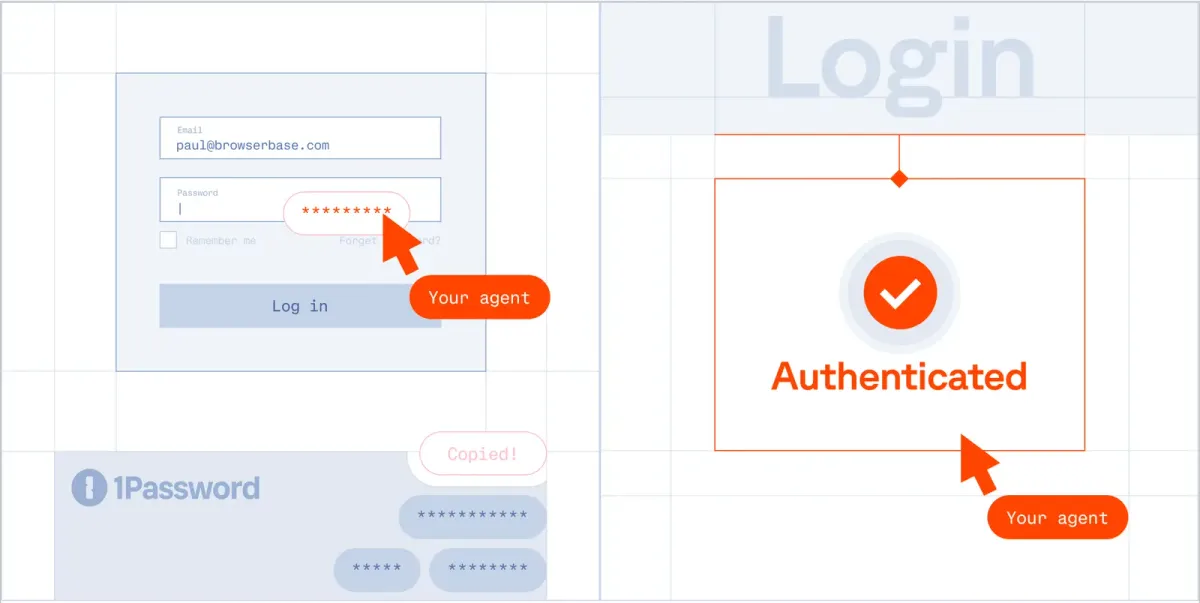
Browserbase در همکاری با Cloudflare در حال اجرای Web Bot Auth است. این یک استاندارد هویت رمزنگاریشده است که به عاملهای مرورگر اجازه میدهد هنگام گشتوزنی در وب، خودشان را معرفی کنند. به جای حدس زدن «خوب» یا «بد» بودن بات بر اساس رفتار (که میتواند تقلید شود)، عامل با یک هویت تأییدشده معرفی میشود. سایتها میتوانند اتوماسیونهای ناشناس را از عاملهایی که از طریق ارائهدهندگان معتبر فعالیت میکنند، با قطعیت تشخیص دهند.
این تغییر، فرض بنیادین امنیت وب را دگرگون میکند. برای بیست سال، باتها سعی میکردند خود را جای انسان جا بزنند تا اجازه دسترسی پیدا کنند. حالا یک عامل قانونی میتواند بهسادگی ثابت کند کیست و نماینده کدام ارائهدهنده معتبر است. این کار نیاز به چالشهای بصری یا رفتاری را بهطور کامل از بین میبرد.
این تحول به نفع کل اکوسیستم است. مالکان وبسایتها پاسخ قطعی درباره هویت دسترسیگیرندگان را میگیرند و توسعهدهندگان هوش مصنوعی دیگر زمان و محاسبات (Compute)—یعنی همان نیروی پردازشی سنگین سختافزارها—را برای دور زدن پازلها تلف نمیکنند. موفقترین «حلکننده» کپچا، کسی است که هرگز کپچایی نبینَد.
با پیچیدهتر شدن گردش کارهای عاملمحور در دنیای واقعی، تمرکز بر مدیریت این هویتهای رمزنگاریشده در مقیاس بزرگ خواهد بود. سؤال دیگر این نیست که آیا ماشین میتواند مثل انسان فکر کند، بلکه این است که آیا وب میتواند به امضای یک ماشین اعتماد کند.
گام بعدی شما
- اگر توسعهدهنده عاملهای AI هستید، مستندات Web Bot Auth را برای کاهش نرخ بلاک شدن بررسی کنید.
- مالکان وبسایتها باید استراتژیهای ضدبات خود را از «مسدودسازی کلی» به «تأیید هویت رمزنگاریشده» تغییر دهند.
- تغییر رفتار سرویسهای Cloudflare را در مواجهه با عاملهای تأییدشده زیر نظر بگیرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو