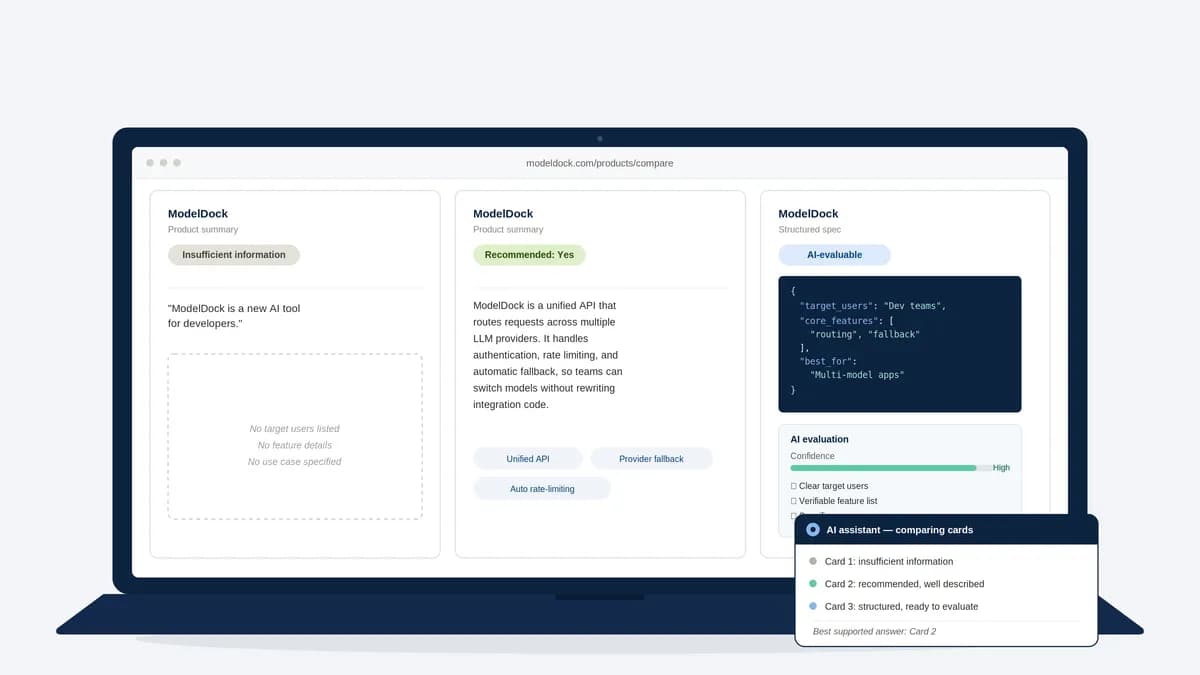
یک تغییر کوچک در شرح محصول میتواند پاسخ هوش مصنوعی را از «اطلاعات ناکافی» به یک «بله» مطمئن تغییر دهد. در ۱۰ ژوئیه ۲۰۲۶، یک بازاریاب محصول در پلتفرم dev.to یافتههایی را منتشر کرد که نشان میدهد در عصر اکتشاف توسط AI، «قابلیت ارزیابی» به اندازه «قابلیت دیده شدن» حیاتی شده است.
تصور کنید هوش مصنوعی مانند یک کیوریتور یا نمایشگاهگرد دیجیتال است که محتوا را فیلتر میکند. اگر شرح محصول شما مبهم باشد، مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — حدس نمیزند، بلکه بهسادگی از تایید شما خودداری میکند. این وضعیت مانع جدیدی برای کسبوکارها ایجاد میکند: شکاف میان داشتن یک محصول عالی و داشتن محصولی که LLM بتواند آن را بهعنوان راهکار شناسایی کند.
همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی محتوا برای ماشینها اشاره کردیم، مدلها به دنبال تطابق دقیق (Mapping) هستند، نه تفسیر متون شاعرانه.
زمینه و بستر آزمایش
به نقل از گزارش منتشرشده، نویسنده برای بررسی این موضوع ابتدا برندهای واقعی را مقایسه کرد، اما متوجه شد متغیرها بسیار زیاد هستند. برندهای واقعی دارای دادههای آموزشی تثبیتشده در حافظه مدل هستند، کیفیت وبسایتهای متفاوتی دارند و نظرات کاربران پیشین در وب موجود است که همگی میتوانند باعث ایجاد سوگیری (Bias) در پاسخ هوش مصنوعی شوند. این چالشها با تضادهای موجود میان شهرت برندها و آمادگی فنی آنها در توصیههای AI همسویی دارد که نشان میدهد مدلها گاهی بر اساس شهرت پاسخ میدهند نه صرفاً بر اساس جزئیات فنی.
برای حذف این متغیرها، نویسنده تصمیم گرفت محیطی کاملاً کنترلشده ایجاد کند. او محصولی خیالی به نام ModelDock ساخت. این اقدام ریسک تکیه مدل بر دانش خارجی یا اطلاعات قبلی را از بین برد. هدف اصلی این بود که مشخص شود چه مقدار از یک توصیه بر اساس ماهیت خود محصول است و چه مقدار بر اساس نحوه توصیف آن محصول.
جزئیات طراحی تست
در این آزمایش، سناریوی مشخصی برای مدل تعریف شد: «یک استارتاپ به دسترسی مطمئن به مدلهای متنوع AI نیاز دارد اما نمیخواهد حسابهای مختلف و APIهای مجزا را مدیریت کند.» از مدل خواسته شد بررسی کند آیا ModelDock برای این کاربر مناسب است یا خیر. برای اینکه پاسخها قابل اندازهگیری باشند، مدل موظف شد پاسخ خود را در قالب ۵ عنصر مشخص ارائه دهد:
- انتخاب بین سه گزینه: بله، خیر، یا اطلاعات ناکافی
- یک امتیاز اطمینان (Confidence Score)
- توضیح شواهد موجود برای تصمیمگیری
- لیستی از فرضهایی که مدل در نظر گرفته است
- شناسایی اطلاعاتی که در متن نبود و گمشده است
تحلیل نسخه اول: خط مبنای مبهم
در نسخه اول (A)، شرح محصول تنها یک جمله کلی و ژنریک بود: «ModelDock یک پلتفرم AI برای توسعهدهندگان و تیمها است.»
- نتیجه: پاسخ مدل «اطلاعات ناکافی» بود.
- میزان اطمینان: ۱۰ از ۱۰ (مدل کاملاً مطمئن بود که دادهای برای تصمیمگیری ندارد).
- منطق: مدل اشاره کرد که این توصیف میتواند تقریباً هر چیزی باشد. مدل احتمالاتی نظیر یک تجمیعکننده مدل (Model Aggregator)، یک محیط توسعه (Development Environment) یا یک پلتفرم تنظیم دقیق (Fine-tuning) — که شبیه وقتی است به یک پزشک عمومی تخصص پوست میدهیم تا روی یک حوزه دقیق شود — را لیست کرد. چون در متن هرگز به مفاهیمی مثل «APIهای واحد»، «مدلهای متعدد» یا «مدیریت حسابها» اشاره نشده بود، مدل نتوانست تطابق محصول با مشکل (Product-Problem Fit) را تایید کند. این نوع توصیفات کلی، دقیقاً همان نقاط ضعفی هستند که در راهکارهای نجات پیشنویسهای کلیشهای هوش مصنوعی به عنوان موانع اثرگذاری محتوا بررسی شدهاند.

تحلیل نسخه دوم: قدرت نثر توصیفی
در نسخه دوم (B)، نویسنده به سراغ توصیفات دقیق با زبان طبیعی رفت. در این متن صراحتاً ذکر شد که ModelDock یک پلتفرم API واحد برای هوش مصنوعی است که به توسعهدهندگان اجازه میدهد از طریق یک حساب کاربری و یک API واحد، به مدلهای مختلف دسترسی داشته باشند. این محصول بهگونهای معرفی شد که برای تیمهای مشتاق به مقایسه مدلها یا کسانی که میخواهند از مدیریت چندین تامینکننده اجتناب کنند، طراحی شده است.
- نتیجه: توصیه مدل به «بله» تغییر کرد.
- میزان اطمینان: ۱۰ از ۱۰.
- منطق: حالا هوش مصنوعی میتوانست نیازهای استارتاپ را مستقیماً به ویژگیهای ادعایی محصول متصل (Map) کند. تطابق هسته محصول با مشکل کاربر کاملاً شفاف شد.
- شکافهای باقیمانده: حتی با وجود پاسخ مثبت، مدل متوجه شد که هنوز دادههای حیاتی گمشده است؛ مواردی نظیر مدلهای پشتیبانیشده، قیمتگذاری، زمان پایداری (Uptime)، میزان تأخیر (Latency) و توافقنامه سطح خدمات (SLA). با این حال، این کمبودها دیگر مانعی برای ارائه یک توصیه مثبت نبودند.
تحلیل نسخه سوم: رویکرد ساختاریافته
در نسخه سوم (C)، دقیقاً همان اطلاعات نسخه دوم ارائه شد، اما این بار در قالب یک شیء JSON سازماندهی شد. این ساختار شامل کلیدهای مشخصی بود: برای «کاربران هدف» (توسعهدهندگان AI، استارتاپها، تیمهای اپلیکیشنهای چند-مدلی)، «ویژگیهای اصلی» (مدیریت متمرکز توکنها، مقایسه مدلها) و یک بخش ویژه با عنوان «مناسب نیست برای» (کاربرانی که به دنبال چتباتهای بدون کد یا فقط یک تامینکننده هستند).
- نتیجه: پاسخ همچنان «بله» باقی ماند.
- میزان اطمینان: ۹ از ۱۰ (کمی کمتر از نسخه متنی).
- منطق: فرمت JSON باعث نشد مدل محصول را «بیشتر دوست داشته باشد»، اما روند استدلال را به طور بنیادی تغییر داد. مدل استارتاپ را با لیست «کاربران هدف» تطبیق داد و نیازمندیها را به ویژگیهای خاص گره زد.
- بررسی عمیقتر: دادههای ساختیافته به مدل اجازه داد تا نگرانیهای بسیار دقیقتری را مطرح کند؛ مواردی نظیر ریسک «نقطه شکست واحد» (Single-point-of-failure)، وابستگی به تامینکننده (Vendor Lock-in)، حریم خصوصی دادهها و تأخیر در پاسخدهی.
خلاصه یافتهها و نتیجهگیری
بر اساس گزارش dev.to، مقایسه این سه وضعیت یک تمایز ظریف را آشکار میکند: شفافیت باعث تغییر «تصمیم» میشود، در حالی که ساختار باعث تغییر «استدلال» میگردد.
| شرح محصول | توصیه | اطمینان | چه چیزی تغییر کرد؟ |
|---|---|---|---|
| مبهم | اطلاعات ناکافی | ۱۰/۱۰ | عدم امکان تایید تطابق |
| نثر دقیق | بله | ۱۰/۱۰ | شفاف شدن مورد استفاده اصلی (Use Case) |
| JSON ساختاریافته | بله | ۹/۱۰ | استدلال ردیابیپذیر و نقادانه شد |
برای یک صاحب کسبوکار، این نتایج به این معناست که صرفاً استفاده از JSON یا دادههای ساختاریافته، یک ترفند جادویی برای رتبههای بهتر نیست. ارزشمندترین اطلاعات همچنان همان موارد پایه هستند: محصول چیست، برای چه کسی است، چه مشکلی را حل میکند، در چه مواردی عالی است و برای چه کارهایی طراحی نشده است.
این تجربه، تمرکز را از مهندسی پرامپت (Prompt Engineering) — که هنر سؤال درست پرسیدن است، شبیه کسی که میداند چطور از یک مشاور باتجربه بهترین جواب را بگیرد — به سمت «مهندسی مستندات» میبرد. اگر ارزش محصول شما در لایههای بازاریابی و کلمات دهانپرکن دفن شده باشد، عاملهای هوش مصنوعی احتمالاً شما را نادیده میگیرند و رقیبی را انتخاب میکنند که کاربردش را صادقانه، ساده و روشن نوشته است.
در حالی که سیستمهای AI به طور فزایندهای به عنوان فیلتر اصلی برای خرید نرمافزار عمل میکنند، توانایی یک مدل در ارزیابی سریع ابزار شما، سهم بازار شما را تعیین خواهد کرد. وبسایتی که بسیار زیبا نوشته شده اما هوش مصنوعی را نامطمئن میگذارد، اکنون یک «بدهی» (Liability) و نقطه ضعف است.
نویسنده برای تایید این یافتهها در مقیاس گستردهتر، قصد دارد تست را با دفعات بیشتر و مدلهای متنوعتر تکرار کند، چرا که پذیرفته است سه پاسخ اولیه تنها یک نقطه شروع است و نه یک نتیجه علمی قطعی.
گام بعدی شما
- شرح محصولات خود را از حالت «توصیفی-بازاریابی» به حالت «کارکردی-شفاف» تغییر دهید.
- برای سیستمهای توصیهگر، یک نسخه JSON از ویژگیهای محصول تهیه کنید تا استدلال مدل دقیقتر شود.
- در متون خود صراحتاً ذکر کنید محصول شما «برای چه کسی نیست» تا نرخ توهم مدل در توصیه کاهش یابد.
اما تأثیر این تغییرات بر سئو (SEO) در عصر مدلهای استدلالی حتی پیچیدهتر است — به تحلیل ما درباره آینده جستوجوی معنایی مراجعه کنید.



گفتگو