اگر امروز ده عامل یکسان از مدل GPT-4o را برای مدیریت حجم بالای درخواستها مستقر کردهاید، در واقع ریسک شکست خود را ده برابر کردهاید. در محیطهای احتمالی (Stochastic)، تکرار مدلهای مشابه باعث افزایش قابلیتها نمیشود، بلکه فقط سطح تماس برای وقوع توهمهای یکسان را گسترش میدهد. این یک مغالطه در مقیاسدهی است؛ اگر یک عامل اصلی در مورد یک قانون انطباق خاص دچار توهم شود، ده عامل یکسان، همان توهم را ده بار تکرار خواهند کرد و هیچ لایهای برای اصلاح خطا وجود نخواهد داشت.
به نقل از راهنمای فنی منتشر شده در dev.to در تاریخ ۶ سپتامبر ۲۰۲۶، تابآوری سازمانی نیازمند چرخش از مقیاسدهی افقی به سمت «عمق» است. این رویکرد شبیه به لیست بازیکنان (Depth Chart) یک تیم فوتبال NCAA است؛ مربی فقط ۱۰۰ ورزشکار یکسان جذب نمیکند. در عوض، تیمی میسازد که شامل یک ستاره برای شروع، یک بازیکن ذخیره قابلاعتماد که بتواند ریتم بازی را حفظ کند و متخصصانی است که فقط در لحظات حساس و برای کارهای با ریسک بالا وارد زمین میشوند.
بسیاری از تیمهای پلتفرم، مقیاسدهی عاملها را یک مسئلهٔ ظرفیتی میبینند. آنها تصور میکنند اگر یک مدل استدلالی (Reasoning Model) — مثل شطرنجبازی که چند حرکت جلوتر را میبیند — بتواند کاری را انجام دهد، تعداد بیشتری از همان مدل، پایداری را تضمین میکند. اما تابآوری واقعی از «افزونگی لایهای» حاصل میشود. همانطور که در تحلیلهای پیشین ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تنوع در معماری، تنها راه مقابله با نقاط ضعف سیستماتیک است. این رویکرد در واقع تکاملیافتهی ایدهی استفاده از کمیتههای مدلهای بازمتن برای غلبه بر مدلهای تکسازه غولپیکر است که نشان داد تیمی از مدلهای کوچکتر میتواند در مهندسی دقیقتر عمل کند. با طراحی ناوگان عاملها به صورت Depth Chart، شما منطق «نفر بعدی» (Next Man Up) را پیاده میکنید تا وقتی مدل اصلی به بنبست میرسد، یک عامل جایگزین متخصص از پیش برای پذیرش بار آماده باشد.
مقیاسدهی خطی در برابر معماری Depth Chart
برای درک این تغییر، باید مقیاسدهی سنتی را با مدل Depth Chart مقایسه کرد. مقیاسدهی خطی شامل استقرار چندین نمونه یکسان از یک مدل استدلالی (مثلاً GPT-4o) برای مدیریت بار است که معمولاً امتیاز تابآوری پایینی (حدود ۴۵.۰) کسب میکند. در مقابل، مقیاسدهی Depth Chart از استقرار لایهای شامل عاملهای اصلی، ذخیره و متخصص استفاده میکند — مثلاً جریانی که از GPT-4o به Claude 3 Haiku و سپس به یک Llama 3 با تنظیم دقیق (Fine-tuning) منتقل میشود — که منجر به امتیاز تابآوری بهمراتب بالاتر یعنی ۸۸.۰ میشود.
اگر شما هم از مرحلهٔ آزمایش با یک بات ساده به مدیریت یک ناوگان عامل عبور کردهاید، احتمالاً با سقف مقیاسدهی خطی برخورد کردهاید. این نقطه، مرز بین آزمایشهای ساده و استقرار در سطح سازمانی (Enterprise-grade) است و دقیقاً همان جایی است که تفاوتهای بنیادین میان عاملهای سفارشی و راهکارهای SaaS در مقیاس سازمانی نمایان میشود.
کالبدشکافی لیست بازیکنان
آیا واقعاً برای هر نوبت از یک گفتگو به مدلی در سطح Frontier نیاز دارید؟ احتمالاً خیر. اما نمیتوانید برای مدیریت یک گردشکار پیچیده و چندمرحلهای به یک مدل کوچک و تقطیرشده اعتماد کنید. راهکار، تقسیم نقشها به سه دسته متمایز برای تعادل بین هزینه، تأخیر و دقت است:
- عاملهای شروعکننده (Starters): لنگرهای استدلالی مانند Claude 3.5 Sonnet یا GPT-4o. اینها دارای پنجرهٔ زمینه (Context Window) — مثل میز کاری که جا برای چند ورق دارد، نه برای کل کتابخانه — بزرگی هستند و وظایفی چون طبقهبندی قصد کاربر، ارکستراسیون پیچیده و «بارهای سنگین» استدلال را بر عهده دارند. اینها چهرهٔ عملیات هستند، اما گرانترین و کندترین بخش سیستم میباشند. هدایت ۱۰۰٪ ترافیک از طریق شروعکنندهها باعث انفجار هزینههای توکن و ایجاد تأخیری میشود که کاربران را دفع میکند.
- عاملهای ذخیره (Backups): اینها صرفاً نسخههای کوچکترِ شروعکنندهها نیستند، بلکه جایگزینهای متخصص (Specialized Failovers) هستند. یک عامل ذخیره میتواند مدلی باشد که روی مستندات خاص شرکت تنظیم شده یا مدلهای میانردهای مثل GPT-4o-mini یا Llama 3.1 70B که برای زیرمجموعهای از وظایف شروعکننده بهینه شدهاند. آنها زمانی فعال میشوند که عامل شروعکننده در تست اعتماد شکست بخورد یا به سقف تأخیر برسد. آنها نیازی ندارند همه چیز را بدانند؛ فقط باید در آن مورد خاصی که شروعکننده در آن شکست خورده، بهتر عمل کنند.
- تیمهای ویژه (Special Teams): متخصصان قطعی (Deterministic). اینها در معنای عام کلمه «استدلال» نمیکنند، بلکه «اجرا» میکنند. برای کارهایی که توهم در آنها غیرقابلقبول است طراحی شدهاند؛ مانند فرمت کردن یک خروجی JSON برای APIهای قدیمی یا ایفای نقش به عنوان «متخصص انطباق» که پاسخ را با یک چکلیست رگولاتوری ۵۰ موردی تطبیق میدهد. اینها اغلب از مدلهای کوچک با پرامپتهای سیستمی بسیار سختگیرانه یا پوششهای منطق نمادین (Symbolic Logic Wrappers) استفاده میکنند. برونسپاری این وظایف، مانع از هدر رفتن توکنهای گرانقیمت شروعکنندهها برای کارهایی میشود که نیازی به هوش عمومی ندارند.
ارکستراسیون منطق «نفر بعدی»
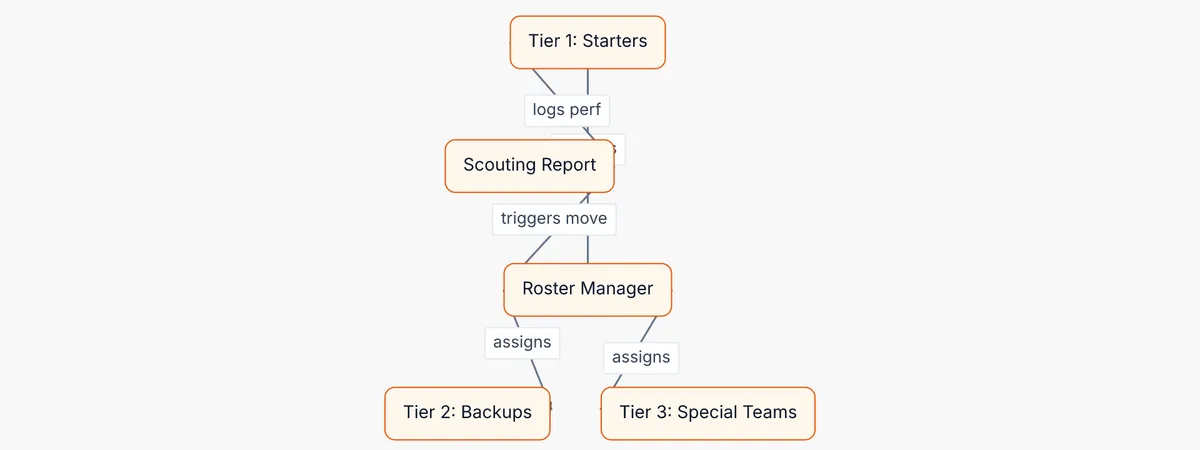
انتقال یک وظیفه از عامل شروعکننده به ذخیره، بدون از دست دادن کل وضعیت (State) گفتگو، نیازمند یک لایه ارکستراسیون است. این لایه فقط ترافیک را هدایت نمیکند، بلکه «سلامت» خروجی عامل را در لحظه رصد میکند. این لایه از محرکهای جایگزینی (Failover Triggers) خاصی استفاده میکند تا تصمیم بگیرد چه زمانی شروعکننده را به نیمکت بفرستد، زیرا شما نمیتوانید به خودِ عامل اعتماد کنید تا به شما بگوید که در حال شکست خوردن است.
محرکهای خارجی کلیدی عبارتند از:
- امتیاز اعتماد (Confidence Scoring): عامل شروعکننده یک امتیاز اعتماد خودارزیابیشده ارائه میدهد. اگر این امتیاز زیر ۰.۷ باشد، ارکستراتور عامل ذخیره را فعال میکند.
- اعتبارسنجی قطعی: یک عامل «تیم ویژه» بررسی سریعی روی خروجی شروعکننده انجام میدهد. اگر خروجی یک محدودیت سخت را نقض کند (مثلاً نبود یک فیلد اجباری در پاسخ JSON)، به عنوان شکست ثبت میشود.
- جهشهای تأخیر: اگر تأخیر P99 ارائهدهنده LLM اصلی از یک آستانه مشخص فراتر رود، ارکستراتور وظایف غیربحرانی را به «نیمکت» مدلهای سریعتر و کوچکتر منتقل میکند.
- تشخیص حلقه: اگر عامل شروعکننده یک عبارت مشابه را سه بار در سه نوبت گفتگو تکرار کند، ارکستراتور آن را به عنوان «حلقه استدلالی» علامتگذاری کرده و عامل را تعویض میکند.
تصور کنید در یک سناریوی عملیاتی مربوط به یک پرونده پیچیده بیمه، عامل استدلالی اصلی یک خلاصه و یک تصمیم تولید میکند. قبل از رسیدن پاسخ به کاربر، ارکستراتور خروجی را به «متخصص انطباق» (تیم ویژه) میفرستد. متخصص متوجه میشود که شروعکننده یک افشای قانونی اجباری مربوط به ایالت خاص را فراموش کرده است. ارکستراتور بهجای اینکه از شروعکننده بخواهد «دوباره تلاش کند» — که اغلب منجر به توهمات بیشتر میشود — یک عامل «ذخیره انطباق» را که بهطور خاص روی افشاهای ایالتی تنظیم شده، فعال میکند. این عامل ذخیره، پاسخ را اصلاح کرده و برای تحویل نهایی میفرستد.
نظارت انسانی و پایش عملکرد
هر چقدر هم Depth Chart شما خوب باشد، سیستمهای احتمالی روزی به وضعیتی میرسند که قادر به حل آن نیستند. اینجا نقش «سرمربی» یا همان نظارت انسانی (HITL) ظاهر میشود. وقتی ارکستراتور میبیند هم شروعکننده و هم ذخیره در یک تست اعتبارسنجی یکسان شکست خوردهاند، سعی نمیکند عامل سومی را امتحان کند، بلکه وضعیت را منجمد کرده و به اپراتور انسانی هشدار میدهد تا از «حلقه بینهایت شکست» جلوگیری شود؛ وضعیتی که در آن عاملها فقط به حدس زدن ادامه میدهند.
مدیریت این لیست نیازمند «گزارشهای استعدادی» (Scouting Reports) بر اساس مشاهدهپذیری رفتاری است. تیمها باید فراتر از «توکن در ثانیه» بروند و «نرخ موفقیت به ازای هر لایه» را رصد کنند. این کار باعث ایجاد یک چرخه سیال ارتقا و تنزل میشود:
- ارتقا: اگر یک عامل ذخیره (مثلاً Llama 3.1 تنظیمشده) در دستهای خاص از وظایف، همواره بهتر از شروعکننده عمل کند، برای آن قصد (Intent) خاص به لایه شروعکننده ارتقا مییابد.
- تنزل: اگر یک مدل شروعکننده دچار Drift (انحراف) شود یا نسخه جدید مدل باعث افت استدلال در یک حوزه شود، به نیمکت ذخیره برای کارهای کمریسک منتقل میشود تا زمانی که بازآموزی یا جایگزین شود.
برای جلوگیری از «افت عملکرد» — جایی که سیستم برای صرفهجویی در هزینه، بیش از حد به مدلهای ارزان ذخیره تکیه میکند — استفاده از Shadow Testing توصیه میشود. یعنی درصد کمی از وظایف همزمان به هر دو لایه فرستاده شده و خروجیها توسط یک مدل زبانی بهمثابه داور (LLM-as-a-judge) مقایسه میشوند. اگر کیفیت عامل ذخیره نسبت به شروعکننده از یک حد مشخص (Delta) پایینتر بیاید، یعنی فشار بیش از حدی به نیمکت وارد شده است.
حالتهای شکست بحرانی
پیادهسازی کورکورانه Depth Chart خطرات جدید و پیچیدهای را معرفی میکند. خطرناکترین آنها «آسیبپذیریهای آبشاری» یا «نقص موروثی» است. اگر عامل شروعکننده در برابر یک حمله تزریق پرامپت (Prompt Injection) خاص آسیبپذیر باشد، احتمالاً عامل ذخیره از همان خانواده مدل نیز آسیبپذیر است. برای مقابله، باید تنوع مدلها را افزایش داد (مثلاً ترکیب Anthropic، OpenAI و مدلهای متنباز) تا لایههای مختلف از خانوادههای متفاوتی باشند. با این حال، باید مراقب بود که پیچیدگی عملیاتی ناشی از استراتژیهای چندمدلی بر ارزش تجاری غلبه نکند، زیرا مدیریت چندین API و نسخه مختلف مدل میتواند بار نگهداری سیستم را به شدت افزایش دهد.
همچنین، سربار ارکستراسیون باعث افزایش تأخیر میشود. هر «چک» یا «محرک جایگزینی»، زمان میبرد. اگر منطق انتخاب «نفر بعدی» ۵۰۰ میلیثانیه و پاسخ عامل ذخیره ۴۰۰ میلیثانیه طول بکشد، تقریباً یک ثانیه به تجربه کاربر اضافه میشود. توسعهدهندگان باید بین جزئیات Depth Chart و بودجه تأخیر تعادل برقرار کنند: برای اپلیکیشنهای سریع، لایهها را کم و برای انطباقهای حساس، لایهها را عمیق نگه دارید.
در نهایت، از دست رفتن وضعیت (State) هنگام انتقال میتواند تجربه را تخریب کند. ارسال تنها سه پیام آخر باعث میشود عامل ذخیره ظرافتهای گفتگو را از دست بدهد و ارسال کل تاریخچه، باعث تورم پرامپتها و افزایش هزینهها میشود. راهکار، «خلاصهسازی وضعیت» است که در آن شروعکننده یک Snapshot از زمینه را برای عامل ذخیره آماده میکند تا فوراً جذب شود.
یک اشتباه رایج دیگر، «جایگذاری نادرست در لیست» است. گماشتن یک مدل عمومی به نقش جایگزین متخصص، یک شکست است. اگر عامل ذخیره فقط همان مدل عمومی با پرامپتی متفاوت باشد، شما فقط یک «تلاش دوم» دارید، نه یک «قابلیت متفاوت». یک جایگزین واقعی باید پروفایل توانمندی متفاوتی داشته باشد؛ اگر شروعکننده یک «غول استدلالی» است، ذخیره باید یک «متخصص حوزه» باشد.
نقشه راه پیادهسازی
برای حرکت به سمت مدل Depth Chart، توسعهدهندگان میتوانند با یک نگاشت سهلایه شروع کنند. برای مثال:
- در طبقهبندی قصد کاربر: از gpt-4o به عنوان شروعکننده و claude-3-5-sonnet به عنوان ذخیره با محرک امتیاز اعتماد زیر ۰.۸ استفاده کنند.
- در تولید خروجی API: از gpt-4o-mini به عنوان شروعکننده، llama-3-1-70b به عنوان ذخیره و یک فرمتکننده JSON قطعی به عنوان متخصص استفاده شود که با شکست اعتبارسنجی Schema فعال میگردد.
- در بررسیهای رگولاتوری: از claude-3-5-sonnet به عنوان شروعکننده، یک Llama تنظیمشده برای انطباق به عنوان ذخیره و یک سرویس Guardrail مبتنی بر Regex به عنوان متخصص استفاده شود.
این چرخش معماری، هدف را از «پایداری ۱۰۰ درصدی» — که در سیستمهای احتمالی غیرممکن است — به «تابآوری سیستماتیک» تغییر میدهد. این یعنی وقتی ستاره تیم شما به بنبست میرسد، متخصصی روی نیمکت آماده است تا بازی را نجات دهد.
گام بعدی شما
- تحلیل کنید کدام بخش از گردشکارهای شما بیشترین نرخ توهم را دارد و برای آن یک «عامل متخصص» (Special Team) طراحی کنید.
- یک لایه اعتبارسنجی قطعی (Deterministic) برای خروجیهای حساس (مانند JSON یا کد) اضافه کنید تا از ارسال پاسخهای غلط به کاربر جلوگیری شود.
- مدلهای ذخیره خود را از خانوادههای مختلف (مثلاً ترکیب OpenAI و Anthropic) انتخاب کنید تا آسیبپذیریهای مشترک را کاهش دهید.
اما مدیریت هزینههای این لایههای متعدد، چالشی جدیدتر است — به تحلیل ما دربارهی بهینهسازی هزینه استنتاج در مقیاس بالا مراجعه کنید.



گفتگو