یک کوئری SQL که از نظر فنی هیچ خطایی ندارد، باز هم میتواند پاسخی کاملاً غلط به مدیرعامل یک شرکت بدهد. این هشدار خیره کننده، محوریت تحلیل فنی ۲۶ ژوئن ۲۰۲۶ در وبسایت dev.to است که در آن متخصصان برجسته توضیح میدهند چرا سامانههای تبدیل متن به SQL (Text-to-SQL) در مواجهه با «مسیرهای پیوند» (Join Path) پیچیده، زمانی که این مسیرها میان جداول پایگاهداده بدیهی نیستند، شکست میخورند.
بیشتر دموهای هوش مصنوعی از طرحهای دادهای (Schemas) تمیز با کلیدهای خارجی واضح استفاده میکنند، اما پایگاهدادههای سازمانی بهندرت اینقدر سادهاند. همانطور که در تحلیل قبلی ما دربارهی اینکه چگونه مفاهیم متنی میتوانند در ثبت تغییرات پیچیده آینده شکست بخورند اشاره کردیم، مشکل اصلی این است که مدلهای هوش مصنوعی اغلب روابط بین جداول را بر اساس الگوهای نامگذاری حدس میزنند، نه بر اساس منطق تجاری واقعی سازمان.
شکاف میان اعتبار فنی و اعتماد تجاری
در یک محیط تحلیل داده واقعی، سختترین بخش یک کوئری بهندرت عبارت SELECT است؛ بلکه تعیین مسیر پیوند (Join Path) است. تصور کنید کاربر درخواست «درآمد هر مشتری در سه ماهه گذشته» را دارد. یک مدل ممکن است کوئریای تولید کند که جدول customers را به orders پیوند دهد و تاریخها را بر اساس تقویم فیلتر کند (مثلاً از ۱ ژانویه تا ۱ آوریل ۲۰۲۶).
از نظر فنی، SQL تولید شده کاملاً درست است و بدون خطا اجرا میشود. اما در یک محیط سازمانی، این پاسخ اغلب غلط است. ممکن است جدول customers دیگر مرجع اصلی (Master) مورد تایید نباشد، یا فیلد orders.revenue آن ستونی نباشد که بخش مالی برای گزارشها تایید میکند، و یا «سه ماهه گذشته» بر اساس منطق تقویم مالی شرکت باشد، نه تقویم میلادی. چون پایگاهداده کوئری را میپذیرد و داشبورد عدد را نمایش میدهد، این اشتباه بهطرز خطرناکی پنهان میماند.
چرا مسیرهای پیوند دشوارند؟
مسیرهای پیوند تنها زمانی واضحاند که مدلهای داده پاک و ایدهآل باشند. طبق گزارش dev.to، در محیطهای عملیاتی (Production)، این مسیرها به دلایل زیر آشفته و پیچیده هستند:
- فقدان کلیدهای خارجی (Foreign Keys) و وجود جداول قدیمی (Legacy) که استانداردهای مدرن ندارند.
- وجود ستونهای مشابه که نامهای یکسانی دارند اما معانی متفاوتی را حمل میکنند.
- وجود نسخههای تاریخی (Snapshots) و ابعادی که به کندی تغییر میکنند (Slowly Changing Dimensions).
- ایجاد دیتامارتهای تخصصی برای هر دپارتمان و استفاده مجدد از فیلدها برای اهداف مختلف.
- وجود قوانینی تجاری که هیچکجا نوشته نشدهاند و فقط در گزارشهای SQL قدیمی ثبت شدهاند.
حتی مهندسان باتجربه نیز پیش از اعتماد به یک پیوند، زمان زیادی را صرف بررسی طرحها و مشورت با واحد مالی میکنند. مدلهای هوش مصنوعی که فقط نام جداول و ستونها را میبینند، مجبور به حدس زدن هستند و این حدسها میتوانند بهطرز خطرناکی متقاعدکننده و درست به نظر برسند.
طبق این گزارش، خطرناکترین نوع شکست، «مشکل گسترش» (Fanout Problem) است. تصور کنید کوئریای که سفارشات را به خطوط سفارش و سپس به محمولهها پیوند میدهد:
SELECT o.customer_id, SUM(o.order_amount) AS revenue FROM orders o JOIN order_lines l ON o.order_id = l.order_id JOIN shipments s ON l.line_id = s.line_id GROUP BY o.customer_id;
اگر یک خط سفارش (Order Line) چندین محموله (Shipment) داشته باشد، مدل بهاشتباه درآمد کل سفارش را به تعداد محمولهها تکرار کرده و چندین بار جمع میزند. SQL از نظر فنی معتبر است، اما نتیجه مالی کاملاً غلط است. یک تحلیلگر انسانی میداند که برای جلوگیری از این خطا، باید ابتدا دادهها را در سطح سفارش تجمیع کند یا از یک جدول درآمد تعدیلشده بر اساس محموله استفاده نماید.
محدودیتهای متادیتای ساده
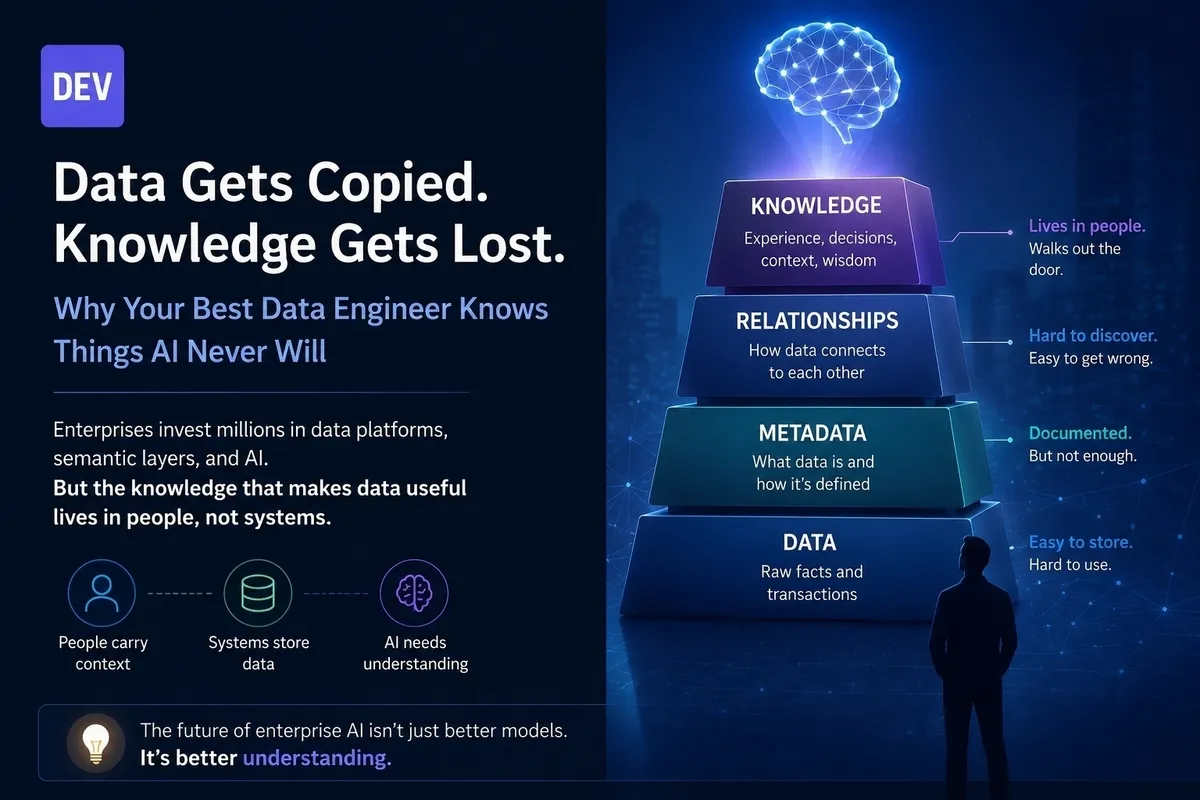
متادیتای ساده کمک میکند اما درمان قطعی نیست. نام ستونها میتوانند نشان دهند که customer_id به مشتریان مربوط است، اما نمیتوانند سیگنال دهند که آیا این رابطه برای گزارشهای حساس مالی «امن» است یا خیر. کلیدهای خارجی ثابت میکنند که رابطهای وجود دارد، اما نشان نمیدهند که آیا این رابطه برای عملیات تجمیع (Aggregation) ایمن است یا خیر. همچنین، توضیحات متنی (Descriptions) اغلب در توضیح استثناهای تاریخی شکست میخورند.
برای حل این مشکل، نویسنده پیشنهاد میکند از متادیتای ساده به سمت «زمینه رابطهای» (Relationship Context) حرکت کنیم. یک سامانه در سطح سازمانی برای قابل اعتماد بودن باید موارد زیر را ردیابی کند:
- مسیرهای پیوند تاییدشده: شناسایی مسیرهای 검سده و تاییدشده برای پاسخ به پرسشهای رایج تجاری.
- تعداد رابطهها (Cardinality): درک دقیق ریسکهای رابطه یک-به-چند برای جلوگیری از مشکل گسترش داده (Fanout).
- ضریب اطمینان پیوند: ارزیابی اینکه یک مسیر خاص چقدر قابل اعتماد است.
- شواهد منبع: مشخص بودن اینکه یک مسیر از کجا آمده است؛ از یک مدل dbt، مجموعههای داده BI، تاریخچه کوئریهای SQL، الگوهای نامگذاری یا تایید مستقیم انسانی.
- مسیرهای منسوخ: شناسایی صریح روابطی که رد شدهاند چون منجر به استخراج دادههای قدیمی و تاریخگذشته میشوند.
الگوی مطمئنتر برای اجرا
این رویکرد، هوش مصنوعی را از یک «مترجم ساده» به یک «استدلالگر» تبدیل میکند. یک سامانه بهینه و قابل اعتماد باید این ۹ گام مشخص را طی کند:
۱. تجزیه و تحلیل دقیق پرسش کاربر.
۲. شناسایی موجودیتهای تجاری و متریکهای مورد نیاز.
۳. رفع ابهام از تعاریف معنایی (Semantic Definitions).
۴. بازیابی جداول کاندید.
۵. بازیابی مسیرهای رابطهای مورد اعتماد.
۶. بررسی ریسکهای احتمالی پیوند.
۷. تولید SQL با استفاده از مسیرهای تاییدشده.
۸. اعتبارسنجی نهایی در برابر قوانین معنایی و رابطهای.
۹. توضیح مفروضاتی که پشت نتیجه نهایی قرار دارند.
بیشتر سامانههای فعلی از گام ۳ مستقیماً به گام ۷ میپرند. لایه گمشده در این میان، «هوش رابطهای» است. برای یک مهندس داده، این یعنی لایه هوشمندی باید خارج از وزنهای داخلی مدل زبانی بزرگ (LLM) قرار بگیرد. شما نمیتوانید به مدل تکیه کنید تا «بداند» که فیلد orders.revenue متریک مورد تایید مالی نیست؛ این دانش تخصصی باید بهصورت صریح به عنوان زمینه (Context) به مدل تزریق شود.
این تغییر بنیادین، معیار موفقیت Text-to-SQL را عوض میکند. ما در حال حرکت از اندازهگیری «صحت اجرا» (Execution Accuracy - آیا کد اجرا میشود و خطا نمیدهد؟) به سمت «صحت اعتماد» (Trust Accuracy - آیا پاسخ از نظر مالی و تجاری درست است؟) هستیم.
تا زمانی که سامانهها این لایه از هوش رابطهای را پیادهسازی نکنند، Text-to-SQL در دموهای کنترلشده عالی عمل میکند اما در محیطهای واقعی شرکتها به شدت در تکاپو خواهد بود. هدف دیگر فقط نوشتن یک کوئری نیست، بلکه تضمین این است که کوئری برای تجمیع دادهها «امن» باشد.
گام بعدی شما
- اگر از Text-to-SQL استفاده میکنید، لایهای برای اعتبارسنجی Cardinality (رابطه یک-به-چند) اضافه کنید تا از خطاهای جمع (SUM) جلوگیری شود.
- به جای تکیه صرف بر نام ستونها، فهرستی از «مسیرهای پیوند تاییدشده» را در لایه متادیتای خود تعریف کنید.
- خروجیهای مدل را با یک تحلیلگر انسانی در مورد «معیارهای مالی» (Financial Metrics) تطبیق دهید تا اطمینان حاصل شود.
اما این چالشها بخشی از مشکل بزرگتر در مدیریت دادههای سازمانی است — برای درک اینکه چگونه گرافهای دانش میتوانند جایگزین متادیتای ساده شوند، تحلیل ما درباره Knowledge Graphs را بخوانید.



گفتگو