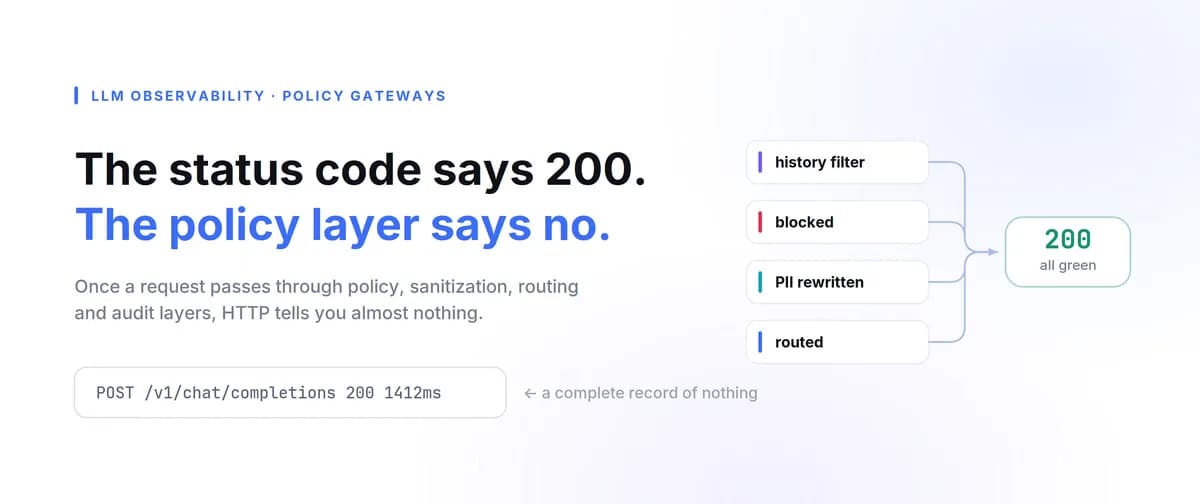
تصور کنید یک مهندس بکاند در صبح سهشنبه با این وضعیت روبروست: دستیار هوش مصنوعی داخلی شرکت نیمی از پیامهای او را رد میکند، اما تمام داشبوردهای نظارتی سبز هستند و هیچ خطایی نشان نمیدهند. این تناقض زمانی رخ میدهد که لایههای سیاستگذاری، تصمیمات خود را پشت کدهای وضعیت استاندارد پنهان میکنند. سازندگان LLMInspect استدلال میکنند که مانیتورینگ در سطح HTTP اساساً نسبت به تصمیماتی که در لایههای سیاستگذاری هوش مصنوعی زاینده (Generative AI) گرفته میشود، کور است. این لایهها شبیه به یک نگهبان سختگیر هستند که قبل از ورود هر کس به کتابخانه، محتویات کیفش را چک میکند.
همانطور که در تحلیل قبلی ما دربارهی reskSecure و مسدود کردن جیلبریکها در سطح لاجیتها اشاره کردیم، امنیت در مدلهای زبانی لایهبهلایه اتفاق میافتد. اما مشکل اینجاست که اکثر تیمها لایه انتقال (درخواست HTTP) را رصد میکنند، نه لایه سیاستگذاری را. وقتی یک درخواست از لایههای پاکسازی، مسیریابی و حسابرسی عبور میکند، دریافت کد «200 OK» فقط به این معناست که سرور پاسخ داده است، نه اینکه مدل واقعاً قصد کاربر را پردازش کرده باشد یا درخواست از فیلترهای امنیتی عبور کرده باشد.
شکست کدهای وضعیت
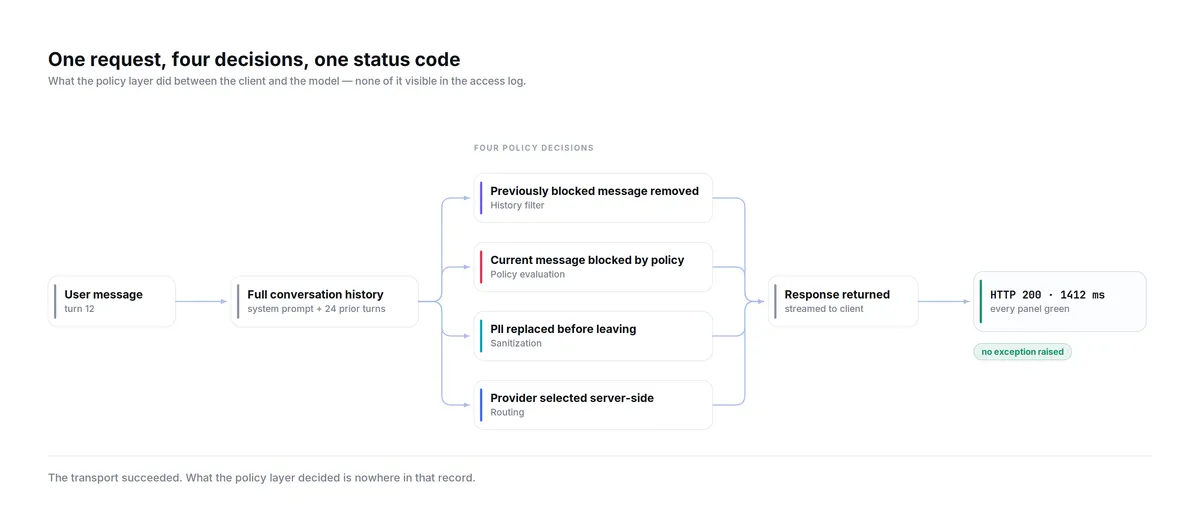
بر اساس یک تحلیل فنی که در ۵ سپتامبر ۲۰۲۶ منتشر شد، اولین مشکل اساسی این است که کدهای وضعیت هیچ اطلاعات معنایی درباره سیاستهای امنیتی ندارند. گیتویها برای اینکه کاربر در محیط چت با اعلانهای خطای عمومی و خشک روبرو نشود، اغلب کد HTTP 200 را برمیگردانند، اما دلیل رد درخواست را به صورت رمزگذاری شده در داخل پاسخ استریمشده (Streamed Response) قرار میدهند. این موضوع یادآور چالشهای مشابهی است که در بررسی کدهای موفق HTTP در دسترسی عاملهای هوش مصنوعی مشاهده کردیم، جایی که پاسخهای ظاهراً موفق، در واقع پوششی برای مسدود بودن دسترسیها بودند.
این انتخاب در طراحی باعث میشود کاربر دلیل دقیق مسدود شدن پیام را دقیقاً در همان جایی ببیند که پاسخ دستیار باید ظاهر شود. در نتیجه، هر سامانه نظارتی که به اشتباه فرض کند کد 2xx به معنای «موفقیت» است، نه تنها دچار افت کیفیت شده، بلکه عملاً نسبت به نقض سیاستهای امنیتی نابیناست.
شکاف در جزئیات
مشکلات ساختاری، مشاهدهپذیری را پیچیدهتر میکنند. یک درخواست POST به مسیر /v1/chat/completions معمولاً شامل کل تاریخچه گفتگو است، نه فقط یک پیام واحد. در حالی که لاگ دسترسی (Access Log) تنها یک تراکنش را ثبت میکند، سامانه سیاستگذاری ممکن است برای هر پیام مجزا در آن بسته داده (Payload)، ۲۵ تصمیم مختلف بگیرد.
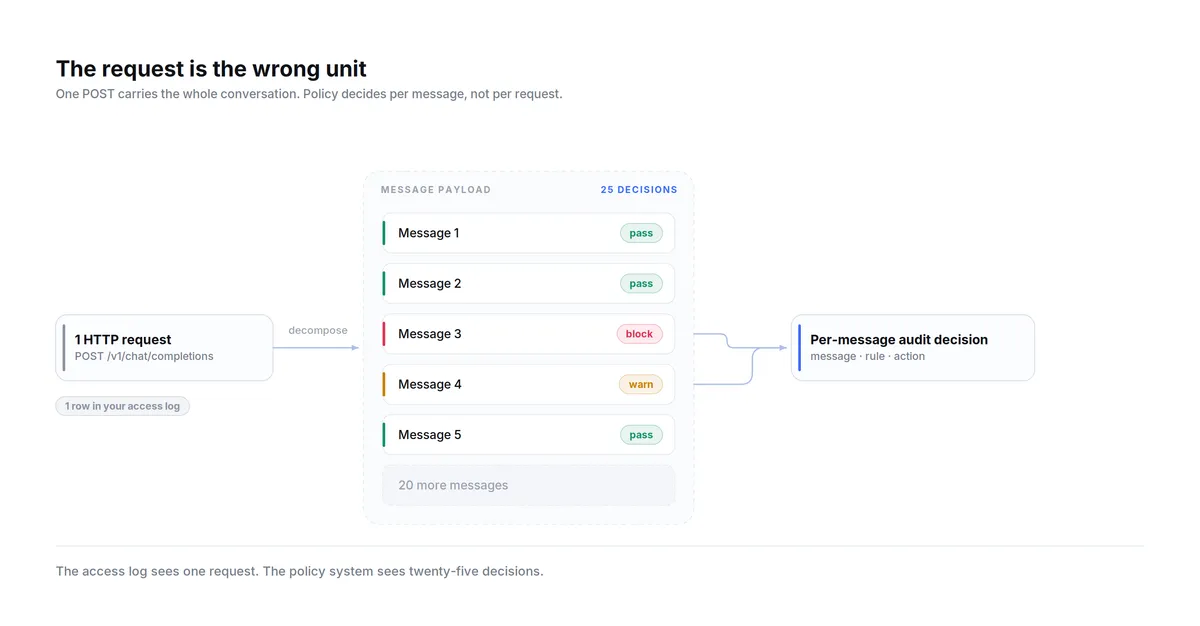
اگر یک پیام خاص به دلیل تطابق با لیست سیاه (Deny-list) یا شناسایی اطلاعات حساس (PII) مسدود شود، لاگ HTTP نمیتواند پاسخ دهد که کدام قانون اجرا شده است یا اینکه آیا محتوا صرفاً پرچمگذاری (Flagged) شده است یا کاملاً رد شده است. تنها یک رکورد حسابرسی در سطح پیام (Message-level audit record) میتواند این سطح از جزئیات و دقت را ارائه دهد.
توهم بدنه درخواست
شکاف خطرناکی بین آنچه اپلیکیشن ارسال میکند و آنچه ارائهدهنده مدل دریافت میکند وجود دارد. یک گیتوی سیاستگذار میتواند محتوا را در لحظه و به صورت زنده تغییر دهد. این تغییرات از طریق روشهای زیر انجام میشود:
- حذف پیامهایی که قبلاً مسدود شدهاند از تاریخچه گفتگو.
- جایگزینی اطلاعات شخصی با مقادیر مستعار (Pseudonymous values).
- جایگزینی اعتبارنامههای احراز هویت.
- تغییر مسیر درخواست به یک ارائهدهنده بالادستی متفاوت بر اساس سیاستهای سمت سرور.
اشتباه گرفتن درخواست اولیه با محتوای پس از اعمال سیاستها، توهمی از دقت ایجاد میکند. برای رسیدن به مشاهدهپذیری واقعی، مهندسان باید «تصمیم» را ثبت کنند، نه فقط «تراکنش» را. در واقع، برای مقابله با تهدیداتی مانند تزریق پرامپت، استفاده از پراکسیهای قطعی به عنوان یک ضرورت مطرح شده است تا رفتار سیستم پیشبینیپذیر و قابل رصد باشد.
خط لوله پردازشی
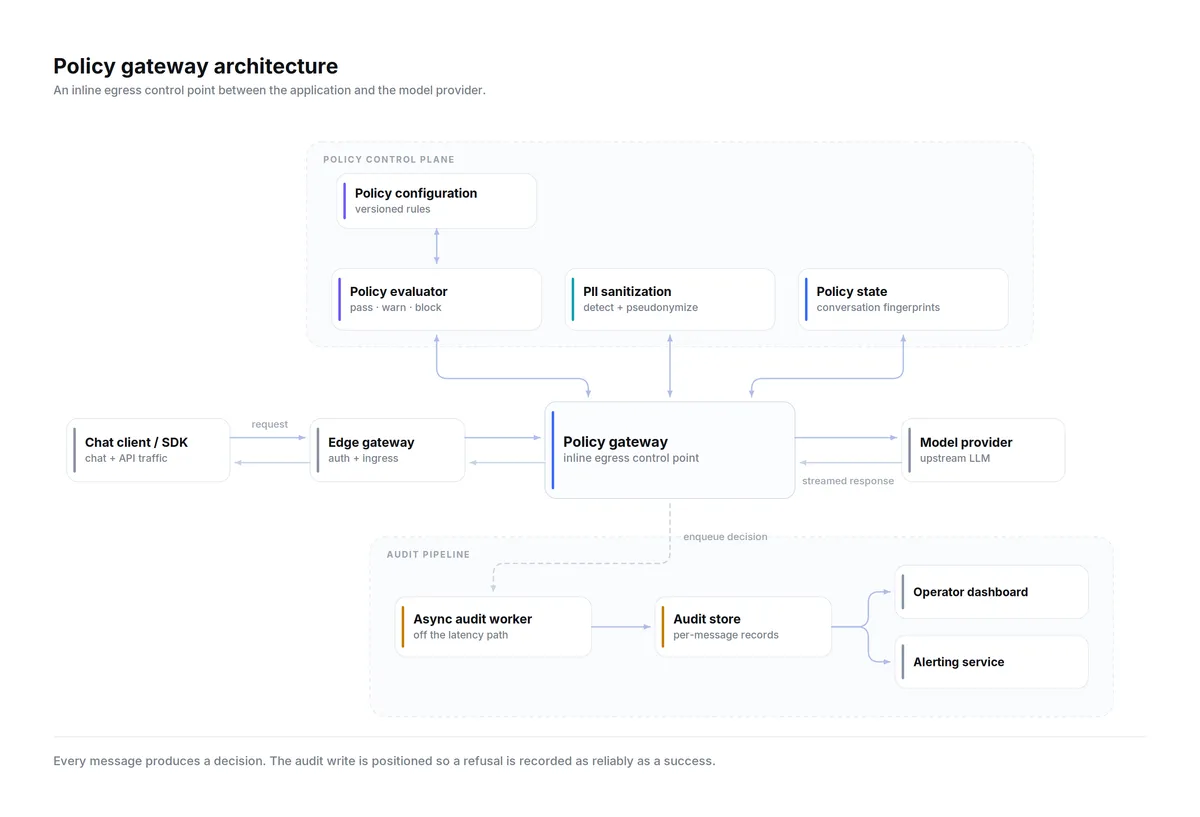
LLMInspect یک خط لوله پردازشی ثابت را اجرا میکند که در آن ترتیب عملیات بسیار حیاتی است. این توالی معمولاً به این شکل است: احراز هویت $ \rightarrow $ تنظیم درخواست $ \rightarrow $ فیلتر تاریخچه $ \rightarrow $ ارزیابی سیاست $ \rightarrow $ پاکسازی PII $ \rightarrow $ حسابرسی $ \rightarrow $ تصمیم مسدود/اجازه $ \rightarrow $ جایگزینی مستعار $ \rightarrow $ فراخوانی ارائهدهنده.
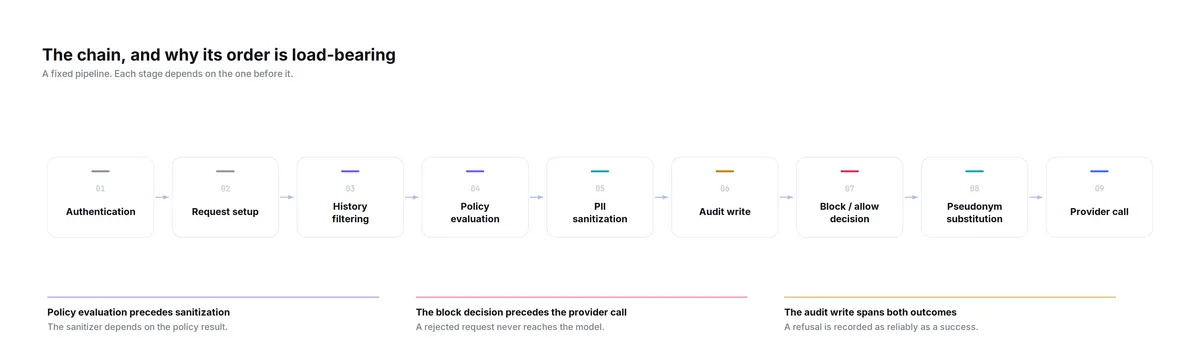
این ترتیب تضمین میکند که یک درخواست ردشده هرگز به مدل نرسد و فیلتر تاریخچه مانع از آن شود که محتوای مسدودشده هنگام ارسال مجدد گفتگو توسط کلاینت، دوباره ظاهر شود. لایه حسابرسی باید دقیقاً در موقعیتی قرار گیرد که رد درخواستها را با همان قابلیت اطمینانی که موفقیتها را ثبت میکند، ثبت نماید.
فراتر از تصمیمات دوتایی
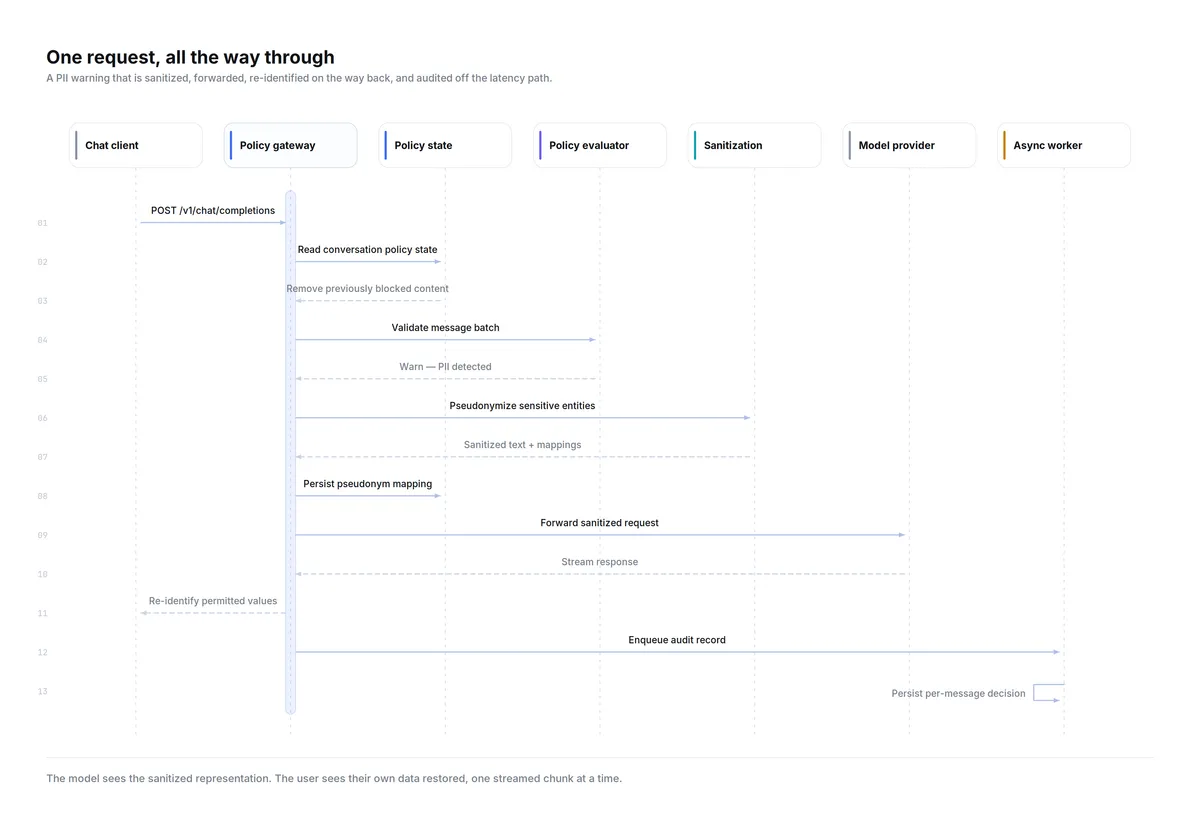
ارزیابهای سیاستگذاری کارآمد از حالت ساده «اجازه/مسدود» (Binary) فراتر میروند. یک مدل سهحالته شامل «پذیرش» (Pass)، «هشدار» (Warn) و «مسدود» (Block) کنترل بسیار دقیقتری را فراهم میکند. برای مثال، شناسایی اطلاعات حساس (PII) ممکن است فقط یک هشدار ایجاد کند، اما نشت اعتبارنامهها منجر به مسدود شدن فوری و قطعی شود.
اعتبارسنجهای رایج در این ساختار عبارتاند از:
- شناسایی PII: استفاده از بازشناسی موجودیتها (Entity Recognition) برای یافتن دادههای شخصی.
- شناسایی اسرار (Secret Detection): تحلیل الگو و آنتروپی برای یافتن رمزها، توکنها و کلیدهای دسترسی.
- تحلیل احساسات: اعمال سیاستهای مربوط به لحن سازمانی و اخلاقی.
- شناسایی ریسک پرامپت: استفاده از طبقهبندیکنندهها (Classifiers) برای یافتن پرامپتهای مشکوک یا مخرب.
- لیستهای سیاه: استفاده از تطبیق دقیق و الگویی برای ممنوعیتهای صریح.
پیچیدگی بازشناسی در استریم
یکی از سختترین چالشهای فنی، بازگرداندن دادههای پاکسازیشده به کاربر است. اگر گیتوی نام «الکس دو» را برای مدل با یک نام مستعار جایگزین کند، باید در پاسخ استریمشده، این تغییر را برعکس کند تا کاربر نام واقعی را ببیند.
چون پاسخهای مدل در تکههای کوچک (Chunks) میرسند، یک نام ممکن است بین چندین فریم تقسیم شود (مثلاً در فریم اول "Al" و در فریم دوم "ex D" و در فریم سوم "oe"). در اینجا جایگزینی ساده متنی مانند str.replace() شکست میخورد. سیستم به یک تطبیقدهنده استریم نیاز دارد که وضعیت تطبیقهای ناقص را در مرز فریمها حفظ کند تا مجبور نشود کل پاسخ را بافر کند و باعث افزایش تأخیر (Latency) شود.
حل نشت داده در ارسال مجدد
پراکسیهای بدون وضعیت (Stateless) از یک نقص بحرانی رنج میبرند: آنها پیامی را در نوبت سوم گفتگو مسدود میکنند، اما وقتی نوبت چهارم میرسد، کلاینت کل تاریخچه (شامل همان پیام مسدودشده در نوبت سوم) را دوباره میفرستد. اگر پراکسی فقط پیام جدید (نوبت چهارم) را چک کند، محتوای مسدودشده قبلی به مدل نشت میکند. این نوع شکستهای پنهان در APIها، مشابه مواردی است که در تحلیل مکانیزم Lease در برابر حلقههای تکرار بررسی کردیم، جایی که تکرار ساده درخواستها در صورت دریافت پاسخهای خالی اما موفق، منجر به پایداری پایین سیستم میشود.
برای حل این مشکل، گیتوی باید مسدودسازی وضعیتدار (Stateful) را اجرا کند. با ایجاد یک اثر انگشت (Fingerprint) در محدوده گفتگو برای پیامهای مسدودشده، فیلتر تاریخچه میتواند آنها را از درخواستهای بعدی کاملاً حذف کند.
تحلیل: تغییر در مشاهدهپذیری
این تغییر در دیدگاه، فرض بنیادی عملیات هوش مصنوعی (AI Ops) را تغییر میدهد. ما در حال حرکت از «مانیتورینگ تراکنشی» (آیا فراخوانی API کار کرد؟) به سمت «مانیتورینگ تصمیم» (چرا گیتوی این تصمیم را گرفت؟) هستیم.
برای متخصصان، این بدان معناست که مدل اغلب آخرین جایی است که شکست در آن قابل مشاهده میشود، اما به ندرت جایی است که شکست از آنجا شروع شده است. اثر مرتبه دوم این است که موتورهای سیاستگذاری خود به سیستمهای نرمافزاری تبدیل میشوند که نیاز به نسخهبندی، تست و مدیریت تغییرات دارند. اکنون یک قانون اشتباه میتواند در عرض چند ثانیه در کل سازمان منتشر شود و قطعی سیستمیکی ایجاد کند که در داشبوردها شبیه به یک API کاملاً سالم به نظر میرسد.
گام بعدی شما
- لاگهای فعلی مدلهای زبانی خود را بررسی کنید تا ببینید آیا برای تشخیص موفقیت، صرفاً به کد HTTP 200 تکیه کردهاید یا خیر.
- پیادهسازی یک ردپای حسابرسی در سطح پیام را شروع کنید که هر پاسخ مدل را به نسخه خاصی از سیاست و قانونی که اجازه عبور داده است، متصل کند.
- بررسی کنید که آیا گیتوی شما قابلیت مسدودسازی وضعیتدار برای جلوگیری از نشت داده در تاریخچههای ارسالی مجدد را دارد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو