
تصور کنید یک کاربر آلمانی برای سلام کردن به چتبات شما پیامی میفرستد، اما سیستم شما بهاشتباه یک جستوجوی وب گرانقیمت را برای نرخ ارز ترکیه فعال میکند. این خطای فنی خاص که در سپتامبر ۲۰۲۶ توسط سازنده GetAskAI مستند شد، نشان میدهد چرا لیستهای کلمات کلیدی ابزاری اشتباه برای مسیریابی چتباتها به سمت وب هستند.
بسیاری از توسعهدهندگان برای جلوگیری از هزینهی جستوجوی وب برای هر پرسش، از یک «دروازه ارزان» استفاده میکنند. آنها لیستی از کلمات محرک مثل «آبوهوا»، «قیمت»، «امروز» یا «نتیجه بازی» میسازند تا تصمیم بگیرند چه زمانی API جستوجو فراخوانی شود. این رویکرد در ابتدا بهینه به نظر میرسد، اما به محض اینکه محصول در زبانهای مختلف یا با نیات پیچیده مقیاسپذیر شود، شکست میخورد.
تطبیق کلمات کلیدی، معنا را نادیده میگیرد و مرز کلمات را نمیشناسد. در مورد GetAskAI، کلمه ترکی برای نرخ ارز («kur») درون کلمه آلمانی برای «بهطور خلاصه» («kurz») یافت شد. وقتی کاربر نوشت «Sag kurz Hallo» (که تقریباً به معنای «یک سلام سریع بکن» است)، تطبیق زیررشتهای کلمه «kur» را درون «kurz» پیدا کرد. در نتیجه، دروازه فعال شد و سیستم هزینه یک جستوجوی وب را پرداخت کرد تا فقط به یک سلام پاسخ دهد.
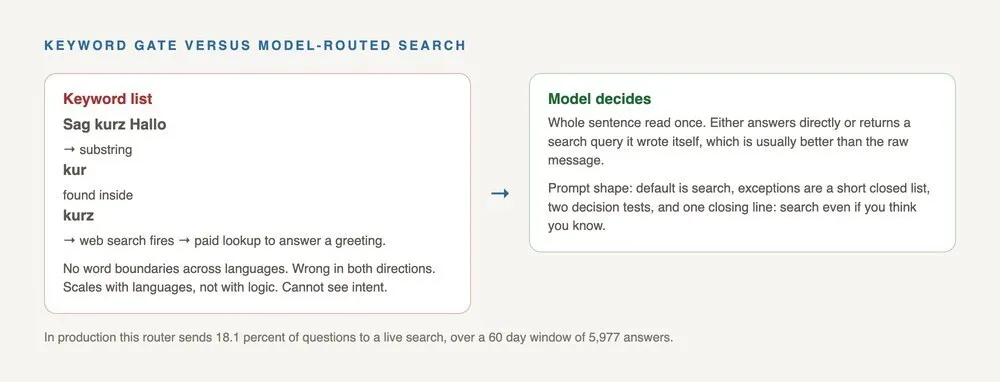
شکست الگوریتمهای تطبیق الگو
تطبیق زیررشتهای (Substring matching) وضعیتی دوطرفه و زیانبار برای توسعهدهندگان ایجاد میکند. این روش از یک سو روی سلامهای بیربط فعال میشود و از سوی دیگر در پرسشهای حساس و حیاتی سکوت میکند؛ مثلاً در سوالی مثل «آیا درخواست اقامت من هنوز به روش قدیمی بررسی میشود؟»، جایی که قدیمی بودن اطلاعات حتی به اندازه یک سال میتواند واقعاً آسیبزا باشد، سیستم ممکن است جستوجو را نادیده بگیرد.
افزودن کلمات بیشتر به لیست، تنها چرخه جدیدی از مثبتهای کاذب (False Positives) ایجاد میکند. افزودن کلمات شاید نقصهای امروز را برطرف کند، اما مثبتهای کاذب فردا را میسازد. برای محصولی که از ۱۱ زبان پشتیبانی میکند، این به معنای نگهداری ۱۱ مجموعه محرک بود که بر اساس حدس و گمانهای یک نفر درباره نحوه تایپ واقعی کاربران بومی نوشته شده بود. این مدل با تعداد زبانها رشد میکند، نه با منطق.
علاوه بر این، لیستهای کلمات کلیدی قادر به تشخیص نیت (Intent) نیستند. کاربری که میپرسد «تورم را توضیح بده» و کاربری که میپرسد «تورم همین الان چقدر است»، هر دو از کلمات کلیدی مشابه استفاده میکنند، اما فقط دومی واقعاً به یک جستوجوی لحظهای نیاز دارد. همانطور که در تحلیلهای قبلی ما درباره امنیت مدلهای بازمتن اشاره کردیم، تکیه بر الگوهای ساده بهجای درک معنایی، همواره نقاط ضعف امنیتی و عملیاتی ایجاد میکند.
جایگزین: مسیریابی مبتنی بر مدل
توسعهدهنده GetAskAI بهجای استفاده از تکههای متن، تصمیمگیری را به مدل زبانی بزرگ (LLM) سپرد تا بر اساس کل جمله تصمیم بگیرد. بسته به زیرساخت فنی، دو روش اصلی برای اجرای این کار وجود دارد:
- فراخوانی تابع (Tool Calling): در این روش ابزاری به نام
search_webدر دسترس مدل قرار میگیرد؛ مدل یا مستقیماً پاسخ میدهد یا ابزار را با پرسوجویی که خودش بازنویسی کرده فراخوانی میکند. این روش زمانی توصیه میشود که مدل شما از قابلیت Function Calling پشتیبانی کند. - پرش طبقهبندیکننده (Classifier Hop): یک فراخوانی کوچک که یا یک پرسوجوی جستوجو برمیگرداند یا توکن صریح
NO_SEARCHرا ارسال میکند و سپس سیستم مسیر را تغییر میدهد. این روش برای زمانی است که مدل شما قابلیت فراخوانی ابزار ندارد یا میخواهید مسیریاب روی مدل متفاوتی اجرا شود.
این تغییر اجازه میدهد مدل بهجای تطبیق الگو روی تکههای متن، کل جمله را بخواند. همچنین مدل میتواند پرسوجوی جستوجوی بهتری نسبت به پیام خام کاربر بنویسد که این خود یک بهبود کیفی بزرگتر از خودِ تصمیم مسیریابی است. این رویکرد در راستای تفکیک لایههای تصمیمگیری است، مشابه آنچه در بهروزرسانی LangBot ۴.۹.۰ برای جداسازی لایه پایگاه دانش از هسته سیستم مشاهده کردیم تا انعطافپذیری سیستم افزایش یابد.
استراتژی پرامپت وارونه
طبق گزارشهای فنی، دستهبندیهای مفصل از آنچه باید جستوجو شود — یعنی لیستهای دستهبندی شده از قیمتها، آبوهوا، ورزش، اخبار و مقررات به همراه مثالها — اغلب مدلهای مسیریاب کوچک را گیج میکند. در واقع امتیاز دقت پایین میآید زیرا مدل در میان یک تاکسونومی (طبقهبندی) طولانی گم میشود.
راهکار، استفاده از یک پرامپت وارونه کوتاه (حدود ۲۰۰ کلمه) است که سه حرکت مشخص را اجرا میکند:
۱. پیشفرض را روی جستوجو قرار دهد: بهجای عبارت «در صورت نیاز جستوجو کن»، پرامپت میگوید «جستوجو کن مگر اینکه سوال در این لیست بسته باشد».
۲. لیست استثنائات را بسته و concrete نگه دارد: این لیست شامل محاسبات ریاضی، سلام و احوالپرسی، ترجمه، گرامر، کدنویسی، نویسندگی خلاق، خلاصهسازی متنی که کاربر پیست کرده و حقایق کتابی است که در هر کشور و هر سال یکسان هستند.
۳. ارائه دو آزمون تصمیمگیری: مدل از خود میپرسد: «آیا پاسخ بسته به کشور کاربر یا سال جاری تغییر میکند؟» و «اشتباه در پاسخ چه هزینهای برای این شخص دارد: پول، سلامتی، وضعیت قانونی، ایمنی یا از دست دادن یک ضربالاجل (Deadline)؟». اگر هر یک از اینها مثبت بود، جستوجو انجام میشود.
نکته حیاتی این است که پرامپت با این جمله پایانی تمام میشود: «حتی اگر فکر میکنی پاسخ را میدانی، باز هم جستوجو کن». این کار مانع از تکیه مدل به حافظه داخلی احتمالا قدیمی برای دادههای متغیر و ناپایدار میشود.
سنجش موفقیت با مجموعههای ارزیابی
برای حذف حدس و گمان، یک مجموعه ارزیابی (Eval Set) ثابت شامل ۳۰ سوال ساخته شد؛ ۱۵ مورد که حتماً باید جستوجو کنند و ۱۵ مورد که نباید، که در زبانها و حوزههای مختلف توزیع شده بودند.
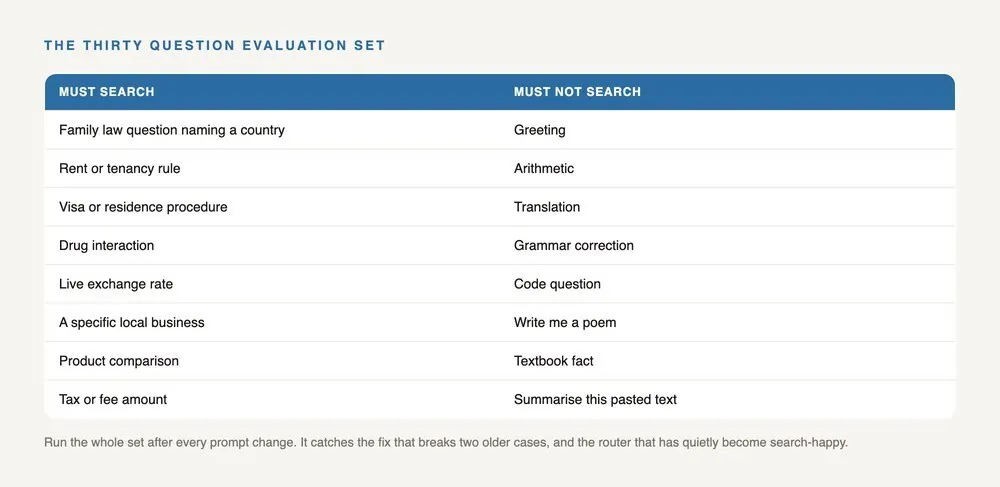
نمونههای «باید جستوجو کند»:
- سوالات حقوق خانواده که نام یک کشور در آن باشد
- قوانین اجارهبها یا استیجاری
- مراحل و رویههای دریافت ویزا
- تداخلات دارویی
- نرخ لحظهای ارز
- یک کسبوکار محلی خاص
- مقایسه محصولات
- مبلغ مالیات یا عوارض
نمونههای «نباید جستوجو کند»:
- سلام و احوالپرسی
- محاسبات ریاضی
- ترجمه
- اصلاح گرامری
- سوالات کدنویسی
- درخواست نوشتن شعر
- حقایق کتابی
- خلاصهسازی متن ارسالی کاربر
اجرای این مجموعه پس از هر تغییر در پرامپت، دو مشکل بحرانی را شناسایی میکند: تغییراتی که یک مورد جدید را درست اما دو مورد قدیمی را خراب میکنند، و مسیریابهایی که بهطور خاموش «عاشق جستوجو» (search-happy) شدهاند. در محیط عملیاتی، این مسیریاب اکنون ۱۸.۱ درصد از سوالات را در بازه ۶۰ روزه (از میان ۵۹۷۷ پاسخ) به جستوجوی زنده میفرستد و ۸۲ درصد باقیمانده مستقیماً پاسخ داده میشوند که هدف اقتصادی مسیریابی را محقق میکند.
تلههای پیادهسازی
در این مسیر دو اشتباه خاص شناسایی شد. اول، افزودن یک بودجه زمانی (Time Budget) به مسیریاب برای جلوگیری از کند شدن پاسخ، باعث شد سیستم زود تسلیم شود و بهطور پیشفرض به مسیر گرانقیمت جستوجو برود. در اینجا صحت باید اولویت اول باشد و سپس بهینهسازی.
دوم، پرامپت مسیریابی باید کاملاً از پرامپت شخصیت (Personality) سیستم جدا باشد. پرامپت اصلی سیستم به مدل میگوید که «صریح و متخصص باشد». اگر مسیریاب پرامپتی مشترک با این شخصیت داشته باشد، شخصیت مدل پیروز شده و مدل را سوق میدهد تا از حافظه پاسخ دهد. تصمیم مسیریابی نیاز به جمله صریح و مستقل خود دارد، بهجای اینکه فرض شود توصیف ابزار (Tool Description) کفایت میکند.
این تغییر معماری ثابت میکند مسیریابی منطقی بر تطبیق الگو پیروز میشود. هر قانونی که بر اساس تکههای زبان باشد، در نهایت در مواجهه با زبانهای مختلف شکست میخورد و این شکست بهصورت خاموش در جهتی رخ میدهد که بیشترین هزینه یا بیشترین ریسک برای اعتماد کاربر را دارد. این رویکرد در جریان ساخت GetAskAI توسعه یافت؛ یک چت هوش مصنوعی رایگان و متکی بر تبلیغات که بدون نیاز به حساب کاربری، از ۱۱ زبان پشتیبانی کرده و PDFها و تصاویر را بدون ذخیرهسازی میخواند.
گام بعدی شما
- اگر از لیست کلمات کلیدی برای Tool Calling استفاده میکنید، آن را با یک مدل طبقهبندیکننده کوچک جایگزین کنید.
- یک مجموعه ارزیابی (Eval Set) از ۲۰ سوال «باید» و «نباید» برای تست هر تغییر در پرامپت بسازید.
- پرامپت مسیریابی را از پرامپت اصلی شخصیت مدل جدا کنید تا تداخل نقشها باعث کاهش دقت نشود.
اما بهینهسازی هزینه استنتاج در مدلهای کوچکتر حتی جذابتر است — به تحلیل ما درباره مدلهای زبانی کوچک (SLM) مراجعه کنید.



گفتگو