اگر تصور میکنید پنجرههای متنی بزرگتر راهکار مقیاسپذیری در سازمانهاست، احتمالاً در حال سوزاندن بودجهی توکنهای خود هستید. باید بدانید که اتکای مطلق به حافظه مدل برای حل مسائل پیچیده سازمانی، نه تنها ناکارآمد است، بلکه منجر به افزایش هزینهها و تکرار توهمات میشود.
بیشتر پروژههای آزمایشی هوش مصنوعی شکست میخورند چون گردش کارهای سازمانی بیش از آنکه به خلاقیت نیاز داشته باشند، به محدودیتها و قوانین دقیق وابسته هستند. همانطور که در تحلیل قبلی ما دربارهی بهینهسازی استنتاج در مدلهای کوچک (Tiny-vLLM) اشاره کردیم، گلوگاه فعلی برای مقیاسپذیری دیگر فقط قدرت سختافزاری یا موتور محاسباتی نیست، بلکه «مسیریابی» است. سازمانها به یک GPS نیاز دارند تا مدل بتواند بدون گم شدن یا توهم، میان APIهای پراکنده، پایگاههای داده و سیاستهای نظارتی حرکت کند.
طبق گزارش ۱ ژوئن ۲۰۲۶ شرکت IBM، این «منطق عاملمحور» (Agent Logic) با ادغام گرافهای دانش، الگوریتمها و کتابخانههای تحلیل برنامه، فضای متنی مدل زبانی بزرگ (LLM) را محدود و هدایت میکند. بر اساس مستندات فنی این گزارش، نتایج کلیدی عبارتند از:
- کد قدیمی (WCA4Z): ابزار watsonx Code assistant for Z با استفاده از تحلیل استاتیک عمیق، در تحلیل برنامههای मेनفریم به کاهش ۳۰ برابری مصرف توکن نسبت به مدلهای پیشرو دست یافت.
- تولید تست (Aster): کتابخانه Aster پوشش خطوط و شاخهها را ۲۰ تا ۴۵ درصد بهبود داد، در حالی که ۱۵ برابر توکن کمتری نسبت به عاملهای کدنویسی State-of-the-art مصرف کرد.
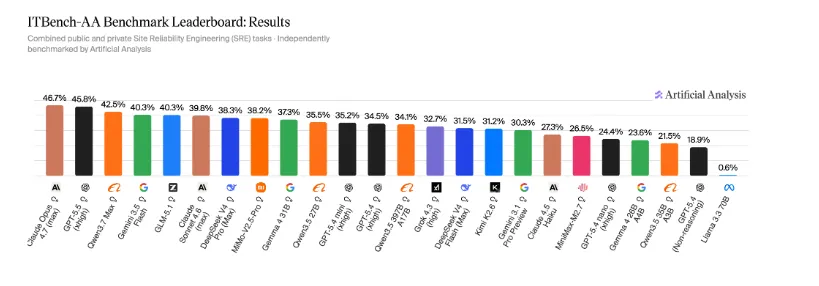
- پاسخ به حوادث (Instana I3): عامل I3 با محدود کردن استدلال به یک گراف دانش، در بنچمارک ITBench عملکردی ۴ برابر بهتر از یک عامل ReAct مبتنی بر GPT-5.1 داشت.
- تطبیقپذیری (Sovereign Core): برنامهریزی تطبیقی و تجزیه الگوریتمیک وظایف، نرخ موفقیت در مدل Claude 4 Sonnet را از تکرقمی به بیش از ۸۰ درصد رساند.
این یک چرخش ساختاری در معماری هوش مصنوعی زاینده (Generative AI) است. این دادهها ثابت میکنند که رقابت برای پنجرههای متنی بینهایت، در برابر توسعهی «هارنسهای نرمافزاری» (Software Harnesses) که مدل را هدایت میکنند، شکست میخورد. برای جامعهی فنی، معیار موفقیت از «تعداد پارامترهای مدل» به «کارایی منطق هدایتکنندهی عامل» تغییر میکند.
گام بعدی شما
- عملکرد عاملهای خود را در محیطهای پیچیده با استفاده از چارچوب ITBench ارزیابی کنید.
- برای تسکهای نگهداری صنعتی، بنچمارک AssetOpsBench را بررسی کنید.
- به جای تلاش برای افزایش Context Window، روی پیادهسازی گرافهای دانش برای محدود کردن فضای جستجوی مدل تمرکز کنید.
اما هزینه استنتاج (Inference) این منطقها در مقیاس میلیونی چگونه مدیریت میشود؟ به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو