اگر امروز برای انتخاب تامینکننده هوش مصنوعی، «اصالت دادهها» را معیار قرار میدهید، باید تحلیل ریسک خود را بهروز کنید. در ۵ ژوئن ۲۰۲۶، مدارکی منتشر شد که نشان میدهد مدلهای MAI مایکروسافت، برخلاف وعدههای شرکتی، همچنان به خزش غیرمجاز وب وابسته هستند.
این تناقض دقیقاً قلب تپنده جنگهای فعلی کپیرایت است. مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — برای رشد به سوخت عظیمی از داده نیاز دارد. همانطور که در تحلیلهای قبلی ما درباره امنیت دادههای سازمانی اشاره کردیم، مدیریت «ورودیها» چالش اصلی است. اما مایکروسافت با فروش این فرآیند به عنوان «درجه سازمانی»، یک نقطه اصطکاک اخلاقی و حقوقی ایجاد کرده است.
به گزارش the-decoder.com، یک مقاله فنی نشان میدهد که Common Crawl منبع اصلی دادههای این مدل است. بر اساس مستندات، مجموعه آموزشی را «ترکیبی از دادههای عمومی و دادههای تولیدشده توسط انسان با مجوز» توصیف کردهاند.
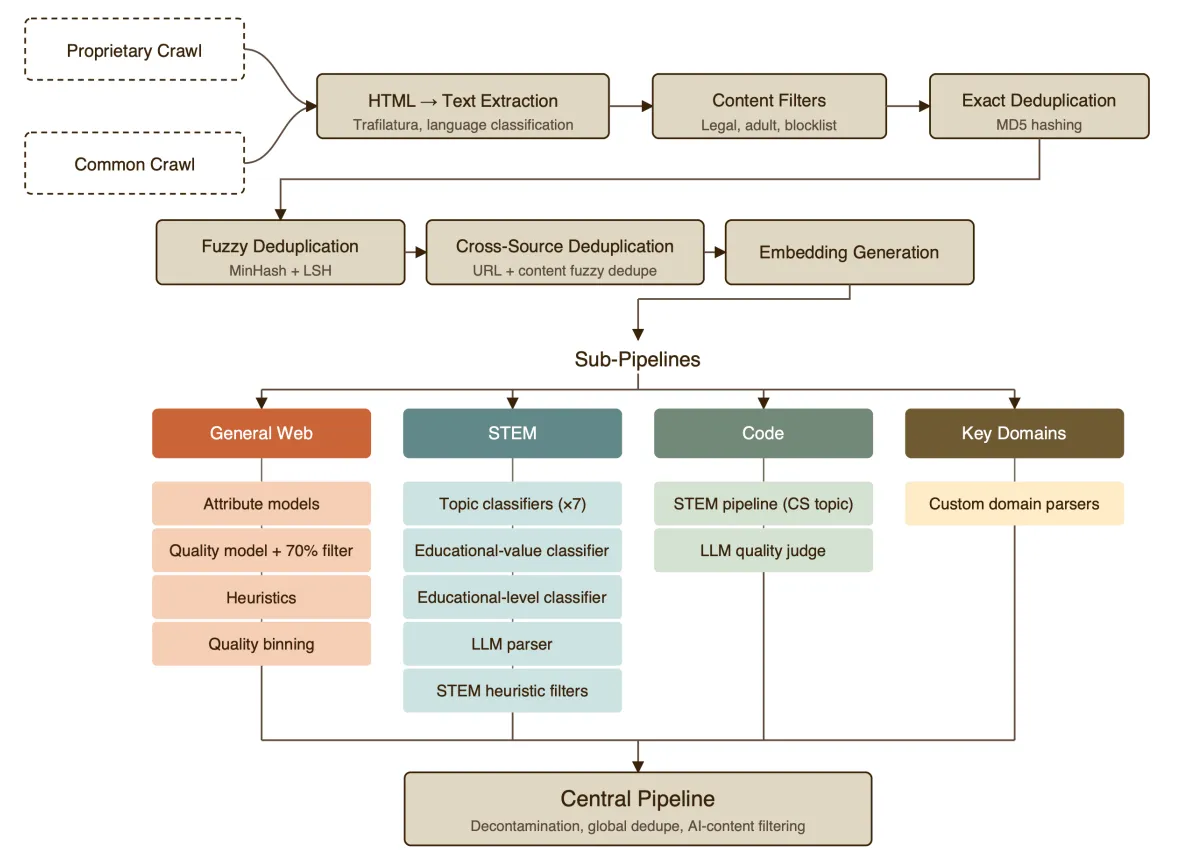
این شرکت برای جمعآوری دادهها از یک خزنده اختصاصی استفاده میکند. مایکروسافت ادعا میکند این ابزار به پروتکل Robots Exclusion (فایل robots.txt) احترام میگذارد. در واقع، این یعنی مسئولیت محافظت از دادهها را به دوش مالکان سایتها انداخته است.
برای یک مدیر کسبوکار، این یعنی اصطلاح «دادههای پاک» فعلاً یک برچسب بازاریابی است، نه یک تضمین فنی. وقتی غولی مثل مایکروسافت ادعای انحصاری بودن دادههای قانونی را میکند اما از وب باز استفاده میکند، اعتبار خود را نزد مشتریان سازمانی به خطر میاندازد. این ثابت میکند که حتی بزرگترین شرکتهای فناوری هم هنوز نمیتوانند بدون «اینترنت وحشی» مدلهای پیشرو بسازند.
گام بعدی شما
- فایل robots.txt سایت خود را بررسی کنید تا بدانید آیا محتوای شما تغذیهکننده نسل بعدی MAI است یا خیر.
- در قراردادهای سطح سازمانی، بندهای مربوط به «منشأ دادهها» را با دقت فنی بیشتری بازنگری کنید.
- احکام دادگاههای آتی درباره «استفاده منصفانه» (Fair Use) را دنبال کنید.
اما این تنها بخشی از بازی است؛ اثر این تناقض بر استراتژی قیمتگذاری مدلهای آینده را در گزارش بعدی بررسی خواهیم کرد.



گفتگو