
تغییر یک کلمهی ساده در پرامپت سیستمی یک عامل نباید شما را مجبور کند تا ۱۰ هزار سند را دوباره به بردار تبدیل کنید. با این حال، برای اکثر توسعهدهندگان که در حال ساخت سامانههای چندعاملی هستند، این دقیقاً همان اتفاقی است که میافتد؛ چون جریانهای کاری فعلی، خط لولههای هوش مصنوعی را بهجای گرافهای محاسباتی، شبیه به اسکریپتهای خطی میبینند.
همانطور که در تحلیل قبلی ما دربارهی شکستهای انتقال وظیفه در سامانههای چندعاملی در محیط عملیاتی اشاره کردیم، صنعت اکنون با دیوار دومی به نام «حلقه توسعه» برخورد کرده است. وقتی سیستمها از یک عامل ساده که فقط ابزارها را فراخوانی میکند به شبکههای پیچیدهای از برنامهریزان، پژوهشگران و ارزیابان تبدیل میشوند، هزینه هر بار تکرار بهشدت بالا میرود. آنچه با یک عامل شروع میشود که ابزاری را صدا میزند، بهسرعت به سیستمی تبدیل میشود که شامل چندین عامل، زمینه مشترک، بازیابی، پرامپتها، فراخوانی مدلها، ارزیابان و چندین مرحلهی پاییندستی است. این پیچیدگی در مدیریت ارکستراسیون عاملها، ما را به سمت راهکارهای جامعتری سوق میدهد، مشابه آنچه در بافت چندعاملی برای حذف وابستگیهای پیشبینیناپذیر در محیطهای سازمانی بررسی کردیم.
در یک ساختار تولید بازیابیافزا (RAG) — که شبیه دانشآموزی است که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — مسیر تبدیل اسناد خام به گزارش نهایی شامل یک توالی خاص است: اسناد ← تکهبندی ← بردار معنایی (Embedding) ← شاخص برداری ← بازیابی ← عامل ← ارزیابی. اگر سیستم شما «افزایشی» نباشد، ممکن است بهطور تصادفی باعث بازسازی کامل شاخص برداری شوید؛ فرآیندی که هم از نظر محاسباتی گران است و هم زمانبر، حتی اگر دادههای پایه تغییری نکرده باشند. این ناکارآمدی، نمونهسازی سریع را به یک عذاب و فرآیندی کند تبدیل میکند.
خط لوله هوش مصنوعی بهمثابه گراف وابستگی
برای حل این مشکل، توسعهدهندگان به سمت مدل ذهنی جدیدی میروند که در آن برنامه هوش مصنوعی، گرافی از مصنوعات وابسته است. یک برنامه هوش مصنوعی لزوماً برنامهای نیست که از بالا به پایین اجرا شود، بلکه گرافی از محاسبات است. برای مثال، یک جریان استاندارد میتواند اینگونه باشد: مجموعه داده ← پیشپردازش ← بردار معنایی ← شاخص برداری ← بازیابی ← عامل ← ارزیابی ← گزارش.
برخی گرهها حتی ممکن است شاخه بزنند. یک مجموعه داده ممکن است به گره پاکسازی برود و سپس برای تغذیه گره بردار معنایی (برای ساخت شاخص) و گره متادیتا (برای ارزیابی) تقسیم شود. وقتی سیستم را اینگونه ببینید، یک ویژگی مفید ظاهر میشود: اگر گرهی تغییر نکرده باشد، خروجی آن باید معمولاً قابل استفاده مجدد باشد. این همان ایده پایه در سیستمهای ساخت سنتی مثل make است.
به نقل از تحلیل فنی منتشر شده در dev.to در ۵ سپتامبر ۲۰۲۶، هدف این است که از برچسبهای زمانی ساده فاصله بگیریم. سیستمهای ساخت سنتی از تاریخ تغییر فایل استفاده میکنند، اما خط لولههای هوش مصنوعی ناپایدارترند. یک مصنوع میتواند به مجموعه داده، یک فایل پیکربندی، یک پرامپت، پارامترهای مدل، کد پیشپردازش، یک مصنوع دیگر، یک پیکربندی ارزیابی یا یک مدل خارجی وابسته باشد. ممکن است خود فایل تغییر نکرده باشد، اما محتوا یا وابستگیهایش تغییر کرده باشند.
برای مدیریت این موضوع، راهکار پیشنهادی از «اثرانگشتهای مبتنی بر محتوا» استفاده میکند. بهجای پرسش درباره تغییر زمان، سیستم میپرسد آیا محتوا یا وضعیت وابستگی که منجر به تولید آن مصنوع شده، تغییر کرده است؟ سیستم یک هش بر اساس فرمول artifact_hash = hash(input_content + configuration + dependency_hashes) محاسبه میکند. اگر اثرانگشت با اجرای قبلی مطابقت داشته باشد، سیستم بهطور کامل از محاسبات آن مرحله میپرد.
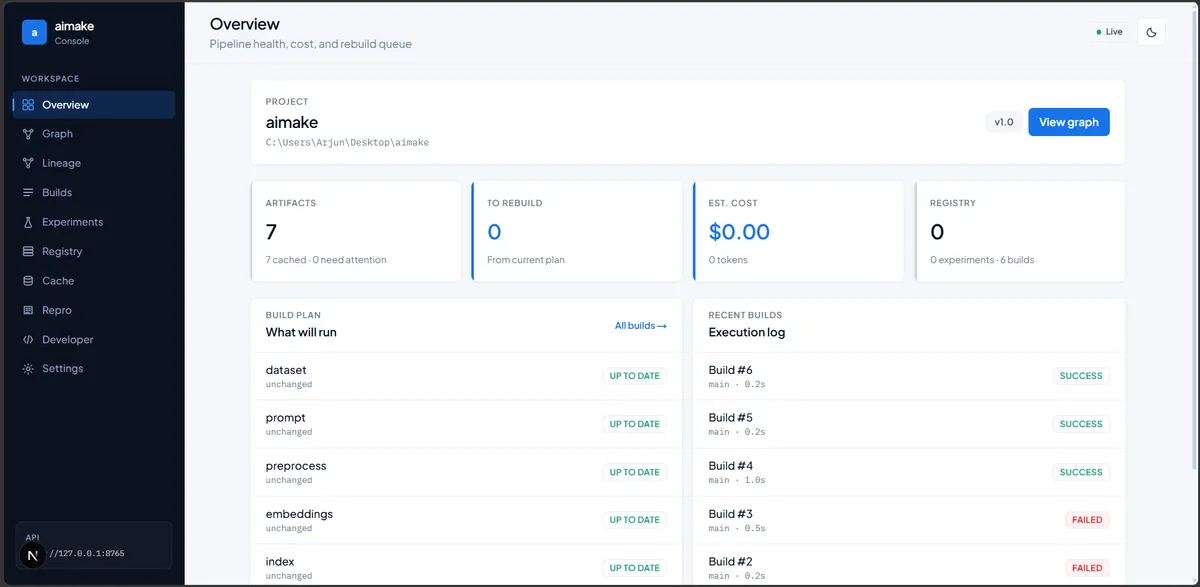
اعمال رویکرد افزایشی در عاملها
سامانههای چندعاملی پیچیدگیهای خاصی دارند که این رویکرد را ضروری میکند. یک سیستم ممکن است شامل یک عامل برنامهریز باشد که یک عامل پژوهشگر، یک عامل بازیابی و یک عامل ابزار را هماهنگ میکند و همه آنها به یک ترکیبکننده و در نهایت به یک ارزیاب متصل میشوند.
وضعیت یک عامل به متغیرهای متغیری وابسته است:
- پارامترهای مدل: تغییر از GPT-4o به یک مدل Llama 3 که تنظیم دقیق (Fine-tuning) — شبیه وقتی که به یک پزشک عمومی تخصص پوست میدهیم — شده است.
- پرامپت: بهروزرسانی دستورالعملهای سیستمی برای یک شخصیت (Persona) خاص.
- ابزارها و طرحهای ابزار: بهروزرسانی تعریف API ابزاری که عامل فراخوانی میکند.
- زمینه بازیابی شده: تکههای خاصی که از ذخیرهساز برداری استخراج شدهاند.
- حافظه: تاریخچه در حال تکامل گفتگو.
- پیکربندی عامل: تنظیمات داخلی و معیارهای ارزیابی.
در خط لولهای شامل برنامهریز، پژوهشگر، بازیابیکننده، تحلیلگر، نویسنده و ارزیاب، تغییر پرامپت نویسنده فقط باید گرههای نویسنده و ارزیاب را باطل کند. خروجیهای پژوهشگر و بازیابیکننده معتبر میمانند و از حافظه پنهان (Cache) فراخوانی میشوند. به همین ترتیب، تغییر در بخش بازیابی لزوماً نباید باعث بازسازی شاخههای غیرمرتبط سیستم شود.
گلوگاه ارزیابی
ارزیابی شاید گرانترین بخش حلقه عاملمحور باشد. ارزیابیهای مدرن بهجای تمرکز بر جواب نهایی، بهطور فزایندهای بر کل مسیر اجرا تمرکز دارند. این کار شامل بررسی موارد زیر است:
- خروجیهای نهایی و فراخوانی ابزارها.
- نتایج بازیابی و گامهای میانی.
- زمینه، تأخیر و مصرف توکن.
- مسیرهای کامل حرکت (Trajectories) عامل.
وقتی ارزیابی در گراف وابستگی ادغام شود (عامل ← ردپا ← ارزیاب ← آزمایش ← گزارش)، به یک رکن اصلی تبدیل میشود. اگر شما فقط معیارهای ارزیابی (روباریک) را تغییر دهید، میتوانید ارزیاب را روی ردپاهای موجود اجرا کنید بدون اینکه نیاز باشد خود عاملها را دوباره اجرا کنید. برعکس، اگر عامل پایه تغییر کند، سیستم میفهمد ردپاهای قبلی منقضی شدهاند و مسیر اجرای جدیدی را فعال میکند.
پیادهسازی عملی با aimake
این چرخش معماری، هسته اصلی aimake است؛ لایهای جدید که برای قرارگیری زیر چارچوبهای عامل طراحی شده است. aimake بهجای جایگزینی ابزارهایی مثل LangGraph یا CrewAI، بهعنوان زیرساختی برای ردیابی وابستگیها و حافظه پنهان عمل میکند و مفاهیم ساخت افزایشی را به خط لولههای هوش مصنوعی و یادگیری ماشین میآورد.
این ابزار با برنامه هوش مصنوعی بهعنوان لایهای روی یک گراف وابستگی برخورد میکند که خود روی یک سیستم ساخت افزایشی قرار دارد و در نهایت حافظه پنهان، استفاده مجدد و اجرا را مدیریت میکند. این ساختار تضمین میکند که فقط بخشهایی از سیستم که ورودیهایشان واقعاً تغییر کرده، دوباره محاسبه شوند. در برنامههای بزرگ، بخش گرانقیمت همیشه فراخوانی مدل نیست؛ بلکه محاسبات پیرامونی است: پردازش دادهها، تولید بردارها، ساخت شاخصها، اجرای مسیرهای حرکت و تولید گزارشها. این تمرکز بر بهینهسازی زیرساختی، بخشی از یک تغییر کلیتر است که در ۳ رکن تبدیل سریع ایدهها به محصول در معماری جدید هوش مصنوعی به آن پرداختیم.
چالشهای حلنشده
با وجود مزایا، پرسشهای باز زیادی برای جامعه توسعهدهندگان وجود دارد. مهمترین آنها «غیرقطعی بودن» (Non-determinism) است. چون مدلهای زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن جواب میدهد — ممکن است برای یک پرامپت یکسان، خروجیهای متفاوتی تولید کنند، هشینگ محتوا بهتنهایی نمیتواند نتایج یکسان را تضمین کند.
سایر موانع عبارتاند از:
- تغییر مدلهای خارجی (Model Drift): وقتی ارائهدهنده مدل را پشت API بهروز میکند، ورودیهای محلی ثابت میمانند اما خروجی تغییر میکند.
- حافظه عامل: بهروزرسانی حافظه میتواند بخشی از جریان کاری را باطل کند بدون اینکه همه چیز را از بین ببرد.
- ارزیابی احتمالی: برخی ارزیابان خود غیرقطعی هستند و حافظه پنهان کردن آنها ریسکپذیر است.
- زمانبندی توزیعشده: با رشد گرافها، سیستم باید اجرای موازی و زمانبندی آگاه از منابع را در خوشهها مدیریت کند.
برای توسعهدهنده، این تغییر به معنای گذار از «اجرای یک اسکریپت» به «مدیریت یک ساخت» است. این رویکرد، مهندسی هوش مصنوعی را کمتر شبیه به علوم داده و بیشتر شبیه به مهندسی نرمافزار سنتی میکند که در آن بازتولیدپذیری و کارایی در زیرساخت تعبیه شده است. با این حال، افزایش سرعت تولید کد لزوماً به معنای بهرهوری نیست و میتواند منجر به تلههای جدیدی شود، همانطور که در تحلیل چالش «چه بسازیم» در برابر «چگونه بسازیم» در عصر ابزارهای کدنویسی اشاره کردیم. آینده توسعه هوش مصنوعی، مجموعهای از فراخوانیهای مجزای LLM نیست، بلکه یک گراف محاسباتی از مدلها، عاملها، ابزارها، بازیابی، حافظه، دادهها، پرامپتها، ارزیابیها و آزمایشها است.
گام بعدی شما
- اگر از LangGraph یا CrewAI استفاده میکنید، ساختار جریانهای خود را به صورت گرافهای وابستگی ترسیم کنید تا نقاط تکراری را شناسایی کنید.
- برای کاهش هزینههای API، لایهای از حافظه پنهان (Caching) را بر اساس هشِ ورودیها و پرامپتها در مراحل پیشپردازش پیاده کنید.
- در ارزیابیهای خود، ردپاهای (Traces) اجرای مدل را ذخیره کنید تا هنگام تغییر معیارهای ارزیابی، نیاز به اجرای مجدد مدل نباشد.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو