
تصور کنید در حال تایپ یک پیام هستید و گوشی شما دقیقاً کلمهای را پیشنهاد میدهد که در ذهن داشتید؛ این جادوی لحظهای، محصول یک موتور شمارش ساده است. در حالی که جهان به سمت شبکههای عصبی عظیم حرکت کرده، N-gram همچنان کارآمدترین ابزار برای وظایف متنی با سرعت بسیار بالا باقی مانده است. پیش از ظهور ترنسفورمرها، پیش از جاسازیهای کلمات (word embeddings) و پیش از آنکه عبارت «توجه تنها چیزی است که نیاز دارید» (attention is all you need) رایج شود، سیستمهای تکمیل خودکار از طریق شمارشهای ساده کار میکردند.
مدلسازی زبان مدتها پیش از عصر «توجه» آغاز شد. برای دههها، صنعت بر فرض مارکوف تکیه داشت؛ ایدهای که میگوید کلمه بعدی در یک جمله فقط به چند کلمه قبلی بستگی دارد، نه به کل تاریخچه گفتگو. این سادهسازی، مسئله پیچیده زبان انسان را به یک نسبت محاسباتی از شمارشها تبدیل کرد.
مکانیسمهای شمارش
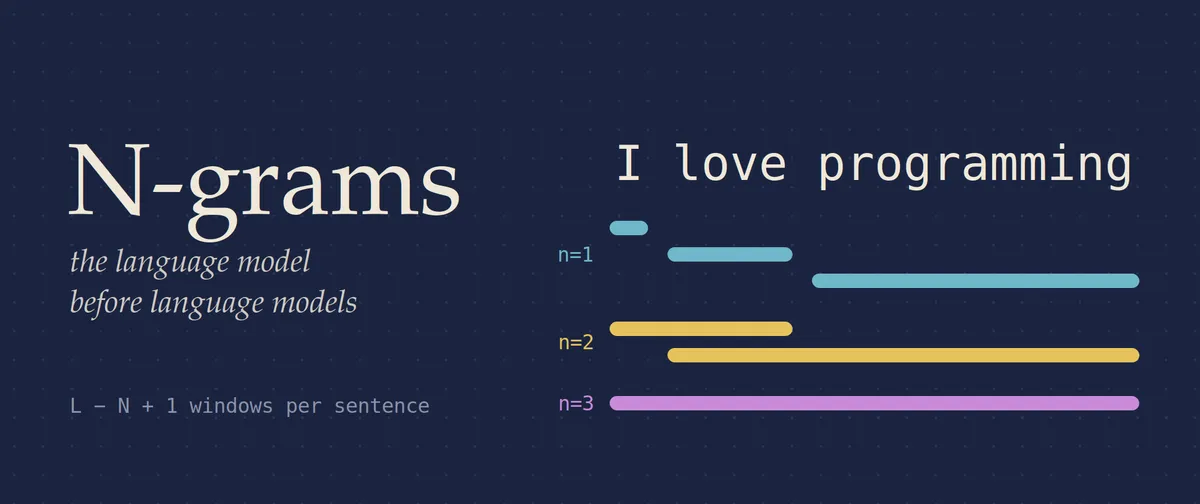
یک N-gram بهسادگی یک توالی متوالی از N مورد از یک متن است. این موارد معمولاً کلمات هستند، اگرچه میتوانند کاراکترها باشند. منطق آن بسیار مستقیم است: شما یک پنجره به اندازه N را روی یک جمله میلغزانید، هر بار یک موقعیت جلو میروید و هر توالی را که پنجره میبیند، جمعآوری میکنید.
جمله «من برنامهنویسی را دوست دارم» را در نظر بگیرید:
- تکگرامها (Unigrams - N=1): پنجره تنها یک کلمه را نگه میدارد: [«من»، «دوست دارم»، «برنامهنویسی»]. مدل در اینجا شبیه به یک «کیسه کلمات» (bag of words) عمل میکند. مدل میداند کلماتی مثل «سگ» و «گاز میگیرد» ظاهر شدهاند، اما ترتیب آنها را نمیفهمد. برای یک مدل تکگرام، جملات «سگ گاز میگیرد مرد را» و «مرد گاز میگیرد سگ را» کاملاً یکسان هستند.
- دو-گرامها (Bigrams - N=2): پنجره دو کلمه را نگه میدارد: [«من دوست دارم»، «دوست دارم برنامهنویسی»]. در اینجا ترتیب اهمیت مییابد. عبارت «سگ گاز میگیرد» اکنون از «گاز میگیرد سگ» متمایز است، بنابراین ترتیب کلمات بالاخره معنا پیدا میکند.
- سه-گرامها (Trigrams - N=3): پنجره سه کلمه را نگه میدارد: [«من برنامهنویسی را دوست دارم»]. در این سطح، زمینه محلی (local context) شکل میگیرد. عباراتی مانند «یادگیری ماشین» به عنوان مفاهیم واحد در نظر گرفته میشوند و نفیهایی مانند «خوب نیست» ثبت میشوند، که مانع از آن میشود که مدل یک نقد را با تعریف اشتباه بگیرد.
از نظر ریاضی، یک جمله با L کلمه، تعداد L - N + 1 N-gram تولید میکند. برای مثال، سه کلمه با پنجرهای به اندازه دو، دو عدد دو-گرام تولید میکند؛ و سه کلمه با پنجرهای به اندازه سه، یک سه-گرام میدهد. اگر N را برای یک جمله سه کلمهای به عدد چهار برسانید، هیچ نتیجهای نمیگیرید زیرا پنجره از طول جمله بزرگتر است.
در زبان پایتون، کل این عملیات را میتوان در یک خط کد نوشت:def ngrams(tokens, n): return [tuple(tokens[i:i + n]) for i in range(len(tokens) - n + 1)]
کتابخانههایی مانند nltk و scikit-learn این ابزارها را بهصورت پیشفرض از طریق nltk.util.ngrams یا آرگومان ngram_range در CountVectorizer و TfidfVectorizer ارائه میدهند.
تبدیل شمارشها به پیشبینی
برای حرکت از توصیف به سمت پیشبینی، N-gramها از احتمال استفاده میکنند. هدف یک مدل زبانی این است که با تعیین میزان محتمل بودن یک رشته کلمات خاص، به یک جمله امتیاز دهد. قانون زنجیرهای احتمال، این فرآیند را به حاصلضرب احتمالات کلمه بعدی تجزیه میکند:
$P(w_1, w_2, \dots, w_n) = P(w_1) \cdot P(w_2 \mid w_1) \cdot P(w_3 \mid w_1, w_2) \dots$
شرطی کردن بر اساس تکتک کلمات قبلی غیرممکن است، زیرا شما باید دقیقاً همان پیشوند را قبلاً در دادهها دیده باشید. مدل N-gram برای فرار از این مشکل از فرض مارکوف استفاده میکند: فقط N-1 کلمه آخر اهمیت دارند. یک مدل دو-گرام همه چیز را به جز کلمه بلافاصله قبلی دور میاندازد:
$P(w_n \mid w_1, \dots, w_{n-1}) \approx P(w_n \mid w_{n-1})$
این تقریب عمداً اشتباه است تا سیستم قابل محاسبه باشد. احتمال در اینجا تبدیل به نسبت دو شمارش میشود: $P(\text{programming} \mid \text{love}) = \frac{\text{count}(\text{love programming})}{\text{count}(\text{love})}$.
اگر کلمه «love» ۱۰,۰۰۰ بار در یک مجموعه داده (corpus) ظاهر شود و عبارت «love programming» ۴۰ بار تکرار شده باشد، احتمال برابر با ۰.۰۰۴ است. یک مدل دو-گرام کلمه بعدی را با نگاه کردن به تمام ادامههایی که تا به حال بعد از یک کلمه خاص دیده است پیشبینی میکند و آنها را بر اساس تکرار رتبهبندی میکند:
- love you: 820 (0.082)
- love it: 610 (0.061)
- love this: 450 (0.045)
- love programming: 40 (0.004)
- love pizza: 35 (0.0035)
این ساختار دقیقاً مشابه نحوه عملکرد یک LLM مدرن در گام نهایی است؛ تنها تفاوت در نحوه محاسبه توزیع احتمالات است. برای درک عمیقتر از نحوه پیادهسازی این مفاهیم در محیطهای عملیاتی، میتوانید نقشه راه ۲۰۲۶ برای استقرار مدلهای زبانی در مقیاس صنعتی را مطالعه کنید.
موازنه مقدار N
انتخاب مقدار N یک تعادل بین دو حالت شکست است. مقادیر کوچک N بهخوبی تعمیم مییابند زیرا بهندرت با توالیای روبرو میشوند که قبلاً ندیدهاند، اما متنی تولید میکنند که در سطح کلی «بیمعنی» است. هر جفت کلمه مجاور درست به نظر میرسد، اما جمله در کل معنای خاصی ندارد.
مقادیر بزرگ N پیشبینیهای دقیق و تیزی ارائه میدهند اما تعمیمپذیری آنها وحشتناک است. یک مدل ۵-گرام که دقیقاً پیشوند چهار کلمهای شما را دیده باشد، حدس فوقالعادهای میزند، اما در بیشتر مواقع، چنین پیشوندی را ندیده است و چیزی برای گفتن ندارد.
شمارشها این موازنه را آشکار میکنند. با یک واژگان ۵۰,۰۰۰ کلمهای:
- دو-گرامهای ممکن: $2.5 \times 10^9$
- سه-گرامهای ممکن: $1.25 \times 10^{14}$
هیچ مجموعه دادهای به اندازه کافی بزرگ نیست که این فضای احتمالات را پوشش دهد. به همین دلیل، سه-گرامها معمولاً مصالحه استاندارد برای مدلهای سطح کلمه هستند. N-gramهای سطح کاراکتر میتوانند مقادیر بالاتری (اغلب ۴ تا ۶) داشته باشند، زیرا الفبا کوچک است و فضای احتمالات قابل مدیریت باقی میماند.
حل مشکل پراکندگی (Sparsity)
وقتی مدل با توالیای روبرو میشود که هرگز ندیده است، شمارش آن صفر است، بنابراین احتمال صفر میشود. چون احتمال جمله حاصلضرب احتمالات است، یک صفر کل احتمال جمله را به صفر میکشاند. مدل گزارش نمیدهد که «اطمینان کمی دارد»، بلکه گزارش میدهد که این جمله «غیرممکن» است. این همان مشکل پراکندگی دادههاست.
مهندسان برای حل این مشکل از چندین تکنیک استفاده میکنند:
- هموارسازی لاپلاس (Add-one Smoothing): این روش تظاهر میکند که هر N-gram ممکن، یک بار بیشتر دیده شده است: $P(w_2 \mid w_1) = \frac{\text{count}(w_1, w_2) + 1}{\text{count}(w_1) + V}$، که در آن V اندازه واژگان است. این روش ابتدایی است و مقدار زیادی از جرم احتمالی را از توالیهای مشاهدهشده میدزدد.
- عقبنشینی (Backoff): این روش از مشخصترین شواهد موجود استفاده میکند. اگر یک سه-گرام موجود نباشد، به دو-گرام رجوع میکند؛ و اگر آن هم نبود، به تک-گرام برمیگردد. این باعث میشود مدل بهجای فروپاشی، بهصورت تدریجی کیفیتش کاهش یابد.
- درونیابی (Interpolation): این روش تمام مرتبهها را بهطور همزمان با استفاده از میانگینهای وزنی ترکیب میکند: $\hat{P}(w_3 \mid w_1, w_2) = \lambda_1 P(w_3 \mid w_1, w_2) + \lambda_2 P(w_3 \mid w_2) + \lambda_3 P(w_3)$، بهطوری که $\lambda_1 + \lambda_2 + \lambda_3 = 1$.
سیستمهای پیشرفتهتر در گذشته از هموارسازی کنزر-نی (Kneser-Ney) استفاده میکردند. بینش این روش این است که تکرار خام، سیگنال درستی برای عقبنشینی نیست. برای مثال، کلمه «Francisco» رایج است، اما تقریباً منحصراً بعد از «San» میآید. بنابراین در یک زمینه جدید، حدس بدی است. روش کنزر-نی بر اساس اینکه یک کلمه در چند «زمینه متمایز» ظاهر شده است عقبنشینی میکند، نه بر اساس اینکه چند بار تکرار شده است.
اندازهگیری موفقیت با Perplexity
طبق گزارش dev.to منتشر شده در ۳۰ سپتامبر ۲۰۲۶، معیار استاندارد برای این مدلها Perplexity (پراکندگی) است. این مقدار، معکوس احتمالی است که مدل به یک مجموعه تست اختصاص میدهد و بر اساس طول متن نرمال شده است: $PP(W) = P(w_1, w_2, \dots, w_n)^{-\frac{1}{n}}$.
آن را به عنوان «ضریب شاخهزنی» متوسط مدل بخوانید. پراکندگی ۱۰۰ به این معناست که مدل همانقدر مردد است که انگار در هر موقعیت، بهطور یکنواخت از بین ۱۰۰ کلمه انتخاب میکند. هرچه این عدد کمتر باشد، بهتر است.
مدلهای سه-گرام سطح کلمه معمولاً در بنچمارکهای انگلیسی بین ۱۰۰ تا ۲۰۰ پراکندگی دارند. در مقابل، مدلهای عصبی مدرن اغلب زیر ۲۰ هستند. این شکاف عظیم دقیقاً دلیلی است که صنعت به سمت ترنسفورمرها تغییر مسیر داد. نکته حیاتی این است که Perplexity باید همیشه روی متنی محاسبه شود که مدل در زمان آموزش ندیده است (held-out text)؛ ارزیابی روی دادههای آموزشی فقط نشان میدهد که مدل پاسخها را حفظ کرده است.
جاهایی که N-gramها هنوز برنده هستند
با وجود ظهور LLMها، N-gramها هنوز برای چندین نیاز عملیاتی انتخاب درستی هستند زیرا به GPU نیاز ندارند، در چند ثانیه آموزش میبینند و کاملاً تفسیرپذیر هستند.
- طبقهبندی متن: ترکیب تکگرامها و دو-گرامها با یک
TfidfVectorizerو یک SVM خطی یا رگرسیون لجستیک، یک خط پایه (baseline) قوی برای تشخیص اسپم و تحلیل احساسات است. شما میتوانید دقیقاً به دو-گرامی اشاره کنید که باعث طبقهبندی خاصی شده است. - جستوجو و تکمیل خودکار: پیشنهادهای کوئری هنوز بهشدت بر تکرار N-gramها در لاگهای جستوجو تکیه دارند. این روش سریع است و بدون نیاز به سرور استنتاج (inference server)، تایپ واقعی کاربر را منعکس میکند.
- تصحیح غلط املایی: تصحیح حساس به زمینه، وظیفه N-gram است. تصمیمگیری بین «their» و «there» مستلزم مقایسه احتمال سه-گرامهای اطراف است.
- توکنسازی: الگوریتم Byte Pair Encoding (BPE) که تقریباً توسط هر LLM مدرنی استفاده میشود، واژگان خود را با ادغام مکرر رایجترین جفتهای کاراکتر مجاور میسازد. این در واقع همان شمارش دو-گرامهای کاراکتری است که درون مدلهایی اجرا میشود که جایگزین N-gramها شدهاند.
- تشخیص سرقت ادبی: تبدیل اسناد به N-gramهای کاراکتری یا کلمهای (shingling) و مقایسه مجموعهها از طریق MinHash، استاندارد صنعت برای یافتن محتواهای تقریباً مشابه است.
- شناسایی زبان: پروفایلهای سه-گرام کاراکتری میتوانند زبانها را بهطور چشمگیری از هم جدا کنند، با طبقهبندهایی که تنها در چند کیلوبایت جا میشوند.
محدودیت مرگبار
N-gramها زمانی شکست میخورند که یک وابستگی خارج از پنجره وجود داشته باشد. اگر یک فعل باید با اسمی که ده کلمه قبل آمده مطابقت داشته باشد — مانند «کلیدهایی که دیروز بعدازظهر روی پیشخوان آشپزخانه گذاشتم [بودند/بود]» — یک مدل سه-گرام نسبت به آن کور است. مدل فقط «دیروز بعدازظهر» را میبیند و نمیتواند به «کلیدها» بازگردد.
علاوه بر این، N-gramها با کلمات به عنوان نمادهای کدر (opaque symbols) برخورد میکنند. برای یک مدل شمارشی، «گربه» و «سگ» دو کلید بیربط در یک جدول هش (hash table) هستند. مدل نمیتواند دانش را بین کلمات مشابه منتقل کند، به این معنی که هر توالی باید بهطور مستقل مشاهده شود.
مدلهای عصبی این مشکل را با جایگزینی نمادها با بردارهای متراکم (embeddings) و جایگزینی پنجره ثابت با مکانیسمهای توجه (attention) حل کردند. این رویکرد به مدل اجازه میدهد تا مفاهیم پیچیده بصری و متنی را با بهینهسازی فضای ذخیرهسازی مدیریت کند؛ برای مثال، مدل NeoMME هزینهٔ ذخیرهسازی بردارهای بصری را ۲۵۵ برابر کاهش داد تا کارایی سیستمهای چندوجهی افزایش یابد. این به مدل اجازه میدهد در حالی که موقعیت ۴۰۰ را پیشبینی میکند، به موقعیت ۱۲ نگاه کند؛ دستاوردی که هیچ مقدار تنظیم N نمیتواند به آن برسد.
درک N-gramها در سال ۲۰۲۶ به معنای استفاده از آنها به عنوان مدل اصلی نیست. بلکه به معنای دیدن اسکلت مدلسازی زبان است — پیشبینی توکنها از روی زمینه، امتیازدهی به توالیها با حاصلضرب احتمالات شرطی، و مبارزه با تنش بین حفظ کردن و تعمیم دادن — در سادهترین شکل آن. همین ساختار در دل یک ترنسفورمر نیز وجود دارد، اما زیر لایههای زیادی از ماشینآلات پیچیده دفن شده است.
گام بعدی شما
- اگر در حال ساخت یک سیستم طبقهبندی متن ساده هستید، پیش از استفاده از مدلهای سنگین، ترکیب
TfidfVectorizerوLogistic Regressionرا امتحان کنید. - برای بهینهسازی سرعت جستوجوی داخلی سایت، از شمارش N-gramهای کاراکتری برای شناسایی سریع زبان کاربر استفاده کنید.
- در تحلیل دادههای متنی، از N-gramها برای استخراج عبارات کلیدی پرتکرار (Collocations) استفاده کنید تا الگوهای پنهان در متن را بیابید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو