تصور کنید مدلی با ۲۶۰ میلیون پارامتر بتواند از رقیبانی که تقریباً ۱۴ برابر بزرگتر هستند، عملکرد بهتری داشته باشد. این واقعیتِ NeoMME است؛ خانوادهای از رمزگذارهای چندوجهی که در ۳ سپتامبر ۲۰۲۶ توسط Hugging Face منتشر شد و نیاز به مدلهای زبانی علی (Causal Language Models) یا برجهای بینایی پیشآموزشدیده مجزا را بهطور کامل حذف کرد.
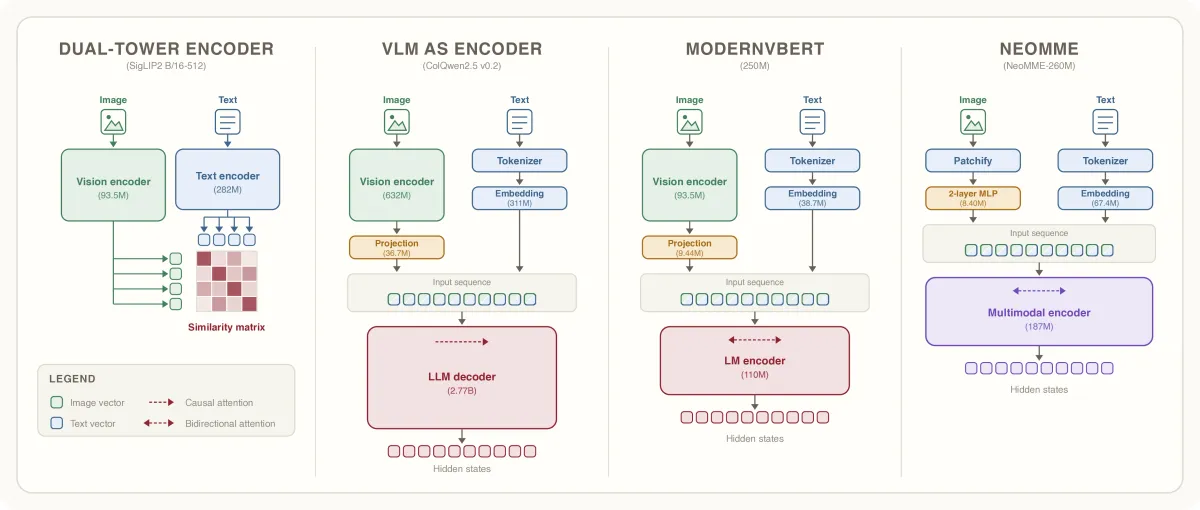
بسیاری از سیستمهای بازیابی اسناد بصری فعلی، از مدلهای مولد (Generative Models) اقتباس شدهاند. این مدلها از یک رمزگذار بینایی مجزا برای تولید ویژگیها استفاده میکنند و سپس یک لایه سازگارساز (Projector) این دادهها را به فضای یک مدل زبانی منتقل میکند. طبق گزارش توسعهدهندگان، این معماری بهدلیل اتکا به یک رمزگشای علی (Causal Decoder) که برای تولید متن بهصورت خودبازگشتی (Autoregressively) طراحی شده، بار محاسباتی سنگینی ایجاد میکند.
اما برای کارهایی مثل بازیابی (Retrieval)، طبقهبندی (Classification) و برچسبگذاری توکنها، نیازی به تولید متن نیست؛ بلکه درک دوطرفه (Bidirectional) از ورودی لازم است. NeoMME (تلفظ: «نی-او-می» /niː.oʊ.mi/) این مشکل را با استفاده از یک ترنسفورمر دوطرفه واحد حل میکند که متن و تکههای خام تصویر را از ابتدا بهصورت یکپارچه پردازش میکند.
معماری چندوجهی بومی
مدل NeoMME در دو اندازه ۲۶۰ و ۸۰۰ میلیون پارامتری عرضه شده است. برخلاف مدلهای دو-برجی (Dual-tower) و رمزگذارهای VLM، این مدل از یک مسیر محاسباتی واحد برای هر دو وجه (متن و تصویر) استفاده میکند. این رویکرد یادآور مفاهیم ادغام میانی (Intermediate Fusion) است که استدلال بومی را در مدلهای چندوجهی تسهیل میکند. این طراحی باعث میشود پیشآموزش، تنظیم دقیق (Fine-tuning)، موازیسازی و سرویسدهی مدل در هر دو حوزه متن و تصویر بسیار سادهتر شود.
در این ساختار، ورودیهای متنی از بردارهای معنایی فاکتورشده (Factorized Token Embeddings) استفاده میکنند. تصاویر نیز به شبکهای از تکههای غیرهمپوشان ۳۲×۳۲ تقسیم شده و از طریق یک MLP کوچک تصویر شده و وارد همان ترنسفورمر میشوند.
یکی از ویژگیهای کلیدی این مدل، پشتیبانی از رزولوشن پویا است. مدل نسبت و اندازه اصلی تصویر را حفظ میکند. این قابلیت به مدل اجازه میدهد تا برای یک صفحه سند با رزولوشن بالا و تراکم اطلاعات زیاد، توکنهای بیشتری نسبت به یک تصویر ساده با محتوای کمتر اختصاص دهد.
NeoMME دارای یک پنجره متنی (Context Window) دوطرفه با ظرفیت ۱۶,۳۸۴ توکن است. این مقدار برای پردازش تا دو تصویر استاندارد 4K UHD با رزولوشن ۳۸۴۰×۲۱۶۰ کافی است.
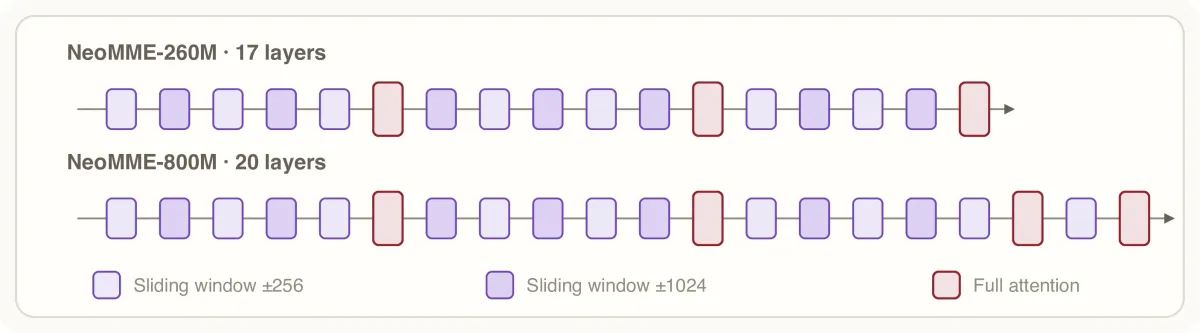
در لایههای این مدل، ترکیبی از توجه پنجرهای لغزان متقارن (Symmetric Sliding-window Attention) و توجه جهانی (Global Attention) به کار رفته است. هر ششمین لایه و لایه نهایی از توجه جهانی استفاده میکنند تا بستر کلی دادهها (Broad Context) حفظ شود. بهبودهای فنی دیگر شامل Grouped-Query Attention، نرمالسازی پرسوجو-کلید (Query-Key Normalization)، توجه گیتدار (Gated Attention)، رمزگذاری موقعیت دو-بعدی (2D RoPE) و MLPهای Squared-ReLU است.
قابلیتهای چندزبانه و آموزش
تیم توسعه برای پشتیبانی از طیف گستردهای از ورودیها، یک توکنساز BPE را از ابتدا آموزش داد. این توکنساز دارای دایره لغات ۱۳۱ هزار توکنی است. دادههای آموزشی این توکنساز بسیار متنوع بود و موارد زیر را پوشش میداد:
- متون چندزبانه
- کدهای برنامهنویسی
- ریاضیات
- نسخههای متنی تصاویر تولید شده توسط ماشین
همانطور که در تحلیلهای قبلی ما دربارهی بهینهسازی مدلهای بازمتن اشاره کردیم، بهرهوری دادهها در مدلهای کوچکتر حیاتی است. به همین دلیل، NeoMME بهعنوان یک حذفکننده نویز متنی با روش انتشار ماسکشده (Masked Diffusion) آموزش دیده است. برای نمونههای متنی خالص، مدل یک نرخ تخریب را بهطور یکنواخت بین ۰ و ۱ نمونهبرداری میکند تا توکنهای متنی واجد شرایط را بهطور مستقل ماسک کند.
در نمونههای چندوجهی، نرخ تخریب بین ۰.۳ تا ۱ متغیر است. در حالی که تکههای تصویر قابل مشاهده هستند، مدل باید متنهای ماسکشده را بازسازی کند.
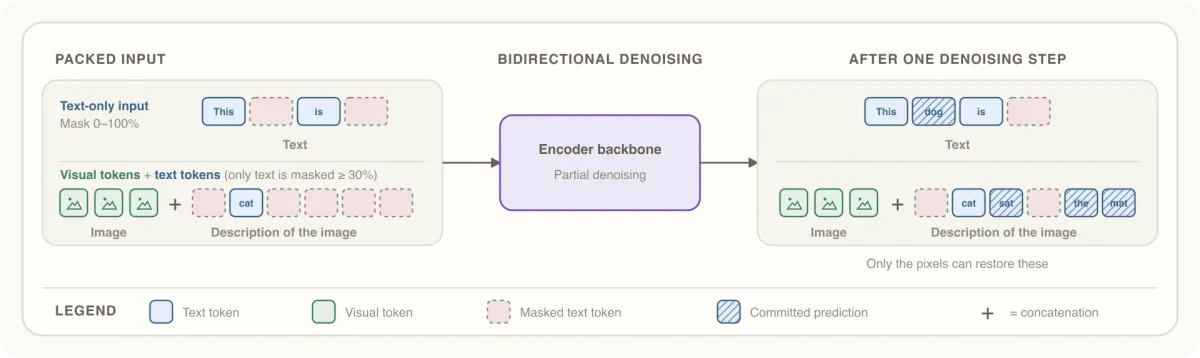
نرخهای بالای ماسکگذاری، مدل را مجبور میکند بهجای تکیه بر میانبرهای زبانی، از شواهد تصویری استفاده کند. برای مثال، در جمله «[MASK] روی فرش نشست»، کلمه «گربه» بدون تصویر یک تکمیل محتمل است، اما ماسکگذاری شدید این میانبرها را حذف کرده و مدل را تشویق میکند تا از شواهد بصری موجود در تصویر استفاده کند. این فرآیند تضمین میکند که مدل واقعاً توصیفات مبنی بر تصویر (Image-grounded) را بیاموزد.
پیشآموزش این مدل شامل ۵۲۴ میلیارد توکن ورودی بستهبندی شده بود. این مجموعه شامل متون چندزبانه، کد، ریاضیات و تصاویر طبیعی و اسنادی بود. از این مقدار، ۲۹۰ میلیارد توکن مربوط به نمونههای متنی خالص بود. بهدلیل کم بودن این بودجه متنی در مقایسه با بودجه ۲ تریلیون توکنی ModernBERT، تیم از بهینهساز NorMuon برای افزایش بهرهوری دادهها در طول آموزش استفاده کرد.
عملکرد NeoMME-Retriever
برای آزمایش این ساختار، مدل NeoMME-Retriever ساخته شد. این مدل بهجای استفاده از نویسهخوانی نوری (OCR) — که اغلب جداول و نمودارها را تخت میکند — از متدولوژی تصویر-صفحه (Page-image) مشابه ColPali استفاده میکند و اسکرینشاتهای اسناد را رتبهبندی میکند.
این روش باعث میشود چیدمان، نمودارها و جداول حفظ شوند. همچنین نوع و اندازه فونت و سایر سرنخهای بصری که حتی توسط یک مدل OCR کامل نیز قابل ثبت نیستند، استخراج شوند. این بازیاب از یک طراحی دو-سره استفاده میکند:
- سره متراکم (Dense Head): بردارهای حالت پنهان مدل را از طریق میانگینگیری (Mean Pooling) به یک بردار واحد نرمالشده تبدیل میکند. این بردارها فشرده هستند و بهطور طبیعی با تکنیکهای نزدیکترین همسایه تقریبی (ANN) برای بازیابی سریع سازگارند.
- سره تعامل دیرهنگام (Late-Interaction Head): هر توکن متنی یا تکه تصویر را از حالتهای پنهان خروجی به یک بردار ۱۲۸-بعدی نرمالشده تبدیل میکند. این دانهبندی ظریفتر، تطابقهای محلی بین توکنهای پرسوجو و نواحی تصویر را حفظ میکند.
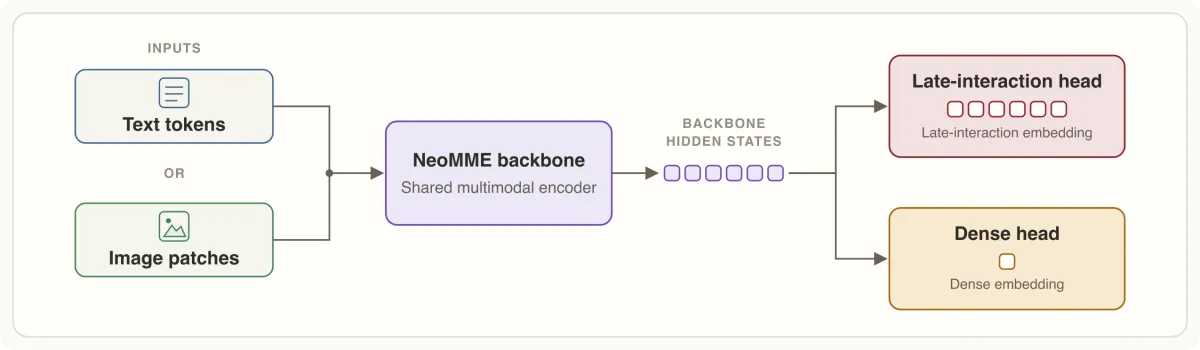
عمر خطاب (Omar Khattab)، خالق ColBERT، اشاره میکند که اصطلاح «تعامل دیرهنگام» دقیقتر از «چند-برداری» است، زیرا به دانهبندی و قابلیت یادگیری تابع امتیازدهی اشاره دارد، نه صرفاً تعداد بردارها.
یک پاس پیشرو (Forward Pass) در NeoMME-Retriever هر دو نمایش را برمیگرداند. این به کاربران اجازه میدهد از جاسازیهای متراکم برای بازیابی اولیه از مجموعههای بزرگ و از جاسازیهای تعامل دیرهنگام برای رتبهبندی مجدد (Reranking) با دقت بالا استفاده کنند. تیم توسعه بهطور کلی استفاده از تعامل دیرهنگام را توصیه میکند زیرا قدرتمندتر است و با کتابخانههایی مانند NextPlaid سازگار است.
بنچمارکها و رکوردشکنی
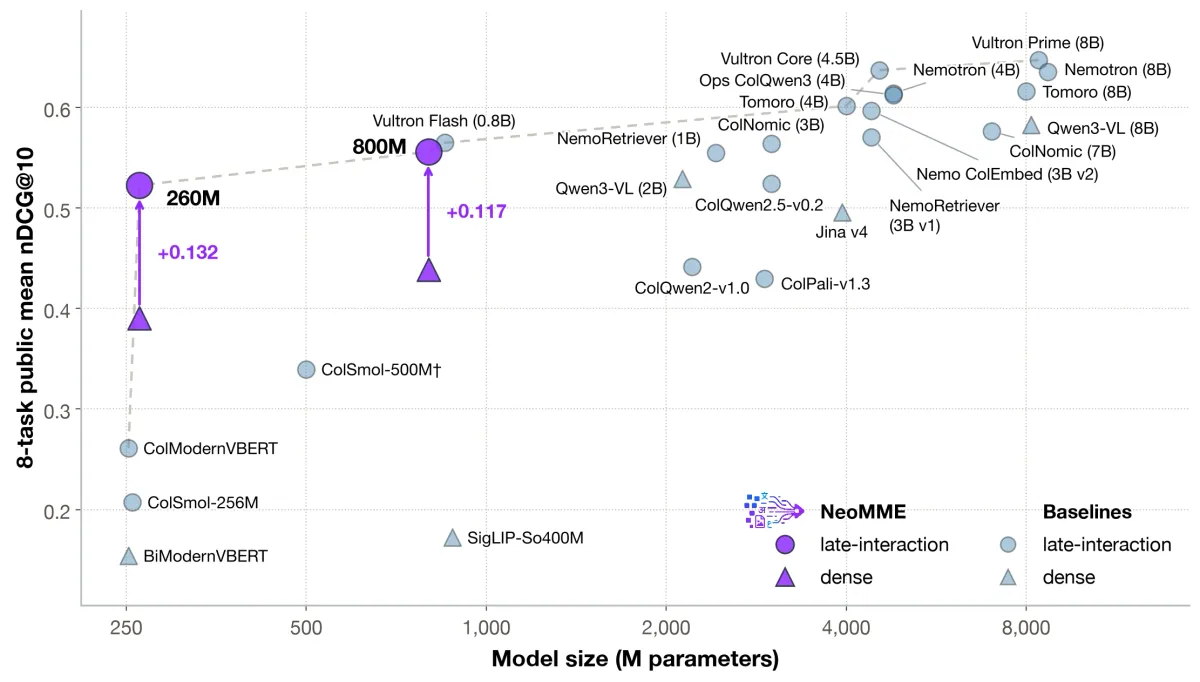
در محک ViDoRe v3، مدل NeoMME-Retriever-260M به امتیاز nDCG@10 برابر با ۰.۵۲۳ رسید. این بالاترین امتیاز برای هر مدلی است که تعداد پارامترهای آن اکیداً زیر ۸۰۰ میلیون است.
این مدل در حالی این نتیجه را گرفت که تنها ۰.۰۰۲ nDCG@10 با ColQwen2.5 فاصله دارد، در حالی که حدود ۱۴ برابر پارامتر کمتری مصرف میکند. نسخه ۸۰۰ میلیونی نیز به امتیاز ۰.۵۵۶ رسید و هر دو مدل را در مرز بهینه (Pareto Frontier) اندازه-عملکرد قرار داد.
در نسخههای دیگر ViDoRe نیز قدرت این مدل مشهود است:
- ViDoRe v2 (nDCG@5): مدل ۲۶۰ میلیونی با امتیاز ۰.۵۲۲، مدلهای ColModernVBERT (۰.۴۰۷) و ColSmol-500M (۰.۴۵۵) را شکست داد.
- ViDoRe v1 (nDCG@5): مدل ۲۶۰ میلیونی با امتیاز ۰.۸۶۰، مدلهای ColModernVBERT (۰.۸۰۶) و ColSmol-256M (۰.۷۹۷) را پشت سر گذاشت.
- مقایسه با ColPali: مدل NeoMME-Retriever-800M عملکرد بهتری نسبت به ColPali v1.3 دارد در حالی که ۳.۶ برابر پارامتر کمتری دارد.
مقایسه دقیق مدلها
برای ارائه بستر عمیقتر، دادههای زیر NeoMME را در برابر سایر بازیابهای پیشرو در سه بنچمارک ViDoRe مقایسه میکند:
- زیر ۳۰۰ میلیون پارامتر:
- NeoMME-260M: v3 (@10) 0.523 | v2 (@5) 0.522 | v1 (@5) 0.860
- ColModernVBERT (250M): v3 (@10) 0.261 | v2 (@5) 0.407 | v1 (@5) 0.806
- ColSmol-256M: v3 (@10) 0.207 | v2 (@5) 0.348 | v1 (@5) 0.797
- ۳۰۰ میلیون تا ۱ میلیارد پارامتر:
- NeoMME-800M: v3 (@10) 0.556 | v2 (@5) 0.559 | v1 (@5) 0.874
- Vultron Flash (850M): v3 (@10) 0.565 | v2 (@5) 0.604 | v1 (@5) 0.882
- ColSmol-500M: v3 (@10) 0.340 | v2 (@5) 0.455 | v1 (@5) 0.825
- بالای ۱ میلیارد پارامتر:
- ColQwen2.5-v0.2 (3.75B): v3 (@10) 0.524 | v2 (@5) 0.601 | v1 (@5) 0.895
- ColPali v1.3 (2.92B): v3 (@10) 0.430 | v2 (@5) 0.547 | v1 (@5) 0.848
حل بحران ذخیرهسازی
ذخیرهسازی در تعامل دیرهنگام بهصورت خطی با تعداد بردارها در خروجی افزایش مییابد. یک صفحه مربع ۲۰۴۸×۲۰۴۸ حدود ۴,۲۰۰ بردار تولید میکند که در فرمت float32 تقریباً ۲.۱ مگابایت فضا میگیرد. بهطور میانگین در ViDoRe v3، هر سند حدود ۱.۵ مگابایت فضا اشغال میکند.
برای حل این مشکل، NeoMME از دو روش فشردهسازی مکمل استفاده میکند:
- تجمیع توکن سلسلهمراتبی (Hierarchical Token Pooling): بردارهای مشابه سند را در یک جاسازی چند-برداری خوشهبندی کرده و هر خوشه را با میانگین آن جایگزین میکند تا تعداد بردارهای ذخیره شده در هر صفحه کاهش یابد.
- کوانتیزاسیون نامتقارن (Asymmetric Quantization): جاسازیهای سند را به int8 یا باینری تبدیل میکند. جاسازیهای پرسوجو بهصورت لحظهای تولید شده و میتوانند در دقت بالاتر باقی بمانند. این رویکرد برای بهینهسازی حافظه حیاتی است، مشابه آنچه در بحثهای کوانتش یکپارچه در برابر ترکیبی برای حفظ جزئیات بصری بررسی شده است.
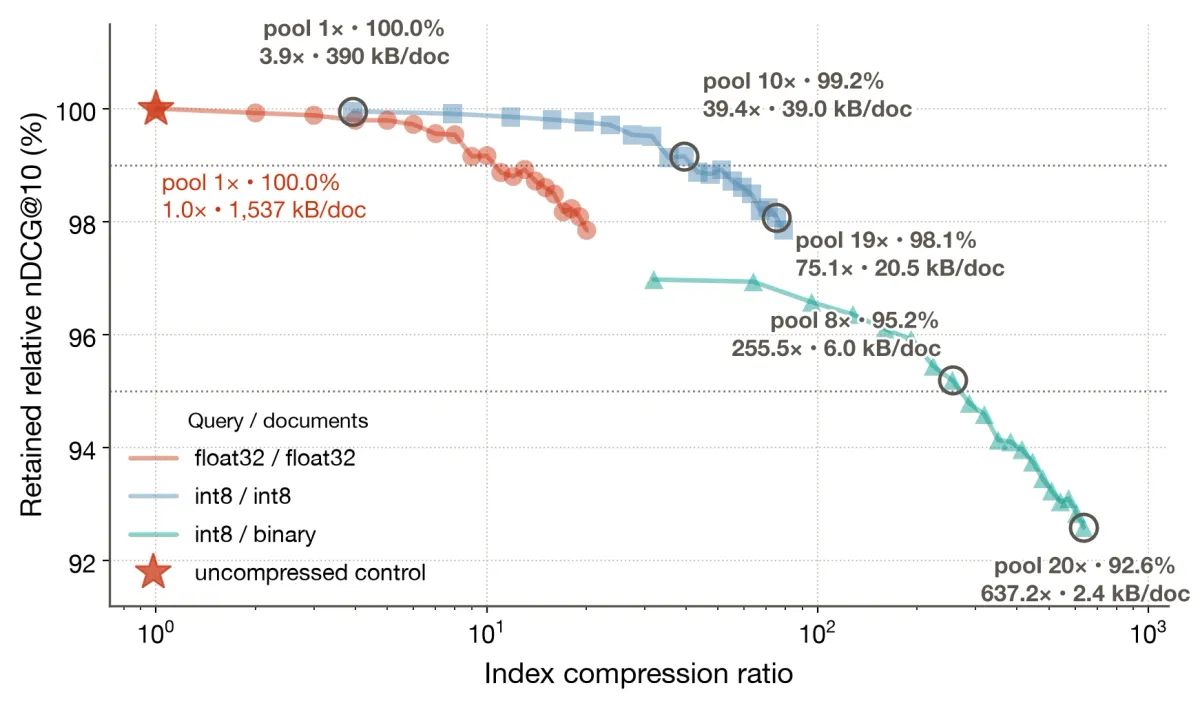
در آزمایشهای ViDoRe v3، دو پیکربندی خاص تست شد:
۱. فشردهسازی متوسط: با استفاده از فاکتور تجمیع ۱۰ و پرسوجوها/اسناد int8، فضای ذخیرهسازی از ۱.۵ مگابایت به ۳۹ کیلوبایت در هر صفحه کاهش یافت (۳۹ برابر کاهش) در حالی که بیش از ۹۹٪ از nDCG@10 پایه حفظ شد.
۲. فشردهسازی تهاجمی: با فاکتور تجمیع ۸، پرسوجوهای int8 و اسناد باینری، فضا به ۶ کیلوبایت در هر صفحه رسید. این یک کاهش ۲۵۵ برابری است در حالی که بیش از ۹۵٪ کیفیت بازیابی اصلی حفظ شد.
سرعت استنتاج و کاربرد در RAG
رمزگذاری سریعتر، هزینه GPU را برای ایندکس کردن مجموعههای بزرگ در ذخیرهسازهایی مانند Qdrant، Weaviate یا Milvus کاهش میدهد. بر روی GPU مدل NVIDIA L40S با تصاویر ۲۰۴۸×۲۰۴۸، مدل NeoMME-Retriever-260M میتواند ۵۱ صفحه را در ثانیه رمزگذاری کند.
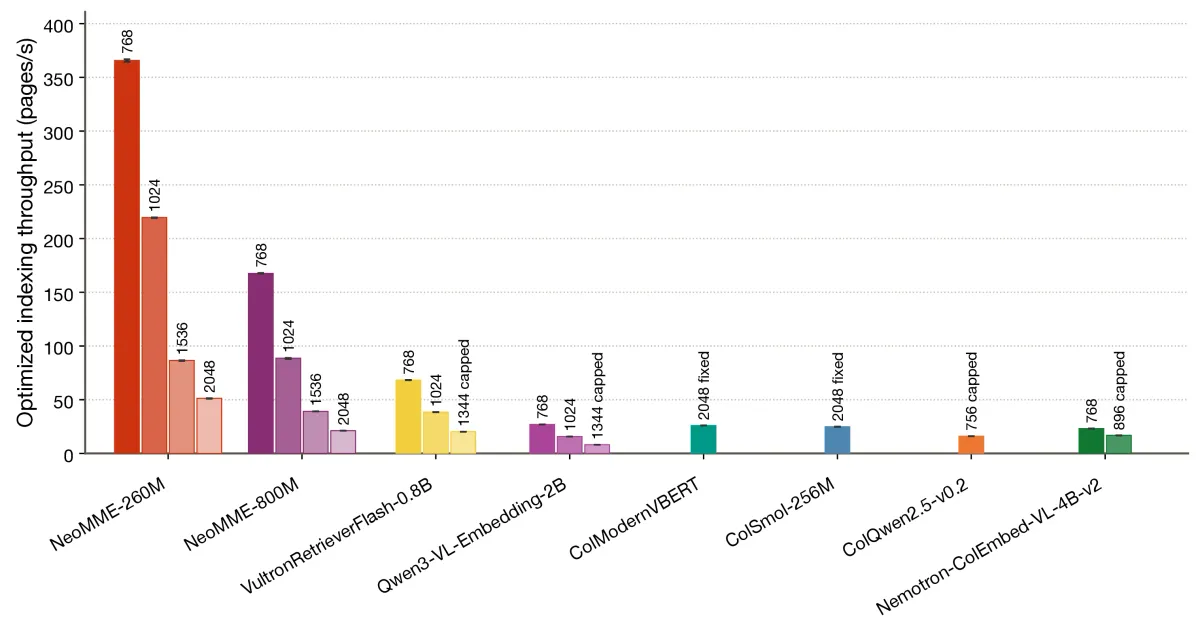
این توان عملیاتی تقریباً دو برابر ColModernVBERT است که ۲۶ صفحه در ثانیه را مدیریت میکند. هر دو اندازه NeoMME در تصاویر ورودی کوچکتر سریعتر از مدلهای مورد مقایسه هستند. این سطح از بهینگی در سرعت، مشابه اولویتهایی است که در مدل LFM2.5-VL-3B برای دستیابی به توان عملیاتی بالا در درک رابطهای کاربری دنبال شده است.
این کارایی، NeoMME را به گزینهای ایدهآل برای مرحله اول تولید بازیابیافزا (RAG) بصری تبدیل میکند. در این گردشکار:
۱. ایندکسگذاری: هر صفحه PDF به تصویر تبدیل شده، یک جاسازی با مدل بازیابی تولید شده و در یک ذخیرهساز برداری ذخیره میشود.
۲. بازیابی: یک جاسازی برای پرسوجوی کاربر با همان مدل تولید شده و مرتبطترین صفحات (top-k) استخراج میشوند.
۳. تولید: تصاویر پس از پرسوجو در پیام چت اضافه شده (مثلاً {query}{img_1}{img_2}...{img_k}) و به یک VLM ارسال میشوند تا پاسخ را تولید کند. این به VLM اجازه میدهد از جداول، نمودارها و چیدمان صفحه استفاده کند که استخراج متنی ممکن است آنها را حذف یا تخت کند.
پیادهسازی و تنظیم دقیق
این مدل در کتابخانه Transformers شرکت Hugging Face ادغام شده است. برای کسانی که قصد شخصیسازی دارند، نقاط بازرسی (Checkpoints) مجزایی برای سرههای متراکم و تعامل دیرهنگام ارائه شده تا با Sentence Transformers v6 تنظیم دقیق شوند.
به دنبال الگوی رمزگذارهای متنی مانند ModernBERT، Sentence Transformers بدنه مدل را از طریق NeoMMEModel بارگذاری میکند و نه از طریق کلاس دو-سره NeoMMEForRetrieval. از آنجایی که Sentence Transformers در حال حاضر تنها از یک سره بازیابی در هر مدل پشتیبانی میکند، این نقاط بازرسی مجزا اجازه میدهند هر سره بهطور مستقل آموزش ببیند. برای آموزش همزمان هر دو سره، توسعهدهندگان باید از NeoMMEForRetrieval با یک Trainer سفارشی استفاده کنند.
تحلیل نهایی
NeoMME این فرض را که بازیابی چندوجهی با عملکرد بالا نیازمند بدنه مولد عظیم است، تغییر میدهد. با حذف رمزگشای علی و برج بینایی مجزا، ثابت میکند که یک رمزگذار دوطرفه تخصصی برای کارهای نمایش (Representation) بسیار کارآمدتر است.
برای متخصصان، بزرگترین دستاورد، نسبت ذخیرهسازی به کیفیت است. توانایی فشردهسازی ایندکسهای تعامل دیرهنگام تا ۲۵۵ برابر، مانع اصلی استفاده از بازیابی چند-برداری در مقیاس بزرگ را از بین میبرد.
این امر به توسعهدهندگان اجازه میدهد از خط لولههای OCR پرتلف فاصله گرفته و به سمت ایندکسگذاری بصری بومی حرکت کنند، بدون اینکه هزینههای ذخیرهسازی ابری آنها به شدت افزایش یابد.
برای شروع، میتوانید نقاط بازرسی مدل را تحت لایسنس Apache 2.0 در Hugging Face Transformers بیابید. برای تنظیم دقیق، نقاط بازرسی مجزای متراکم و تعامل دیرهنگام برای Sentence Transformers v6 در دسترس هستند که بدنه مدل را از طریق NeoMMEModel بارگذاری میکنند.



گفتگو