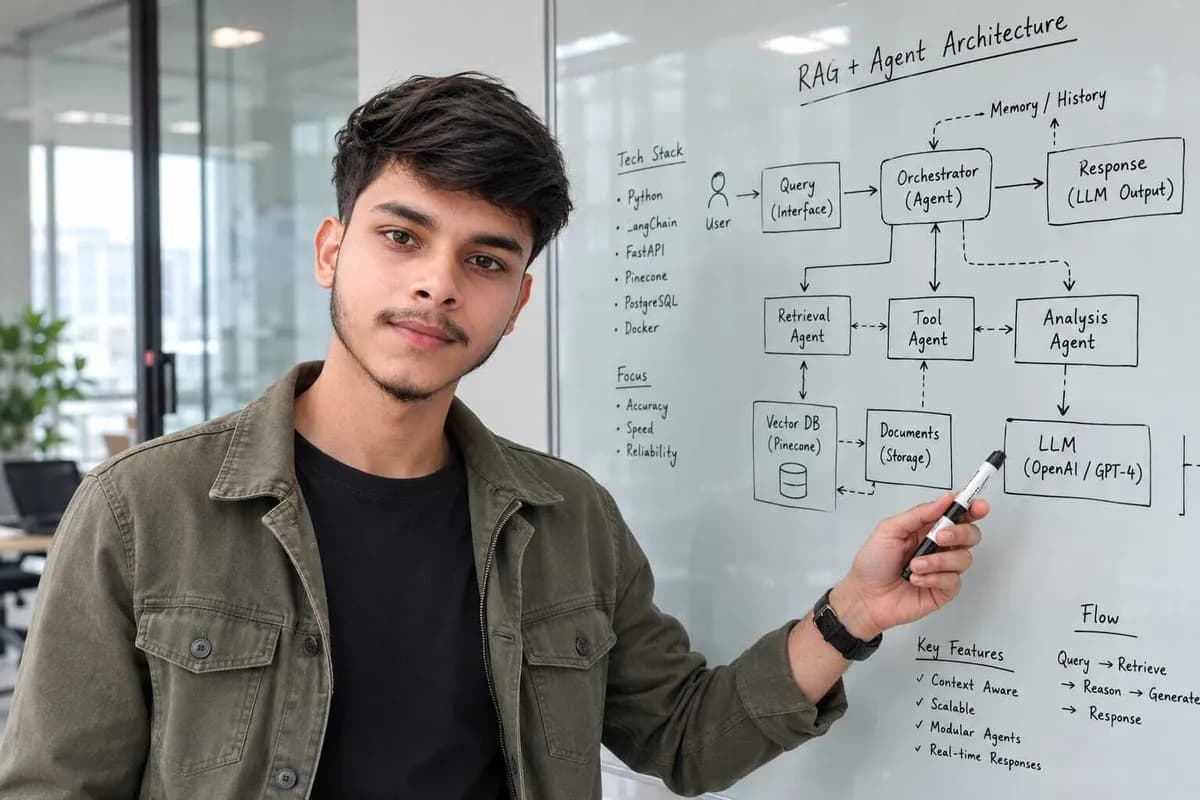
اگر امروز یک سیستم RAG را برای کاربران واقعی مستقر کردهاید، احتمالاً متوجه شدهاید که جادوی محیط نمونهسازی (Prototype) بهسرعت میپرد. بسیاری از توسعهدهندگان با تکیه بر جستوجوی برداری ساده، در مواجهه با پرسوجوهای پیچیده یا شناسههای فنی دقیق، با شکست مواجه میشوند. میتیلش کومار (Mithilesh Kumar)، مهندس هوش مصنوعی، با جزئیات توضیح میدهد که چرا رویکرد استاندارد «جستوجوی برداری به عنوان پیشفرض» در مدیریت پرسوجوهای چندبخشی پیچیده یا شناسههای فنی دقیق ناتوان است.
به نقل از کومار، اکثر نمونههای اولیه با یک جریان خطی ساده ساخته میشوند: تکهبندی چند فایل PDF، تبدیل آنها به بردار و اتصال یک جستوجوی شباهت k-برتر به یک مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد. این ساختار در حدود ۵۰ خط کد پایتون اجرا میشود و در عرض چند ثانیه پاسخ میدهد و برای سوالات ابتدایی بهطور شگفتانگیزی عالی است. اما کاربران واقعی محدودیتهایی ایجاد میکنند که این سادگی را میشکند. آنها شناسههای فنی دقیق (مثل کد خطای 0x80070005)، محدودیتهای زمانی (مثلاً: «ماه گذشته چه تغییری در سیاست استقرار ما ایجاد شد؟») یا درخواستهای چندوجهی گسترده (مثلاً: «مجموعه ویژگیهای ما را با سطح قیمتگذاری رقیب مقایسه کن») را مطرح میکنند.
در این رویکرد، فرض بر این است که شباهت معنایی لزوماً به معنای مرتبط بودن است، اما در محیط تولید، این دو معیار کاملاً متفاوتاند. برای کسی که ابزارهای هوش مصنوعی میسازد، این تفاوت مرز بین یک دموی چشمنواز و یک محصول کاربردی است که واقعاً کار میکند.
تصور کنید میخواهید کد خطای '0x80070005' را پیدا کنید. سیستمهای مبتنی بر بردار معنایی (Embedding) — مثل کارت معرفی عددی برای هر واژه که میگوید این کلمه همسایهی چه کلمات دیگری است — اغلب این شناسهها را به مفاهیم کلی «خطاهای سیستم» تبدیل میکنند و دقت توکن را از دست میدهند، زیرا فضای برداری شناسههای دقیق را به مفاهیم مبهم تبدیل میکند. همانطور که در تحلیلهای پیشین ما دربارهی بهینهسازی بازیابی دادهها اشاره کردیم، پرسوجوهای کوتاه و سطح بالا اغلب تکههایی را میآورند که لحنی مشابه دارند اما محتوای تخصصی ندارند. از سوی دیگر، پرسوجوهای چندبخشی تکههایی از اطلاعات را برمیگردانند که فاقد زمینه گسترده لازم برای یک پاسخ منسجم هستند.
حالتهای شکست در بازیابی ساده
طبق گزارش کومار، سه نقطه ضعف اصلی در معماریهای پایه RAG وجود دارد:
- از دست رفتن دقت توکن: بردارها معنای متن را در فضایی با ابعاد ثابت (مثلاً ۷۶۸ یا ۱۵۳۶) فشرده میکنند. این روش برای سوالات مفهومی (مثلاً: «چگونه اعتبارنامههای خود را بازنشانی کنم؟») عالی است، اما برای توکنهای دقیق مثل
MAX_RETRY_ATTEMPTSدر یک فایل config.v2 شکست میخورد. فضای برداری اولویت را به معنای کلی میدهد و باعث میشود رشتههای توکن خاص، تمایز خود را از دست بدهند. - تضاد اندازه تکهها: این یک موازنه بین جزئیات و زمینه است. تکههای کوچک (مثلاً ۲۰۰ توکن) حقایق ریز را حفظ میکنند اما زمینه گسترده لازم برای درک آنها را از دست میدهند. در مقابل، تکههای بزرگ (مثلاً ۲۰۰۰ توکن) زمینه را حفظ میکنند اما سیگنال مرتبط را رقیق کرده و پنجره متنی (Context Window) — میزان متنی که مدل همزمان در ذهن نگه میدارد، شبیه میز کاری که جا برای چند ورق دارد — را با نویز پر میکنند.
- مغالطه k-برتر: بازیابی استاتیک فرض میکند اندازه زمینه همیشه ثابت است. در حالی که در واقعیت، یک سوال ساده شاید فقط به k=2 نیاز داشته باشد و یک تحلیل پیچیده حتی با k=10 هم ناقص بماند. بازیابی تعداد ثابتی از تکهها، توسعهدهنده را مجبور به انتخاب بین «از دست دادن اطلاعات حیاتی» یا «غرق کردن پرامپت تولید در حواسپرتیها» میکند.
پیادهسازی مسیریابی پرسوجو
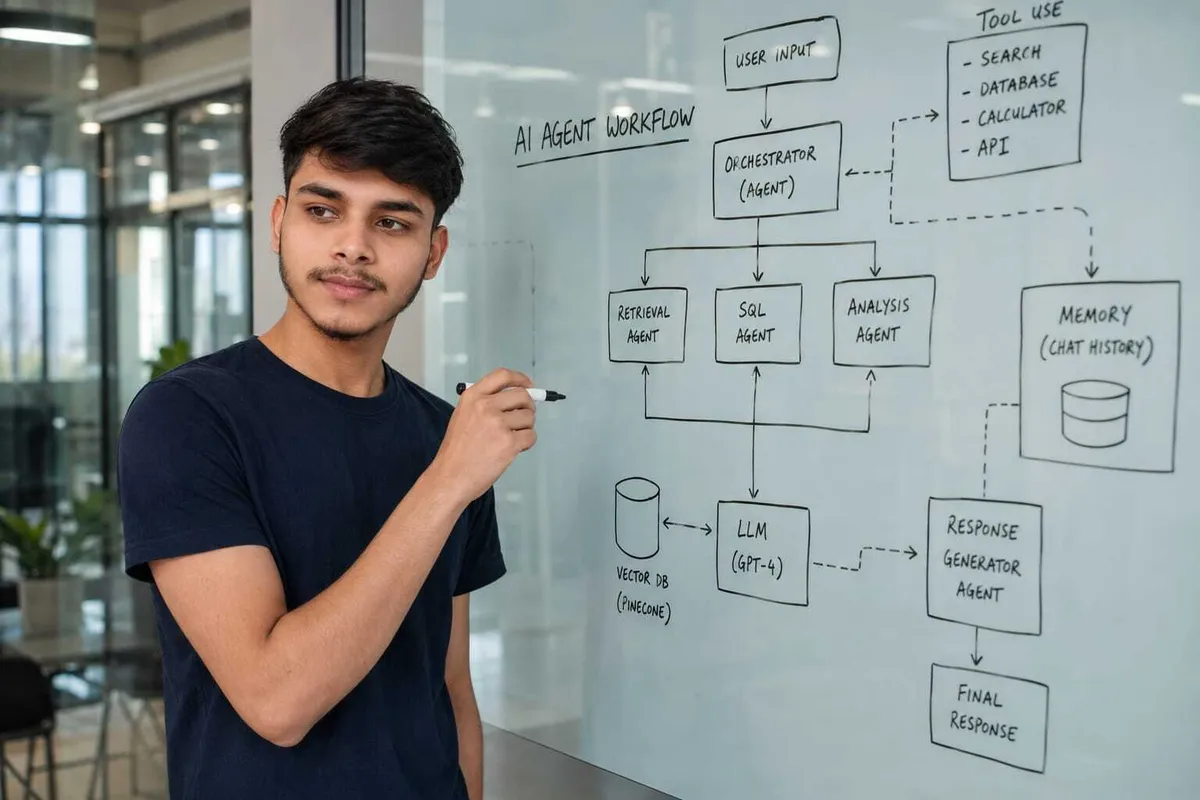
برای حل این مشکل، معماری باید به سمت یک مسیریاب (Router) حرکت کند. ارسال هر رشته متنی مستقیماً به مدل برداری یک نقص معماری است. سیستم باید ابتدا پرسوجو را از یک لایه طبقهبندی سریع — یک مسیریاب سبک — عبور دهد تا بهینه ترین مسیر بازیابی مشخص شود:
- حقایق/کلمات کلیدی دقیق: هدایت به ایندکس لغتمحور (BM25 یا موتور جستوجوی تماممتن) برای تضمین دقت توکن.
- مفهومی/قصد-محور: هدایت به ایندکس برداری از طریق مدلهای Embedding متراکم برای درک معنای کلی.
- پیچیده/چند-ویژگی: اجرای موازی هر دو مسیر لغتمحور و معنایی در یک مسیر ترکیبی.
- گفتگویی/دستورات سیستمی: حذف کامل مرحله بازیابی برای کاهش تأخیر و کاهش هزینههای پردازشی پایگاهداده برداری.
بازیابی ترکیبی و راهکار RRF
ترکیب جستوجوی کلمات کلیدی پراکنده (Sparse/BM25) و جستوجوی برداری متراکم (Dense) تضمین میکند که شناسههای محصول یا کدهای خطا گم نشوند و در عین حال، قصد مفهومی کاربر همچنان درک شود. مدلهای Sparse فرکانس دقیق کلمات و کمیاب بودن اصطلاحات را ردیابی میکنند، در حالی که مدلهای Dense قصد گستردهتر را میگیرند.
زمانی که هر دو بازیاب لیست کاندیداهای خود را برمیگردانند، توزیع امتیازات آنها باید نرمال شود. برای ادغام این دو معیار متفاوت، نویسنده استفاده از تلفیق رتبه متقابل (Reciprocal Rank Fusion یا RRF) را توصیه میکند.
با استفاده از فرمول RRF_Score(d) = Sum of (1 / (60 + Rank(d))) (که در آن ۶۰ ثابتی است که از تسلط بیش از حد دادههای پرت با رتبه بالا بر خروجی جلوگیری میکند)، سیستم لیستی نرمالشده از کاندیداها ایجاد میکند که تعادلی بین دقت (Precision) و بازخوانی (Recall) برقرار میکند.
حل مشکل «گمشدن در میانه»
مدلهای بازیابی روی بازخوانی (Recall) تمرکز دارند — یعنی وارد کردن تمام تکههای بالقوه مرتبط به لیست کاندیداها. اما مدلهای زاینده (Generative LLMs) به دقت (Precision) نیاز دارند — یعنی دریافت مفیدترین زمینهها. ارسال ۳۰ تکه بازیابیشده به LLM باعث پدیده «گمشدن در میانه» (Lost in the Middle) میشود؛ یعنی مدلهای ترنسفورمر به ابتدا و انتهای متن توجه نامتناسبی میکنند و اغلب حقایقی را که در میانه متن دفن شدهاند، نادیده میگیرند.
برای رفع این مشکل، خط لول معرفی بازرتبهبندهای متقاطع (Cross-Encoders) میکند. تفاوت در معماری است:
- Bi-encoders: بردارها و مدلهای استاندارد، پرسوجو و تکههای سند را بهطور مستقل پردازش میکنند تا نمایشهای استاتیک بسازند. این روش سریع است اما مانع از تعامل مستقیم توکنهای پرسوجو با توکنهای سند میشود.
- Cross-encoders: این مدلها پرسوجو و تکه سند را با هم از طریق لایههای ترنسفورمر پردازش میکنند و اجازه میدهند توجه متقاطع (Cross-attention) کامل بین هر توکن پرسوجو و هر توکن سند برقرار شود.
اگرچه اجرای این مدل روی میلیونها سند از نظر محاسباتی گران است، اما اجرای آن روی ۲۰ یا ۳۰ کاندیدای برتر، تأخیر کمی اضافه میکند اما دقت را بهشدت بالا میبرد.
تله پیچیدگیهای عاملمحور
وقتی خطوط لول استاتیک در استدلالهای چندمرحلهای شکست میخورند، توسعهدهندگان اغلب به سمت حلقههای خودگردان عاملمحور (Agentic) با فریمورکهایی مثل LangGraph یا AutoGen میروند. این حلقهها به LLM دسترسی به ابزارها (تولید پرسوجو، جستوجوی خارجی، بازبینی) میدهند و اجازه میدهند تا زمانی که مدل تصمیم بگیرد زمینه کافی دارد، به کار ادامه دهد. برای بهینهسازی این فرآیندهای تکرارشونده، میتوان از رویکردهای هشینگ محتوا برای حذف اجرای مجدد خط لولههای پیچیده استفاده کرد تا بهرهوری سیستم افزایش یابد.
اما این کار هزینههای مهندسی قابلتوجهی دارد:
- تأخیر غیرقطعی: یک خط لول ترکیبی استاندارد ممکن است در ۴۰۰ تا ۸۰۰ میلیثانیه اجرا شود، اما یک حلقه عاملمحور که دوباره پرسوجو میکند و خروجی خود را نقد میکند، میتواند به ۵ تا ۱۰ ثانیه برسد.
- حلقههای بینهایت و انحراف: بدون کنترل شدید جریان، عاملها ممکن است وارد حلقههای فراخوانی ابزار شوند یا از قصد اصلی پرسوجوی کاربر دور شوند. در این راستا، استفاده از الگوهای ساختاریافتهای مانند CLAUDE.md میتواند از تخریب کدهای مشترک و انحراف عاملها جلوگیری کند.
- افزایش هزینه: هر حلقه بازبینی و هر مرحله تصمیمگیری میانی، مصرف توکنها را چندین برابر میکند.
جریانهای کاری عاملمحور تنها زمانی توجیه میشوند که پرسوجو نیاز به حل وابستگیهای چندمرحلهای داشته باشد (مثلاً: «لاگهای استقرار سرویسی را پیدا کن که بعد از مهاجرت دیتابیس دیروز شکست خورد»)، زمانی که بازیابی به نتیجه مرحله قبلی وابسته است، یا زمانی که خود-اصلاحی برای اعتبارسنجی خروجی ساختاریافته در برابر یک طرح (Schema) پیشتعریفشده ضروری است. برای جلوگیری از پراکندگی این ابزارها، تفکیک متدولوژی از ابزار در معماریهای سیستم راهکاری کلیدی برای حفظ قابلیت جابهجایی عاملهاست.
نقشه راه برای محیط تولید
یک خط لول قابلاتکا که تعادلی بین تأخیر، رفتار قطعی (Deterministic) و دقت بازیابی ایجاد کند، از این جریان اجرای خاص پیروی میکند:
۱. ورود پرسوجوی کاربر به سیستم.
۲. طبقهبندی قصد توسط مسیریاب (عبور مستقیم، خط لول ترکیبی یا حلقه عاملمحور).
۳. اجرای موازی جستوجوی برداری متراکم و جستوجوی لغتمحور پراکنده (BM25) در صورت انتخاب مسیر ترکیبی.
۴. ادغام نتایج با RRF برای تبدیل به یک لیست نرمالشده.
۵. فیلتر کردن کاندیداهای برتر توسط Cross-Encoder برای دستیابی به دقت بالا.
۶. تولید پاسخ نهایی توسط LLM با استفاده از زمینه فیلتر شده.
این تغییر رویکرد، تمرکز را از «تنظیم مدل» به «مهندسی داده» منتقل میکند. نویسنده تأکید میکند که تکهبندی بد، نبود متادیتا و پاکسازی ضعیف اسناد را نمیتوان با یک LLM گرانقیمت یا یک بازرتبهبند تراز اول جبران کرد. ابتدا روی ورود دادهها (Data Ingestion) بهینه کنید.
برای مهندسان، این یعنی پایگاهدادههای برداری را به عنوان یک جزء از سیستم گستردهتر ببینید، نه کل زیرساخت جستوجو. باید دقت بازیابی را مستقل از کیفیت تولید متن اندازه بگیرید. استفاده از معیارهایی مثل Mean Reciprocal Rank (MRR) و Normalized Discounted Cumulative Gain (NDCG) به شما اجازه میدهد لیست کاندیداهای بازیابی را پیش از رتبهبندی متن نهایی تولید شده، ارزیابی کنید.
اگر در حال مقیاسدهی یک سیستم RAG هستید، لاگهای بازیابی خود را برای «از دست رفتن دقت توکن» بررسی کنید تا ببینید آیا کاربران شناسههای دقیقی را میخواهند که پایگاهداده برداری شما نادیده میگیرد. مسیر اجرای پیشفرض را قطعی نگه دارید؛ از اکتشافات مسیریابی استفاده کنید تا ۸۰٪ پرسوجوهای استاندارد از یک مسیر ترکیبی سریع عبور کنند و حلقههای غیرقطعی عاملمحور را برای موارد خاص و پیچیده رزرو کنید.
گام بعدی شما
- لاگهای بازیابی خود را بررسی کنید تا ببینید چند درصد از پرسوجوهای حاوی کد یا شناسه (ID) با نتایج نامرتبط مواجه شدهاند.
- یک لایه مسیریابی (Router) ساده برای تفکیک پرسوجوهای مفهومی از پرسوجوهای لغتمحور پیاده کنید.
- برای ۲۰ کاندیدای برتر، یک Cross-Encoder اضافه کنید و کاهش نرخ توهم را اندازه بگیرید.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو