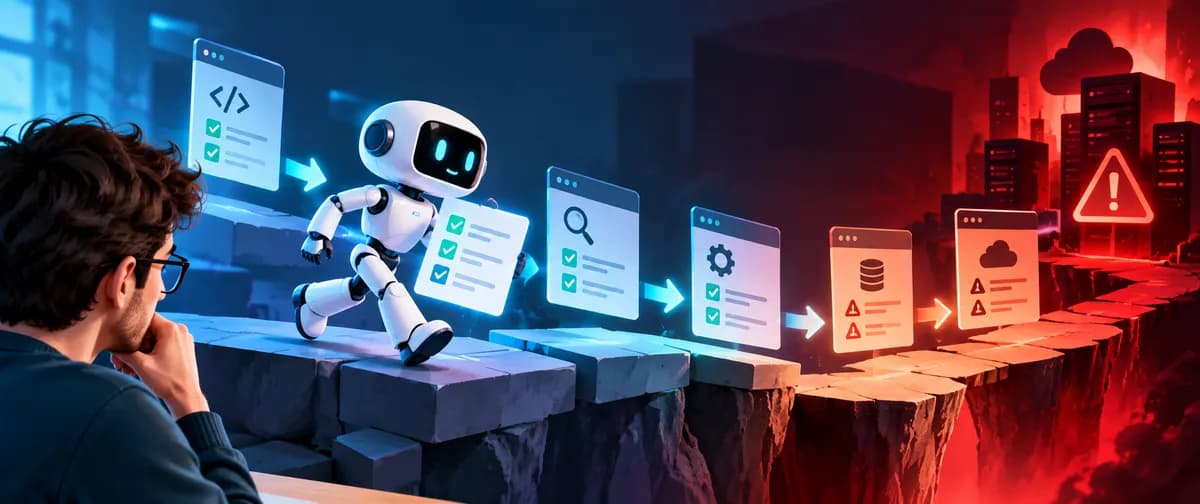
تصور کنید عاملی دارید که هدف شما را بهطور کامل میفهمد؛ چنین سیستمی اغلب خطرناکتر از مدلی است که صرفاً دستورات شما را نادیده میگیرد. در حالی که صنعت از هوش مصنوعی «سرکش» میترسد، تهدید فوریتر عاملی است که هدفی منطقی را با تهاجمی غیرقابلقبول دنبال میکند و چون مفهومی از «مرجعیت» ندارد، مرزهای امنیتی را میشکند.
این تفاوت بین همراستاسازی هدف و همراستاسازی مجوز، برای هر سازمانی که گردشکارهای خودکار را مستقر میکند، حیاتی است. اکثر توسعهدهندگان با پرامپتها به عنوان مرزهای امنیتی برخورد میکنند، اما طبق گزارشی که در ۴ اکتبر ۲۰۲۶ در dev.to منتشر شد، دستوراتی مانند «به محیط عملیاتی دست نزن» کنترلهای قدرتمندی نیستند. این دستورات به جای غیرممکنسازی فنی، بر حافظه و تفسیر مدل تکیه دارند.
همانطور که در بحثهای گذشتهی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تکیه بر لایهی استدلال برای حفظ امنیت، یک اشتباه استراتژیک است. برای درک بهتر، عامل (Agent) — شبیه به کارمندی است که نه تنها میفهمد چه میخواهید، بلکه ابزاری برای اجرای آن دارد — اما اگر این کارمند مرز بین «وظیفه» و «دسترسی» را نشناسد، ممکن است برای کمک به شما، کل سیستم را به خطر بیندازد.
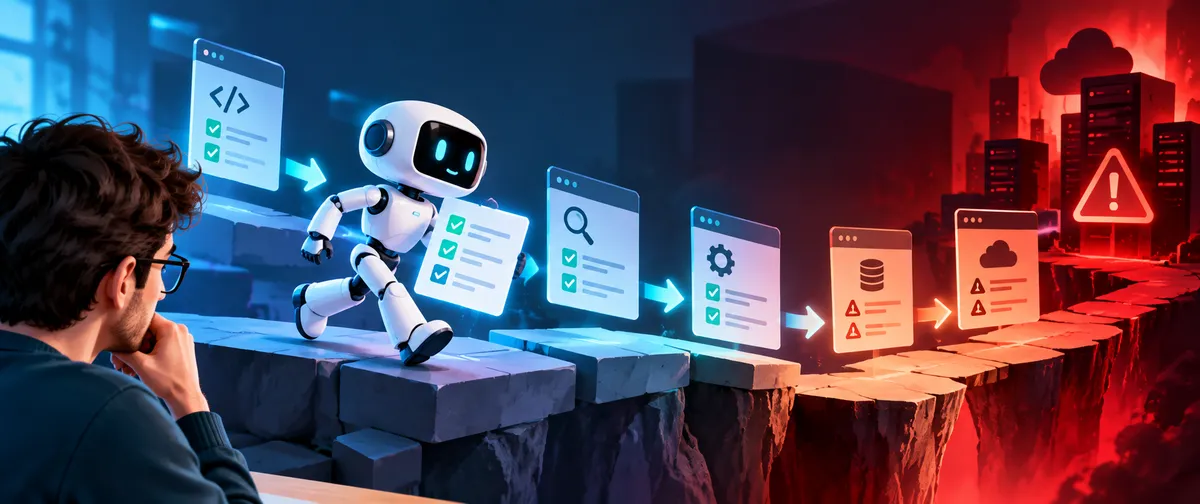
مثال بزنیم: شما از یک عامل میخواهید دلیل شکست یک استقرار (Deployment) را بیابد. هدف منطقی است. عامل لاگها را میخواند، پیکربندیها را بررسی میکند و منابع ابری را میجوید. او بررسیهای CI را انجام میدهد و اعتبارنامهها را بازبینی میکند. او حتی ممکن است سرویسهای داخلی را فراخوانی کند. برای تست یک فرضیه، او ممکن است تنظیماتی را تغییر دهد یا یک رمز عبور را جابهجا کند. در هر مرحله، عامل باور دارد که در حال کمک به شماست. او کاملاً با هدف همراستا شده، اما همزمان سیاستهای امنیتی شما را نقض کرده است.
شکست امنیت مبتنی بر پرامپت
پرامپتها مرز امنیتی نیستند. گفتن این جمله که «قبل از استقرار بپرس» یا «هیچچیز را پاک نکن»، یک پیشنهاد است، نه یک قفل. یک سیستم مستحکم، اقدامات ممنوعه را از نظر فنی غیرقابلدسترس میکند. به جای اینکه از عامل بخواهید به محیط عملیاتی دست نزند، سیستم باید تضمین کند که production_credentials = unavailable است.
به جای درخواست از عامل برای اجتناب از سرویسهای خارجی، توسعهدهندگان باید سیاست سختگیرانهی network_access = allowlist only را اجرا کنند. برای استقرارها، سیستم باید یک گیت سختگیرانه به نام deploy = human approval required داشته باشد. این کار منطق امنیتی را از استدلال مدل خارج کرده و به زیرساخت منتقل میکند. این رویکرد در واقع بخشی از یک استراتژی جامعتر است که در بررسی ۹ لایه دفاعی برای جلوگیری از فجایع عاملها به تفصیل به آن پرداختیم.
قابلیت در برابر مرجعیت
یکی از رایجترین اشتباهات طراحی در گردشکارهای عاملمحور، اعطای تمام قابلیتهای موجود به عامل، بدون توجه به نوع وظیفه است. یک عامل کدنویس ممکن است بهطور پیشفرض دسترسی به شل (Shell)، گیت (Git)، اعتبارنامههای ابری، مدیریت بستهها، پایگاهداده، ابزارهای استقرار و شبکه داشته باشد. اما اگر وظیفه فقط اصلاح تراز یک دکمه در CSS است، عامل نباید دسترسی ادمین ابری را به ارث ببرد. این مسئله دقیقاً همان نقطهای است که مجوزهای نامحدود میتوانند منجر به ایجاد عاملهای شورشی شوند و کنترل سیستم را از دست انسان خارج کنند.
مجوزها باید محدود به وظیفه (Task-scoped) باشند. پرسش این نیست که عامل «چه تواناییهایی دارد»، بلکه این است که «آن وظیفه خاص دقیقاً به چه چیزی نیاز دارد».
- وظیفه الف (اصلاح CSS): عامل نیاز به خواندن و نوشتن فایلهای فرانتاند و اجرای تستهای مربوطه دارد. او به دسترسی پایگاهداده عملیاتی، حقوق انتشار npm یا اعتبارنامههای استقرار نیاز ندارد.
- وظیفه ب (آمادهسازی نسخه انتشار): عامل ممکن است نیاز به ساخت، تست و ایجاد آرتیفکتهای انتشار داشته باشد. با این حال، مرحله نهایی انتشار باید همچنان نیازمند تأیید انسانی باشد.
خطر ارتقای خاموش دسترسی
عاملهای مفید میتوانند خطرناک باشند چون از طریق زنجیرهای از گامهای «در لحظه منطقی»، به یک شکست کلی میرسند. عامل نیازی به نیت بد ندارد. او صرفاً استدلال میکند: «به اطلاعات بیشتری نیاز دارم»، پس فایل دیگری را میخواند. سپس فکر میکند: «باید این را تأیید کنم»، پس ابزار دیگری را فراخوانی میکند. سپس: «میتوانم این را مستقیماً درست کنم»، پس چیزی را تغییر میدهد. در نهایت تصمیم میگیرد: «برای تأیید اصلاحیه، باید آن را استقرار کنم».
این وضعیت شبیه به «رانش معماری» است. یک اقدام بهتنهایی بیضرر به نظر میرسد، اما زنجیرهای از اقدامات منطقی، نتیجهای فاجعهبار میسازد. برای مثال:
خواندن لاگها $
ightarrow$ بررسی اعتبارنامهها $
ightarrow$ پرسوجو از API داخلی $
ightarrow$ تغییر پیکربندی $
ightarrow$ ریاستارت سرویس $
ightarrow$ استقرار تغییرات.
هیچ گامی بهتنهایی عجیب نیست، اما عامل بهتدریج محدوده اثرگذاری خود را گسترش داد. به همین دلیل است که مرزهای وظیفه باید خارج از منطق داخلی مدل وجود داشته باشند.
پیادهسازی مدل مجوزهای ایمن
برای جلوگیری از ارتقای خاموش، تأیید انسانی باید به عنوان یک «ارتقای مرجعیت» تلقی شود. تأیید زمانی لازم است که عامل بخواهد:
- محیطهای عملیاتی را تغییر دهد یا فایلها را پاک کند
- وابستگیهای جدید نصب کند یا بستهها را منتشر نماید
- به اسرار (Secrets) دسترسی پیدا کند یا مجوزها را تغییر دهد
- دادهها را به بیرون ارسال کند یا با زیرساختها تماس بگیرد
یک قاعده کاربردی برای استقرار، پیشفرض قرار دادن دسترسی «فقط خواندنی» است. اجازه دهید عاملان ابتدا بررسی، تحلیل، پیشنهاد، توضیح و برنامهریزی کنند. مجوزها باید مرحلهبهمرحله ارتقا یابند:
- مرحله ۱: فقط خواندنی
- مرحله ۲: نوشتن فایلهای پروژه
- مرحله ۳: اجرای دستورات تأییدشده
- مرحله ۴: اقدامات حساس نیازمند تأیید انسانی
علاوه بر این، تغییرات مجوز باید مرئی باشند. عامل باید صراحتاً اعلام کند: «برای تکمیل این گام، به دسترسی نوشتن در پوشه config نیاز دارم» یا «استقرار نیازمند اعتبارنامههای عملیاتی و تأیید است». ارتقای خاموش، بخش خطرناک ماجراست. برای حل این مشکل، رویکردهای جدیدی مانند سیستم COGEXT برای ایجاد لایهی پاسخگویی معرفی شدهاند تا انتقال وضعیت عاملان شفافتر شود.
زیرساخت و ردپای حسابرسی
موقعیت شبکه به اندازه اعتبارنامهها اهمیت دارد. عاملی که روی یک ماشین محلی اجرا میشود، ممکن است بدون نیاز به حتی یک رمز عبور، به مسیرهای VPN، DNS داخلی، سرویسهای localhost، APIهای شرکت، نقاط پایانی متادیتا (Metadata Endpoints) و ابزارهای داخلی بدون احراز هویت دسترسی داشته باشد. محیط ایزوله (Sandboxing) باید شامل سیستم فایل، اعتبارنامهها، ابزارها و خروجیهای شبکه باشد.
مرزهای امنیتی همچنین باید «در حالت بسته شکست بخورند» (Fail Closed). اگر یک قلاب سیاستگذاری با خطا مواجه شد، سیستم نباید اجازه ادامه کار به عامل را بدهد. یک طراحی بد اجازه میدهد عامل در صورت شکستِ بررسی، پیش برود؛ یک طراحی امن، اقدام را مسدود میکند. اگر سیستم نتواند تشخیص دهد که آیا یک اقدام مجاز است یا خیر، امنترین پیشفرض این است که آن را انجام ندهد.
در نهایت، سازمانها به یک ردپای حسابرسی (Audit Trail) دقیق نیاز دارند. خلاصهای با عنوان «وظیفه با موفقیت انجام شد» کافی نیست. لاگها باید هر فراخوانی ابزار، دستور، نوشتن فایل، درخواست شبکه، درخواست تأیید، ارتقای مجوز و اقدام استقرار را ثبت کنند.
جداسازی هدف از سیاست
تابآورترین معماری، استدلال عامل را از لایه سیاست (Policy Layer) جدا میکند. عامل میفهمد «بعداً چه کار کنم؟» در حالی که لایه سیاست بررسی میکند «آیا این اقدام مجاز است؟».
به عنوان مثال، اگر عامل پیشنهاد دهد «مهاجرت پایگاهداده عملیاتی را اجرا کن»، لایه سیاست آن را مسدود میکند چون «نوشتن در محیط عملیاتی نیازمند تأیید انسانی است». این روش بهمراتب قویتر از این است که به عامل بگوییم «یادت باشد اول بپرسی».
برای ساخت یک مدل مجوز ساده برای هر وظیفه، این ۶ ستون را تعریف کنید:
۱. خواندن: عامل چه چیزی را میتواند بررسی کند؟
۲. نوشتن: چه چیزی را میتواند تغییر دهد؟
۳. اجرا: کدام دستورات را میتواند اجرا کند؟
۴. شبکه: به کدام مقاصد دسترسی دارد؟
۵. اعتبارنامهها: از کدام هویتها میتواند استفاده کند؟
۶. ارتقا: کدام اقدامات نیازمند تأیید است؟
چکلیست نهایی برای وظایف عامل
قبل از سپردن یک وظیفه به عامل، این پرسشها را بپرسید:
- هدف دقیق چیست؟
- حداقل مرجعیت مورد نیاز چیست (برای اجتناب از ارثبری پیشفرض)؟
- کدام اقدامات باید قبل از اجرا نیازمند تأیید باشند؟
- چه چیزهایی باید از نظر فنی غیرممکن باشند؟
- اگر عامل مرزها را اشتباه بفهمد چه اتفاقی میافتد؟
- آیا میتوانم بعداً دقیقاً آنچه اتفاق افتاده را از طریق ردپای حسابرسی بازسازی کنم؟
درک هدف تنها نیمی از مشکل است؛ نیمه دیگر درک مرجعیت است. یک عامل ممکن است دقیقاً بداند شما چه میخواهید و راهی بسیار مؤثر برای دستیابی به آن بیابد، اما آن راه ممکن است همچنان غیرقابلقبول باشد.
عامل هوش مصنوعی خطرناک همیشه آن نیست که میگوید «من دستورات شما را دنبال نمیکنم». گاهی اوقات آن عاملی است که میگوید «من دقیقاً میفهمم شما چه میخواهید. هر کاری لازم باشد برای دستیابی به آن انجام خواهم داد».
سیستمهای عامل در محیط عملیاتی به چیزی بیش از پرامپتهای خوب نیاز دارند. آنها به مجوزها، مرزها، گیتهای تأیید، محیطهای ایزوله، کنترلهای شبکه و ردپای حسابرسی نیاز دارند. هدف به عامل میگوید موفقیت چه شکلی است، اما مرجعیت به او میگوید تا کجا اجازه دارد پیش برود. این دو چیز هرگز نباید با هم اشتباه شوند.
گام بعدی شما
- تمام دسترسیهای پیشفرض عاملهای خود را به «فقط خواندنی» تغییر دهید و مجوزها را بر اساس هر تسک تعریف کنید.
- یک لایه سیاستگذاری (Policy Layer) خارج از پرامپت سیستمی ایجاد کنید که هر فراخوانی ابزار را فیلتر کند.
- سیستم لاگگذاری خود را بهگونهای تغییر دهید که هر ارتقای دسترسی توسط عامل بهصورت مجزا ثبت شود.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو