
اگر امروز یک خط لوله RAG همزمان را برای پردازش یک فایل PDF ۴۷ صفحهای یا یک API ناپایدار به کار بگیرید، سیستم شما در کمترین زمان ممکن فرو میپاشد. بسیاری از توسعهدهندگان به اشتباه پایگاهداده برداری را قلب سیستم میبینند، اما در محیط تولید، این پایگاه تنها یک نمایهی مشتقشده است، نه منبع اصلی حقیقت.
ساخت یک سیستم هوش مصنوعی قابلاتکا نیازمند یک چرخش ذهنی است: سند خام باید منبع تغییرناپذیر حقیقت باشد و نمایهی برداری تنها یک مدل خواندنی که بهمرور با منبع اصلی همگام میشود. طبق گزارشهای فنی، اگر API آپلود را مستقیماً به فرآیند بردار معنایی (Embedding) — که شبیه به ساخت یک کارت معرفی عددی برای هر واژه است تا همسایگان معناییاش شناخته شوند — گره بزنید، یک خطای ۵۰۴ در صفحه ۳۸ یک سند، کل درخواست را با شکست مواجه میکند. در یک مورد واقعی، قطع شدن API بردار پس از ۲۸ ثانیه باعث کرش کامل فرآیند همزمان شد و کاربر را مجبور کرد تمام مراحل آپلود و تکهبندی (Chunking) — یعنی برشهای کوچک متن شبیه تکههای کیک که مدل تکهتکه میخورد — را تکرار کند. این اتفاق نه تنها باعث اتلاف منابع پردازشی میشود، بلکه ریسک ایجاد بردارهای تکراری در پایگاهداده را افزایش میدهد. این چالشها نشان میدهند که بسیاری از نقصها پیش از رسیدن داده به مدل رخ میدهند، موضوعی که در تحلیل ما درباره نقاط شکست زنجیره RAG بهطور مفصل بررسی شده است.
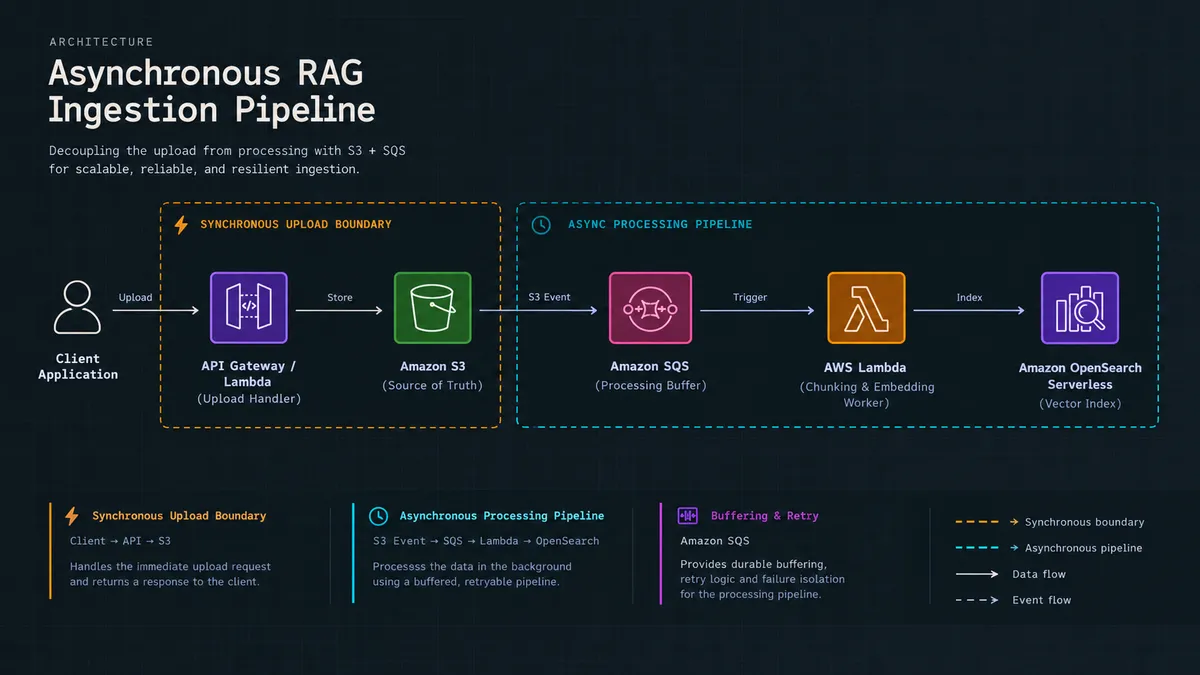
به نقل از راهنمای فنی منتشر شده در ۱۵ سپتامبر ۲۰۲۶ در وبسایت dev.to، راهکار این مشکل ایجاد یک مرز ناهمزمان (Asynchronous) با استفاده از سرویسهای وب آمازون (AWS) است. با جداسازی مسیر ورود دادهها، توسعهدهندگان میتوانند وابستگیهای کندِ پاییندستی را بدون از دست دادن دادهها مدیریت کنند. همانطور که در تحلیلهای قبلی ما دربارهی مدیریت وضعیت در عاملهای هوش مصنوعی اشاره کردیم، جداسازی لایهی ذخیرهسازی از لایهی پردازش، کلید مقیاسپذیری است. این رویکرد در واقع تفاوت بنیادین میان یک زیرساخت دادهای مستحکم و یک پایگاهداده برداری ساده است که برای انطباق نظارتی و ردیابیپذیری در سیستمهای AI حیاتی است.
معماری رویدادمحور
برای رفع شکاف قابلیت اطمینان، فرآیند ورود داده باید از یک لایهی ذخیرهسازی بادوام و یک بافر پیام عبور کند تا پایگاهداده برداری به جای هسته، به عنوان یک نمایهی مشتقشده عمل کند:
- Amazon S3: به عنوان منطقه فرود عمل میکند. به محض آپلود فایل در S3، API بلافاصله پاسخ ۲۰۰ OK را به کلاینت میفرستد و تضمین میکند سند پیش از شروع پردازش، ذخیره شده است. با این روش، آپلود سند دیگر به فرآیند زمانبرِ تولید بردار گره نخورده است.
- Amazon SQS: به عنوان یک مرز بافری عمل میکند. به جای فعالسازی مستقیم توابع، رویدادهای S3 به SQS جریان مییابند تا جهشهای ناگهانی در تعداد آپلودها باعث برخورد با محدودیتهای نرخ (Rate Limits) API بردار نشود. SQS این رویدادها را جذب کرده و به کارگران (Workers) اجازه میدهد پیامها را با نرخی کنترلشده دریافت کنند.
- AWS Lambda: توابع کارگر پیامها را از SQS میگیرند، بردارها را تولید کرده و نمایه را بهروز میکنند. SQS یک «زمان انتظار برای مشاهده» (Visibility Timeout) فراهم میکند؛ اگر یک Lambda حین پردازش بردارها کرش کند، پیام دوباره قابل مشاهده شده و بهطور خودکار باز ارسال میشود.
حالتهای شکست و صف DLQ
همه شکستها گذرا نیستند. برخی اسناد مانند PDFهای معیوب یا ورودیهایی که بهطور مداوم خطاهای سطح ۴۰۰ را از API بردار دریافت میکنند، بهطور دائمی غیرقابل پردازش هستند. بدون مکانیزم خاص، این پیامها بهطور نامحدود تکرار میشوند بدون اینکه در وضعیت سیستم به عنوان «شکست» ثبت شوند و در واقع در یک حلقه تکرار بیپایان گیر میکنند.
برای جلوگیری از این وضعیت، ایجاد یک صف نامههای مرده (DLQ) ضروری است. با تنظیم سیستم برای انتقال پیام پس از سه تلاش ناموفق به DLQ، مهندسان میتوانند فایل مشکلدار را بهصورت دستی بررسی کرده و وضعیت سند را در جدول ردیابی به «FAILED» تغییر دهند تا از اتلاف منابع جلوگیری شود.
مدیریت Idempotency
سیستمهای ناهمزمان ریسک پردازش تکراری را به همراه دارند. اگر یک کارگر پس از بهروزرسانی نمایه اما پیش از حذف پیام از SQS کرش کند، سیستم عملیات را تکرار میکند. اگر کارگر بدون بررسی، تکهها را در هر بار تلاش درج کند، نمایه برداری با دادههای تکراری پر میشود که منجر به کاهش کیفیت بازیابی (Retrieval) و افزایش هزینههای عملیاتی میگردد. این نوع نقصهای ساختاری در معماری، اغلب ریشه اصلی مشکلاتی هستند که باعث توهم مدلها حتی در صورت بازیابی صحیح دادهها میشوند.
برای جلوگیری از این اتفاق، کارگر باید Idempotent (تکرارپذیر بدون تغییر نتیجه) باشد. این کار با استفاده از شناسههای قطعی (Deterministic IDs) محقق میشود. با هش کردن کلید شیء S3، شناسه نسخه S3 و شاخص تکه با استفاده از SHA-256، سیستم تضمین میکند که یک تکه مشابه همیشه شناسه یکسانی تولید کند.
برای مثال، یک تابع کمکی مانند generate_chunk_id میتواند این سه متغیر را پیش از هش کردن در یک رشته متنی ترکیب کند. وقتی API دستهای OpenSearch Serverless یک شناسه تکراری دریافت میکند، صرفاً سند موجود را بازنویسی میکند و این تکرار در لایهی داده عملاً بیاثر (no-op) میشود. استفاده از شناسه نسخه S3 در اینجا حیاتی است؛ زیرا اگر سند اصلی تغییر کند، یک شناسه نسخه جدید ایجاد شده و در نتیجه شناسههای تکه جدید تولید میشوند، در حالی که تکرارهای همان نسخه قبلی همچنان Idempotent باقی میمانند.
مشکل تکههای یتیم
شناسههای قطعی مشکل تکرار را حل میکنند اما مشکل «حذف هنگام کاهش» را نه. اگر سندی با استراتژی تکهبندی جدید پردازش شود که منجر به تعداد تکههای کمتری شود — برای مثال کاهش از ۱۲ تکه به ۸ تکه — تکههای ۸ تا ۱۱ از نسخه قدیمی به عنوان دادههای منقضیشده و یتیم در نمایه باقی میمانند.
برای حل این موضوع، خط لوله به یک مرحله پاکسازی نیاز دارد. کارگر باید پیش از نمایهسازی تکههای جدید:
- تمام اسنادی که
s3_keyوversion_idیکسانی دارند را در OpenSearch جستوجو کند. - هر تکهای که شاخص آن بزرگتر یا مساوی تعداد تکههای جدید است را حذف کند.
- یا به عنوان جایگزین، تعداد تکههای حدبالا را در یک رکورد وضعیت در DynamoDB ردیابی کرده و پس از اتمام پردازش، تکههای یتیم را پاک کند.
مدیریت لبهها و تجربه کاربری
خط لولههای تولیدی باید شکستهای جزئی در عملیات دستهای را نیز مدیریت کنند. API دستهای OpenSearch خطاهای هر آیتم را بهطور جداگانه برمیگرداند. ممکن است در یک دسته ۲۰ تکه، ۳ مورد به دلیل خطاهای نگاشت (Mapping) یا محدودیت نرخ (Throttling) شکست بخورند، اما خودِ فراخوانی API خطای کلی برنگرداند. یک کارگر استاندارد باید آرایه items را در پاسخ دستهای تحلیل کرده و تکههای شکستخورده را بهطور مجزا گزارش یا تکرار کند.
این معماری یک موازنه ایجاد میکند: همگامی نهایی (Eventual Consistency). چون پردازش در پسزمینه رخ میدهد، اسناد بلافاصله قابل جستوجو نیستند. برای مدیریت انتظارات کاربر، یک مکانیزم ردیابی وضعیت با DynamoDB لازم است. هندلر آپلود وضعیت را روی «PROCESSING» قرار میدهد و کارگر Lambda پس از اتمام کار، آن را به «COMPLETED» یا «FAILED» تغییر میدهد. فرانتاند با نظارهگری (Polling) این نقطه، نوار پیشرفت را به کاربر نمایش میدهد.
انتخاب ابزار مناسب
برای ذخیرهساز برداری، OpenSearch Serverless برای حذف مدیریت زیرساخت و تبدیل لایهی بازیابی به یک زیرسیستم صریح ایدهآل است، اما اگر برنامه به شدت به PostgreSQL وابسته است، pgvector جایگزینی مناسب و عملی است.
برای تیمهایی با نیازهای استاندارد، Amazon Bedrock Knowledge Bases میتواند کل این جریان S3 به بردار را خودکار کند و فرآیندهای ورود، تکهبندی و تولید بردار را بهصورت داخلی مدیریت نماید. خط لولههای سفارشی SQS/Lambda تنها زمانی لازم هستند که منطق تکهبندی تخصصی — مانند حفظ ساختارهای پیچیده جداول — مورد نیاز باشد یا زمانی که بخواهید از ذخیرهساز برداری استفاده کنید که بهطور بومی توسط Bedrock پشتیبانی نمیشود.
این تغییر دیدگاه — تبدیل پایگاهداده برداری از یک دیتابیس اصلی به یک نمایهی بازسازیپذیر — شکنندگی خط لوله RAG را از بین میبرد و چالش مهندسی را از «تنظیم پرامپت» به «مدیریت وضعیت و مدیریت حالتهای شکست» تغییر میدهد.
گام بعدی شما
- بررسی کنید آیا فرآیند ورود دادههای شما در RAG همزمان (Synchronous) است یا ناهمزمان؛ اگر همزمان است، ریسک Timeout را در اسناد حجیم تحلیل کنید.
- پیادهسازی یک صف نامههای مرده (DLQ) را برای شناسایی فایلهای غیرقابل پردازش در اولویت قرار دهید تا حلقههای تکرار سیستم مسدود نشوند.
- برای جلوگیری از تکرار دادهها در نمایه، سیستم شناسایی تکهها را بر اساس هشِ محتوا و نسخه سند (Deterministic ID) بازطراحی کنید.
اما مدیریت هزینههای استنتاج در این مقیاس، چالش دیگری است — به تحلیل ما دربارهی بهینهسازی هزینه GPU در محیطهای ابری مراجعه کنید.



گفتگو