
تصور کنید یک دستیار هوش مصنوعی در بخش منابع انسانی، به کارمندی میگوید که واجد شرایط استرداد وجه است، چون تنها یک جمله از یک سند ۴۰ صفحهای را خوانده است. این کارمند میپرسد: «آیا اگر اشتراک سالانه را ظرف ۳۰ روز لغو کنم، پولم را پس میگیرم؟» در حالی که پاسخ در پایگاه دانش موجود است، اما در میان انبوهی از متون دفن شده است؛ یک جمله میگوید «استرداد وجه ظرف ۳۰ روز ممکن است»، اما چند پاراگراف جلوتر، سیاست شرکت یک شرط حیاتی را اضافه میکند: «این مورد فقط برای مشتریان سازمانی است و طرحهای سالانه استثنا هستند.»
اگر خط لولهٔ تولید بازیابیافزا (RAG) — شبیه دانشآموزی که قبل از جواب دادن، اول کتاب درسی را باز میکند و از آن نقل میآورد — فقط جمله اول را بازیابی کند، مدل پاسخ میدهد: «بله، میتوانید وجه را پس بگیرید اگر ظرف ۳۰ روز لغو کنید.» از نظر فنی، مدل چیزی را اختراع نکرده است؛ ابزار بازیابی یک قطعه اطلاعات واقعی را پیدا کرده است. اما مشکل اینجاست که اطلاعات ناقص بوده است. این حالت از شکست ثابت میکند که در RAG، بازیابی (Retrieval) با مبنیسازی (Grounding) یکی نیست. بسیاری توهم را مشکلی در مدل زبانی بزرگ (LLM) — مثل کتابخانهداری که میلیاردها صفحه را خوانده و حالا با همان لحن کتابها جواب میدهد — میدانند، جایی که مدل چون پاسخ را نمیداند، چیزی را از خودش میسازد. اما در محیط عملیاتی، شکست اغلب زودتر رخ میدهد: مدل پاسخی را بر اساس شواهد بد تولید میکند. این موضوع با پژوهشهای اخیر درباره اتصال به دانش خارجی همسو است که نشان میدهد چگونه RAG میتواند ریسک توهمات LLM را کاهش دهد، مشروط بر اینکه بازیابی درست صورت گیرد.
بسیاری از توسعهدهندگان RAG را یک فرآیند ساده دو مرحلهای میبینند: یک پایگاهداده برداری متنی مشابه را مییابد و LLM آن را خلاصه میکند. این مدل ذهنی برای یک دموی ساده کافی است، اما در مقیاس واقعی شکست میخورد. طبق گزارشهای صنعتی تا ۲۵ اوت ۲۰۲۶، رویکرد فعلی به سمت نگاه به RAG به عنوان یک سامانه پیچیده اطلاعاتی تغییر کرده است که در آن LLM صرفاً لایه نهایی ارتباطات است، نه منبع حقیقت.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، اعتماد کورکورانه به خروجی مدل بدون بررسی زنجیره تأمین داده، ریسکهای بزرگی ایجاد میکند.
تلهٔ شباهت
شباهت برداری با مرتبط بودن پاسخ یکی نیست. در مرحله اول، کاربر پرسشی میپرسد، برنامه آن را به یک بردار معنایی (Embedding) — مثل کارت معرفی عددی برای هر واژه که میگوید این کلمه «همسایهی» چه کلمات دیگری است — تبدیل میکند و در پایگاهداده برداری جستوجو میکند. فرض بر این است که ۱۰ قطعه بازگشتی، مرتبطترینها هستند، اما اینطور نیست؛ آنها فقط ۱۰ بردار نزدیکتر بر اساس تابع شباهت پایگاهداده هستند.
برای مثال، پرسشی را در نظر بگیرید: «آیا طرح سازمانی استرداد وجه را پس از لغو پشتیبانی میکند؟» یک پایگاهداده برداری ممکن است قطعاتی را برگرداند که شامل این عبارات باشند:
- صورتحسابهای سازمانی
- دورههای استرداد وجه هنگام لغو
- فاکتورها
- تمدید اشتراک
- طرحهای سالانه
همه اینها از نظر معنایی به پرسش نزدیکاند، اما شباهت معنایی تضمین نمیکند که آن قطعه حاوی شواهد لازم برای پاسخ به سؤال باشد. یک قطعه میتواند درباره استرداد وجه باشد بدون اینکه معیارهای واجد شرایط بودن را ذکر کند. میتواند به طرحهای سالانه اشاره کند بدون اینکه سیاست استرداد را توضیح دهد. یا میتواند درباره لغو صحبت کند بدون اینکه مشخص کند بعد از لغو چه اتفاقی میافتد. به همین دلیل، مرحله اول یک خط لوله RAG باید به عنوان «تولید کاندید» دیده شود، نه بازیابی پاسخ؛ هدف این است که تور پهنی افکنده شود تا اطلاعات مفید از دست نروند. این چالش دقیقاً همان جایی است که بسیاری از چتباتهای RAG در مرحله بازیابی و نه تولید شکست میخورند و کاربر را با پاسخهای نامرتبط مواجه میکنند.
راهکار بازرتبهبندی
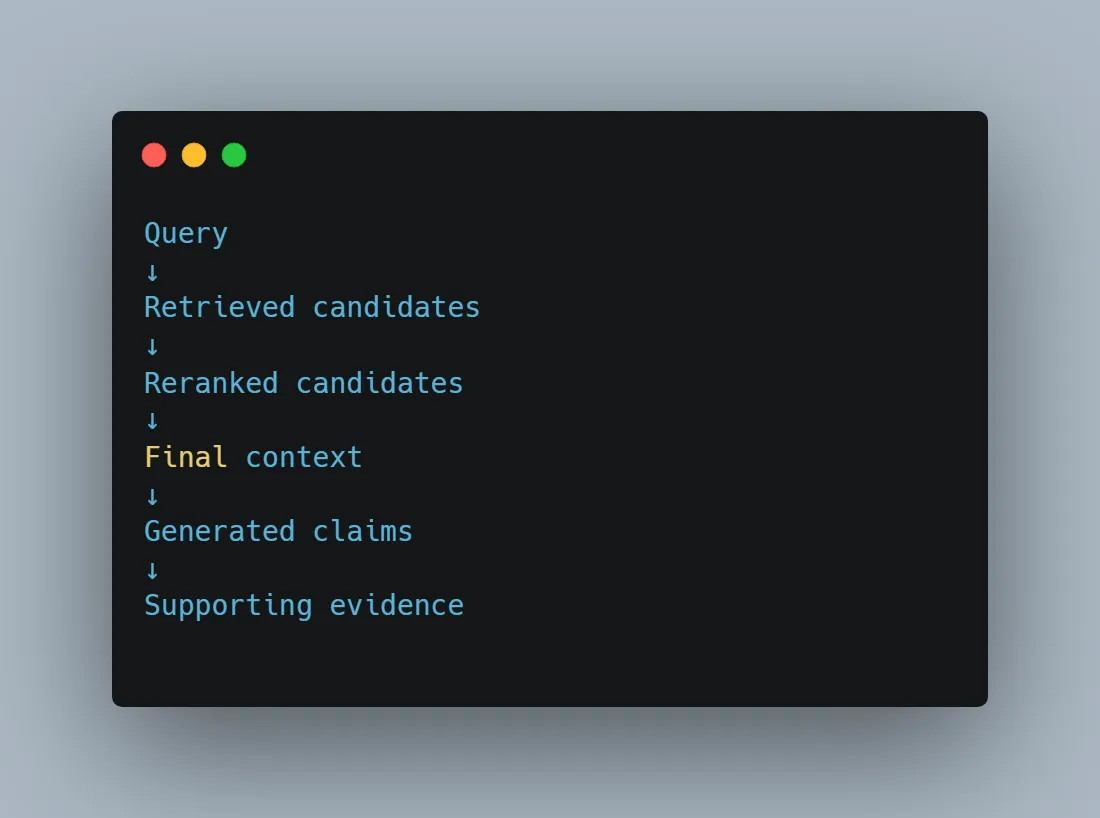
برای حل مشکل دقت، توسعهدهندگان معماری چندمرحلهای را پیاده میکنند: پرسش ← بازیابی برداری ← مجموعه کاندید ← بازرتبهبندی (Reranking) ← زمینه مرتبط. به جای اینکه از پایگاهداده بخواهند دقیقاً ۵ سند نهایی را پیدا کند، ابتدا مجموعه بزرگتری (مثلاً ۲۰ یا ۵۰ کاندید) بازیابی میشود.
سپس یک بازرتبهبند هر کاندید را در برابر پرسش اصلی ارزیابی میکند. این کار فرآیند را به دو وظیفه مجزا تقسیم میکند:
- بازیابی برداری: متمرکز بر فراخوانی (Recall) است. این مرحله تضمین میکند که سیستم اطلاعات بالقوه مفید را خیلی زود دور نریزد.
- بازرتبهبندی: متمرکز بر دقت (Precision) است. این مرحله به طور گزینشی تعیین میکند که چه چیزی واقعاً شایسته رسیدن به LLM است.
این تفکیک بهویژه زمانی ارزشمند است که پایگاه دانش بزرگ باشد. یک پرسش درباره «استرداد وجه» ممکن است صدها سند مربوط به صورتحساب را بازیابی کند، اما تنها تعداد اندکی از آنها واقعاً حاوی پاسخ خاص هستند.
بحران تکهبندی
حتی بازیابی کامل هم نمیتواند استراتژی بد تکهبندی (Chunking) را جبران کند. این یکی از نادیدهگرفتهشدهترین مشکلات در RAG است. دوباره مثال سیاست استرداد وجه را در نظر بگیرید. سند اصلی ممکن است اینطور باشد: «استرداد وجه ظرف ۳۰ روز ممکن است»، و بلافاصله بعد از آن بیاید: «واجدین شرایط: فقط مشتریان سازمانی»، «شرط: قرارداد باید فعال باشد» و «استثنا: طرحهای سالانه استثنا هستند.»
یک الگوریتم تکهبندی ساده ممکن است اینها را به تکههای مختلف تقسیم کند. اگر تکه اول فقط شامل «استرداد وجه ظرف ۳۰ روز ممکن است» باشد، به دلیل شباهت بالا به سؤال کاربر، رتبه اول را میگیرد. اما این تکه کافی نیست. استراتژی تکهبندی در اینجا رابطه بین گزاره و محدودیتهای آن را نابود کرده است. این نقص در ساختار دادهها میتواند منجر به وضعیتی شود که ایندکسهای RAG با وجود اطمینان بالا، پاسخهای غلط ارائه دهند، زیرا مدل تکهای از حقیقت را به جای کل حقیقت دریافت کرده است.
تکهبندی مؤثر باید از نظر معنایی کامل باشد. مرزها باید بر اساس ساختار اطلاعات باشند، نه تعداد توکن ثابت (مثل «تقسیم هر ۵۰۰ توکن»). این امر نیازمند استراتژیهای خاص است:
- مستندات فنی: یک نقطه اتصال (Endpoint) باید همراه با پارامترها و محدودیتهایش باقی بماند.
- اسناد سیاستی: یک قانون باید به استثنائاتش متصل بماند.
- جداول: سرتیتر ستونها برای تفسیر مقادیر باید حفظ شوند.
- مستندات عمومی: عناوین باید زمینهای را فراهم کنند که درک متن زیر آنها ممکن شود.
خطر «زمینه بیشتر»
وقتی بازیابی شکست میخورد، واکنش غریزی توسعهدهندگان افزایش تعداد اسناد ارسالی به LLM است. اگر ۵ تکه کافی نیست، ۱۰ یا ۲۰ تکه میفرستند. در حالی که مدلهای مدرن پنجرههای متنی عظیمی دارند، اما ظرفیت با کیفیت یکی نیست.
تصور کنید زمینه نهایی شامل سیاست واقعی استرداد وجه باشد، اما در کنار آن استثنائات طرح سالانه، مستندات پورتال پرداخت، دستورالعملهای صدور فاکتور، اسناد ورود مشتریان سازمانی، اطلاعات تمدید اشتراک و رویههای پشتیبانی مشتریان غیرمرتبط نیز باشد. مدل اکنون اطلاعات بیشتری دارد، اما شواهد بهتر ندارد. این نویز اضافی فرصتهای بیشتری ایجاد میکند تا مدل مفاهیمی را به هم وصل کند که نباید وصل شوند.
یک سامانه قابلاعتماد باید پس از بازرتبهبندی، آستانههای مرتبط بودن را اعمال کند. سؤال مهندسی نباید این باشد که «آیا میتوانم تکه دیگری را در پنجره متنی جای دهم؟»، بلکه باید این باشد که «آیا این تکه به اندازه کافی مفید است تا از یک پاسخ پشتیبانی کند؟»
مدیریت «مجموعه تهی»
خطرناکترین حالت زمانی است که پاسخ در پایگاه دانش وجود ندارد. فرض کنید کاربر بپرسد: «سیاست استرداد وجه ما برای قراردادهای دولتی چیست؟» و پایگاه دانش هیچ اطلاعاتی درباره قراردادهای دولتی نداشته باشد. ابزار بازیابی هیچ چیز مفیدی برنمیگرداند.
یک پیادهسازی خطرناک، این وضعیت را دعوتی به LLM برای پاسخ دادن میداند. چون LLM روی حجم عظیمی از دادههای عمومی آموزش دیده، ممکن است درباره قراردادهای دولتی یا رویههای تجاری عمومی بداند. مدل پاسخی متقاعدکننده تولید میکند، اما سیستم در سکوت از حالت «پاسخ با استفاده از پایگاه دانش ما» به حالت «پاسخ با هر چه میدانی» تغییر وضعیت داده است.
سامانههای عملیاتی به یک مسیر «امتناع صریح» نیاز دارند: نبود شواهد معتبر ← نبود پاسخ. سیستم باید راحت باشد که بگوید: «شواهد کافی برای پاسخ به این سؤال وجود ندارد.» اگرچه این پاسخ کمتر از یک جواب با اعتمادبهنفس، چشمگیر به نظر میرسد، اما از نظر قابلیت اطمینان بسیار بهتر است.
لایه اعتبارسنجی
پس از انتخاب زمینه، پرامپت باید مرز شواهد را به طور واضح مشخص کند: «فقط با استفاده از زمینه ارائهشده پاسخ بده. اگر زمینه از پاسخ پشتیبانی نمیکند، بگو که شواهد کافی وجود ندارد.» این کار تضمین میکند که شواهد بازیابیشده منبع حقیقت هستند و وظیفه LLM صرفاً تفسیر و انتقال آنهاست.
با این حال، LLMها هنوز ممکن است دامنه یک عبارت را اشتباه تفسیر کنند. زمینهای که میگوید «استرداد وجه ظرف ۳۰ روز برای مشتریان سازمانی ممکن است» ممکن است به این صورت خلاصه شود: «همه مشتریان واجد شرایط استرداد وجه ظرف ۳۰ روز هستند.» در اینجا سند بازیابیشده درست بود، اما پاسخ تولید شده غلط بود.
برای جلوگیری از این اتفاق، یک لایه اعتبارسنجی پس از تولید پاسخ ضروری است. ادعاهای تولید شده باید در برابر شواهدی که برای تولید آنها به کار رفتهاند، از طریق روشهای زیر ارزیابی شوند:
- تأیید استناد: اطمینان از اینکه هر ادعا به یک منبع خاص لینک شده است.
- بررسی استلزام: تأیید اینکه پاسخ منطقاً از زمینه استخراج شده و از آن پیروی میکند.
- تولید پاسخ ساختاریافته: محدود کردن آزادی خلاقانه مدل برای جلوگیری از گسترش دامنه (Scope Creep).
عیبیابی خط لوله
توسعهدهندگان باید دست از عیبیابی RAG تنها از طریق پاسخ نهایی بردارند. وقتی «توهم» گزارش میشود، اولین واکنش اغلب تغییر مدل یا بازنویسی پرامپت است. این کار معمولاً خیلی زود انجام میشود. در عوض، بررسی باید طبق یک ردپای دقیق عیبیابی پیش برود:
۱. بازیابی چه چیزی را برگرداند؟
۲. کدام اسناد از بازرتبهبندی عبور کردند و باقی ماندند؟
۳. چه تکههایی در نهایت به LLM رسیدند؟
۴. آیا اطلاعات کامل بود یا شرایط مهم حذف شده بودند؟
۵. کدام ادعای خاص در پاسخ توسط شواهد بازیابیشده پشتیبانی نمیشود؟
این رویکرد، یک «مشکل مبهم هوش مصنوعی» را به یک «شکست قابل مشاهده در خط لوله» تبدیل میکند. این به مهندسان اجازه میدهد ببینند آیا مشکل مربوط به فراخوانی ضعیف (Poor Recall)، خطای رتبهبندی، اشتباه در تکهبندی (که قانون را از استثنا جدا کرده) یا شکست در امتناع از پاسخ در زمان نبود شواهد بوده است.
این تغییر معماری به این معناست که سؤال اصلی مهندسی دیگر این نیست که «چگونه مدل را بیشتر بدانم؟»، بلکه این است که «چگونه تضمین کنم مدل قبل از پاسخ دادن، شواهد درست را در اختیار دارد؟»
RAG به عنوان یک سامانه اطلاعاتی
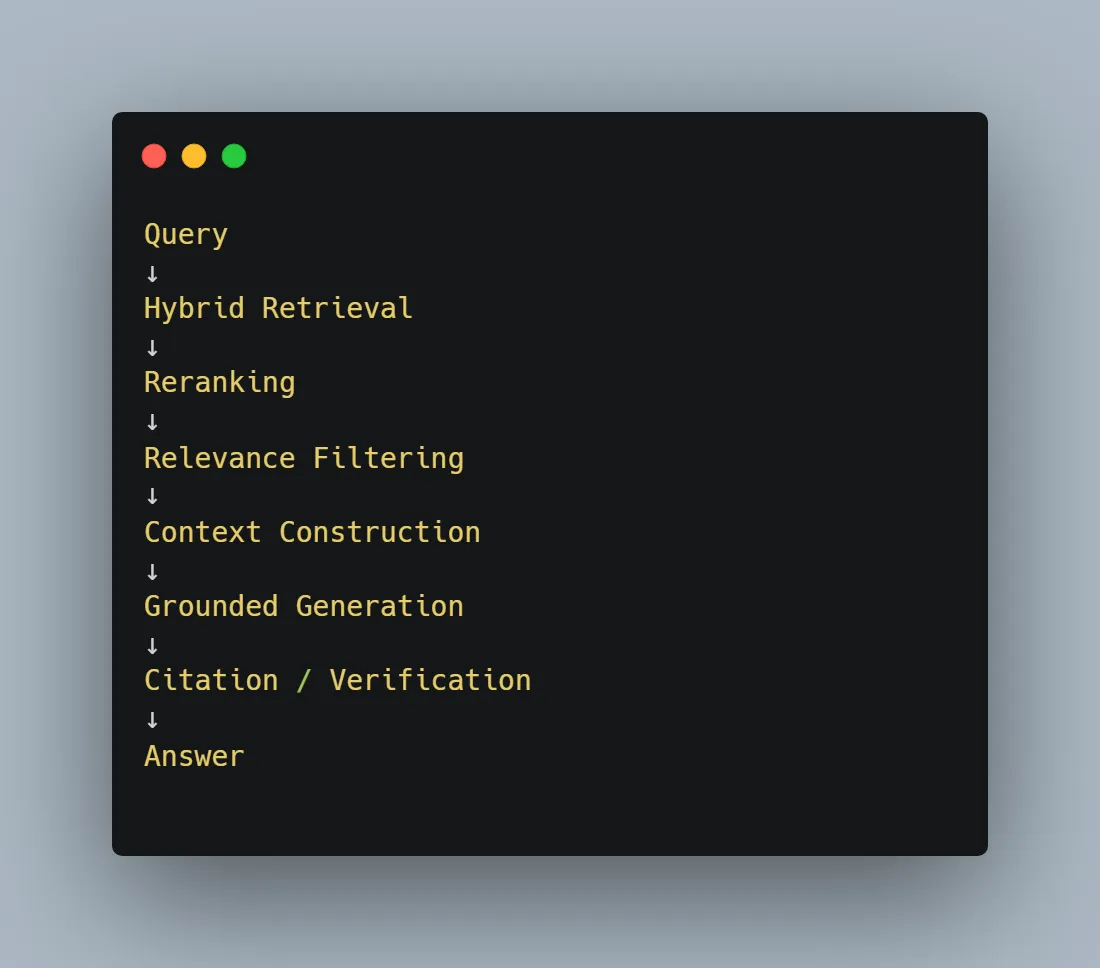
برای یک دمو، مدل ذهنی «پایگاهداده برداری + LLM» کافی است. اما برای تولید، یک معماری قابلاعتماد به این شکل است: پرسش ← بازیابی ← بازرتبهبندی ← فیلتر کردن ← ساخت زمینه ← تولید ← اعتبارسنجی ← پاسخ.
هر مرحله مسئولیت متفاوتی دارد و حالت شکست متفاوتی را تجربه میکند. اگر بازیابی شکست بخورد، تولید با شواهد بد شروع میشود. اگر تکهبندی شکست بخورد، زمینه ناپدید میشود. اگر بازرتبهبندی شکست بخورد، نویز به مدل میرسد. اگر اعتبارسنجی غایب باشد، ادعاهای بدون پشتوانه به کاربر میرسد. بسیاری از مشکلات توهم، مشکل مدل نیستند، بلکه مشکل سیستم هستند. مدل همیشه به دلیل ندانستن پاسخ توهم نمیزند؛ اغلب به این دلیل توهم میزند که سیستم پاسخی ناقص به او داده و از او خواسته است شکافها را پر کند.
گام بعدی شما
- به جای افزایش تعداد تکههای ارسالی به مدل، یک لایه بازرتبهبندی (Reranking) اضافه کنید تا نویز کاهش یابد.
- استراتژی تکهبندی خود را از «تعداد توکن ثابت» به «تکهبندی معنایی» بر اساس ساختار سند تغییر دهید.
- یک مسیر «امتناع از پاسخ» (Abstention Path) تعریف کنید تا مدل در صورت نبود شواهد، از تخیل پرهیز کند.
اما داستان سختافزاری این تحول حتی شگفتانگیزتر است — به تحلیل ما دربارهی تراشههای Blackwell مراجعه کنید.



گفتگو