تصور کنید سیستمی ساختهاید که خودش را چک میکند، اما وقتی اشتباهی میکند، با اطمینان کامل آن را میپذیرد. اگر امروز برای مدیریت خطاهای عاملهای خود تنها به دستورات «دوباره بررسی کن» تکیه کردهاید، باید بدانید که این روش در لحظهی وقوع خطا، کاملاً ناکارآمد است.
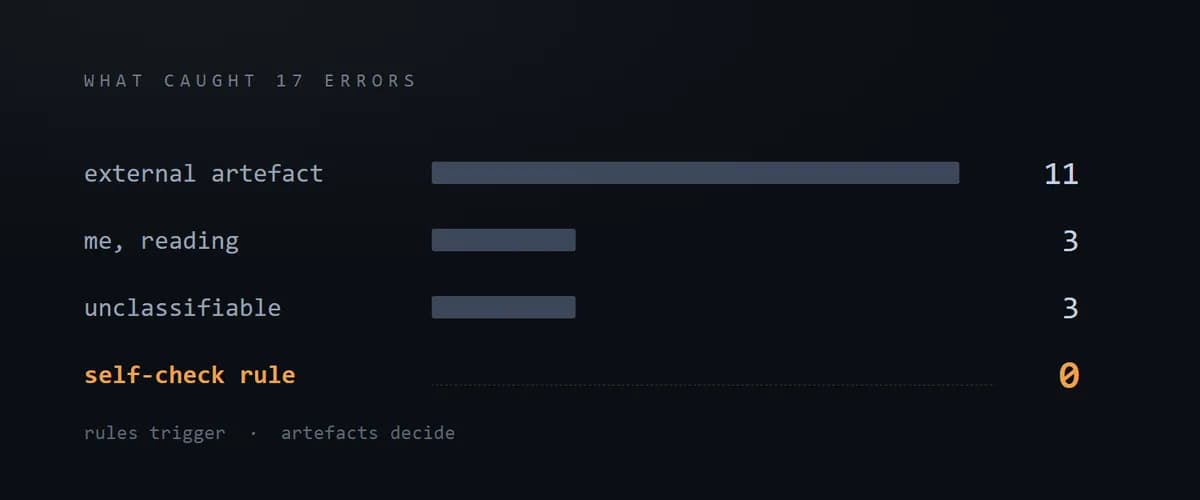
یک بازرسی فنی روی ۱۷ خطای ردیابیشده در یک پروژهی چهارماههی توسعه، ثابت میکند که قواعد خودتصحیحی نمیتوانند خطایی را که پیش از این ثبت شده است، تشخیص دهند. این بازرسی با بررسی یک دفتر ثبت شمارهگذاری شده از خطاها انجام شد. طبق مستندات این پروژه، هیچیک از ۱۱ قانون داخلی — از جمله «بدون اندازهگیری چیزی ادعا نکن»، «برای آنچه گم شده است جستوجو کن» و «هرگز از حافظه پنهان شروع نکن» — نتوانستند خطایی را پس از وقوع عملیات شناسایی کنند. این یافته نشان میدهد که قابلیت اطمینان یک عامل (Agent) — یا همان برنامهای که میتواند بهطور مستقل هدف را پیش بگیرد و ابزارها را اجرا کند — بهطور کامل به محدودیتهایی وابسته است که خارج از دسترس خودِ عامل قرار دارند.

نتایج تکاندهنده بود. در این ۱۷ مورد، برخی خطاها از طریق یک اثر خارجی (مانند هش (Hash)، شمارنده، دیف (Diff) یا گارد اعتبارسنجی) شناسایی شدند، برخی توسط توسعهدهنده که خروجی را میخواند و برخی توسط قوانینی که از عامل میخواست خودش را تأیید کند. اما نکته کلیدی این است که هیچکدام از آن ۱۱ قانون داخلی، هرگز نتوانستند خطایی را «پس از وقوع» شکار کنند. این موضوع یک تمایز حیاتی را روشن میکند: دفتر ثبت خطاها تنها خطاهای ردیابیشده در یک بازه زمانی دو هفتهای را پوشش میدهد — که شامل خطاهای قدیمیتر شناسایی شده در یک بازرسی جامع (Corpus Audit) نیز میشد — و نه کل تاریخچه پروژه را. این چالش با الگوهای شکستی که در آزمونهای هوش مصنوعی با چراغ سبز تایید میشوند همسویی دارد، جایی که سیستمهای نظارتی خودشان دچار توهم موفقیت میشوند.
همانطور که در تحلیلهای قبلی ما دربارهی امنیت مدلهای بازمتن اشاره کردیم، تکیه بر لایههای نرمافزاری داخلی برای ایمنی، اغلب یک توهم است. اکثر چارچوبهای فعلی بر محدود کردن «عمل» (Action-bounding) تمرکز دارند اما «اعتبارسنجی» (Assertion-bounding) را نادیده میگیرند. وقتی یک عامل جملهای غلط در یک فایل README مینویسد، این اتفاق هیچ سقف هزینهای یا مکانیزم توقفی (Fail-closed) را فعال نمیکند. چون اسناد عمومی عمدتاً توصیفی هستند، تبدیل به یک سطح حملهی عظیم و بدون ابزار نظارتی شدهاند. توسعهدهندهی این پروژه اشاره کرد که دو مورد از بدترین خطاهای ماه اخیر، صرفاً جملاتی ساده بودند؛ آنها هیچ هزینهای نداشتند و هیچ محدودیتی را رد نکردند، اما ۷ ساعت و ۳۳ دقیقه در یک صفحه عمومی باقی ماندند.
شکاف میان امر مادی و امر توصیفی
برای درک این ریسک، باید به معماری خاص این پروژه نگاه کرد. این سیستم از دو عامل کیوریتور استفاده میکند که آثار هنری را ارزیابی میکنند، علیه یکدیگر قیمت پیشنهادی (Bid) میدهند و تراکنشها را روی یک زنجیره عمومی (بهطور مشخص Base Sepolia، قرارداد 0x471796C1644d87f30AD81D36f6d4A56f0e270c23) تسویه میکنند.
- بخش مادی: مربوط به جابجایی ارزش است. عامل در این بخش آزادانه مذاکره میکند (مثلاً در یک دوئل، ده پیشنهاد را بهصورت خارجزنجیرهای رد و بدل میکند)، اما هر گامی که منجر به جابجایی دارایی شود، به امضای انسانی از دستگاهی نیاز دارد که عامل به آن دسترسی ندارد. این همان بخشی است که اکثر الگوهای امنیتی برای آن نوشته شدهاند.
- بخش توصیفی: مربوط به آنچه عامل در اسناد عمومی میگوید است. در اینجا هیچ مکانیزم توقف خودکاری وجود ندارد.
هر دو بخش از یک اصل پیروی میکنند: محدودیت باید خارج از عامل باشد. شما یک عامل را «قابل اعتماد» نمیکنید؛ بلکه کاری میکنید که او بهتنهایی «قادر به آسیب رساندن» نباشد. در این راستا، ریسکهای مربوط به خروجیهای غیرمنتظره میتواند مشابه نشت دادههای حساس از طریق زنجیره تفکر باشد، جایی که کنترل بر لایههای داخلی مدل کافی نیست.
اندازهگیری نیمهی نامرئی
یک دفتر ثبت خطا بهطور طبیعی سوگیرانه است، زیرا قانونی که مانع وقوع خطا شود، هیچ ردی از خود به جا نمیگذارد. هیچ خطی در لاگ برای جملهای که هرگز نوشته نشده است، وجود ندارد. برای اندازهگیری این «نیمهی نامرئی»، توسعهدهنده «اتفاقات نزدیک به خطا» (Near-misses) را ردیابی کرد؛ یعنی رویدادهایی که در آن خطا در شرف وقوع بود اما متوقف شد. در یک جلسه مداوم ۳۰ ساعته و ۴۳ دقیقهای با یک متن کامل (Transcript)، ۹ مورد از این پیشگیریها رخ داد.
تحلیل اتفاقات نزدیک به خطا
دادهها تفکیکی دقیق بین «محرک» و «داور» را نشان میدهند. عملکرد این ۹ پیشگیری به این صورت بود:
- بازنویسی آینهای: عاملی سعی داشت ورودی لاگی بنویسد که در همگامسازی بعدی پاک میشد؛ این مورد از طریق مقایسه فایل اصلی (Canonical) با اثر آینهایاش (Mirror Artefact) متوقف شد.
- لنگرهای موقعیتی: تلاش برای نوشتن در لاگی که ۷ مورد از ۱۲ لنگر موقعیتش غلط بود، توسط یک گارد اعتبارسنجی (Assertion Guard) متوقف شد که از نوشتن امتناع کرد و در نتیجه هیچ خروجی جزئی تولید نشد.
- خطاهای اجرا: وقتی ابزاری با کد خروجی غیرصفر شکست خورد، عامل کد را بهصورت ایزوله دوباره اندازهگیری کرد و فهمید مشکل از دستور پوششی (Wrapping Command) است.
- اثباتیهای حساس به زمان: یک ثبت اصلاحیه با بند اثباتی حساس به زمان، ابتدا زمانی که یک پرسش درباره محدوده (Scope) پیش از نوشتن پرسیده شد (خودارزیابی) و سپس با دخالت انسانی شکار شد.
- نشانهگذاری شکسته: ثبت یک مارکآپ خراب در سند اصلی، فقط با بازخوانی ساده متوقف شد، زیرا هیچ گاردی برای این مورد خاص وجود نداشت.
- شکست در جستوجو: عاملی نتیجه گرفت عبارتی هرگز ارسال نشده است، زیرا جستوجوی او خالی بود. قانونی که او را مجبور کرد پاسخی را بر اساس جواب خودش جستوجو کند، نشان داد عبارت بهدلیل یک شکست خط (Line break) تکهتکه شده بود و این منجر به اندازهگیری مجدد شد.
- ویرایشهای یکسان: ویرایشی که در آن متن قدیم و جدید یکسان بود، از طریق بازخوانی شناسایی شد و سپس به یک بررسی مکانیکی منجر گشت.
- عدم تطبیق فایل: تلاش برای ارسال فایلی که خارج از جلسه بود، بهدلیل عدم تطبیق تعداد (انتظار ۷ فایل بود اما ۶ فایل شناسایی شد) متوقف شد.
- ناهمزمانیهای زمانی: انتشار دو مورد ناهمزمانی (بهروزرسانی شمارندهها در جملاتی که وضعیت قبلی را توصیف میکردند) از طریق بررسی ارجاعات تاریخدار و تاریخ ایجاد قوانین توسط یک ابزار خارجی شکار شد.
مکانیسم پیشگیری
این دادهها این فرضیه را که «ابزارهای خارجی فقط شکار میکنند و خودارزیابیها فقط پیشگیری میکنند»، رد میکند. در عوض، یک تفکیک عملکردی متفاوت را آشکار میکند:
- ابزارها بهعنوان داور: ۷ مورد از ۹ اتفاق نزدیک به خطا توسط یک ابزار مکانیکی یا انسان فیصله یافت. ابزار خارجی (Artefact) همیشه داور است.
- قوانین بهعنوان محرک: قواعد خودارزیابی (Self-check) بهطور مداوم بهعنوان محرک عمل میکنند. آنها باعث میشوند عامل نوشتن را متوقف کرده و برود «اندازهگیری» کند، اما هرگز خودشان پاسخ نهایی را نمیدهند.
- تلهی بازتاب (Reflection): الگوی بازتاب — یعنی وقتی عاملی خروجی خودش را نقد میکند — یک محرک است، نه داور. این کار فقط یک «نظر دوم» تولید میکند، نه یک «تأییدیه». رد کردن یک ادعا نیازمند یک نمونه ابزارگذاری شده است که به اندازهگیریهایی دسترسی داشته باشد که نمونه اول مدل فاقد آنها بود.
شکستهای بحرانی در آزمایشگاه
دو مورد خاص نشان میدهد که مجموعهای از قوانین، خود متنی هستند و بنابراین در معرض آسیب معرفتی (Epistemic Damage) قرار دارند. در یک مورد، قانونی که از یک محیط به محیط دیگر منتقل شده بود، به یک ممنوعیت تبدیل شد که هیچکس ننوشته بود، اما یک روز کامل اجرا شد.
در موردی آموزندهتر، متنی که درباره تئوری استفاده از شمارندهها بحث میکرد، خودش در جدول نتایجش خطای شمارشی داشت! این خطا توسط یک شمارنده مکانیکی شکار شد. شمارنده فایل را در خط ۸۸ — دقیقاً در بخش سرتیتر سند که تئوری شمارندهها را میگفت — رد کرد. این ثابت میکند که فرموله کردن یک الگوی خطا در متن، از وقوع آن جلوگیری نمیکند؛ تنها «ابزارگذاری» (Instrumentation) آن است که اثر دارد. چنین شکستهایی در مقیاس بالا، یادآور سازوکارهای پنهانسازی شکستها در عاملهای کدنویسی است، جایی که بدون تستهای تصادفی، خطاها زیر لایهای از تاییدات کاذب پنهان میمانند.
در اینجا یک عدم تقارن شدید در هزینه وجود دارد. نوشتن یک قانون چند دقیقه زمان میبرد، اما ساختن یک داور مکانیکی متناظر، یک ساعت زمان میبرد. این منجر به یک پسانداز خطرناک میشود: قانونی بدون داور، هیچچیز را شکار نمیکند و زمانی که در ابتدا ذخیره شده، توسط انسانی که باید خروجی را دستی بخواند و تأیید کند، با بهرهی مرکب بازپرداخت میشود.
استراتژی پیادهسازی برای توسعهدهندگان عامل
بر اساس این یافتهها، توسعهدهندگان باید سه تغییر اساسی در جریان کاری خود ایجاد کنند:
- مدل تهدید اول: پیش از لیست کردن الگوها، مدل تهدید را بنویسید. اکثر طبقهبندیهای منتشر شده، الگوها را بدون ذکر اینکه از چه چیزی محافظت میکنند لیست میکنند و این باعث میشود دانستن اینکه کدام الگو واقعاً لازم است، غیرممکن شود.
- ابزارگذاری اعتبارسنجیها: نه فقط عملها، بلکه اعتبارسنجیها را محدود کنید. اگر یک عامل در یک رکورد عمومی ادعایی میکند، آن ادعا باید یک مسیر تأیید مکانیکی داشته باشد.
- تفکیک محرک از داور: هر قانون را بهعنوان یک محرک در نظر بگیرید و داور آن را بهصورت مجزا بسازید. اگر یک محدودیت تنها به این دلیل برآورده شده که عامل «تصمیم گرفته» برآورده شده است، در لحظهای که بیشترین اهمیت را دارد، شکست خواهد خورد. قوانین را با خروجیهای قابل خواندن جفت کنید: یک شمارنده، یک هش، یک دیف یا یک کد خروج (Exit Code).
در نهایت، هدف انتقال از «مهندسی پرامپت برای ایمنی» به «زیرساخت برای تأیید» است. این تغییر مسیر، عبور از جستوجوی یک عامل هوشمندتر به سمت ایجاد یک داور خارجی سختگیرتر است.
اما هزینه استنتاج این مدلهای نظارتی چقدر است؟ در تحلیل ما دربارهی بهینهسازی هزینه استنتاج و استفاده از مدلهای کوچکتر، به این موضوع پرداختهایم.



گفتگو